Claude Opus 5.5 — флагманская модель Anthropic, вышедшая 22 сентября 2026 года, и главный вывод обзора такой: по данным Anthropic, она сильнее Opus 5 во всех девяти тестах анонса, а на типичных задачах обходится примерно на 40% дешевле неё. Это первая модель нового семейства Claude 5.5 и прямая преемница Claude Opus 5; по оценке разработчика, на большинстве задач она работает на уровне Claude Fable 5.1.
В СуперИнтеллекте Claude Opus 5.5 появилась в день выхода и доступна с тарифа Про — в России, без VPN и зарубежной карты. Ниже — характеристики, бенчмарки с условиями замеров, экономичность, безопасность, ограничения и кому модель подойдёт.
Что такое Claude Opus 5.5 и чем она особенная?
Claude Opus 5.5 — старшая модель линейки Claude 5.5, которая, по оценке Anthropic, выходит на уровень Fable 5.1 на большинстве задач, но при этом дешевле и быстрее своей предшественницы Opus 5. Младшие модели семейства — Sonnet 5.5 и Haiku 5.5 — Anthropic обещает в ближайшие недели, так что пока поколение 5.5 представлено только Opus.
Особенной модель делают три вещи:
- Скачок в агентной работе — там, где модель сама выполняет длинную цепочку шагов: в Terminal-Bench 4.0 у неё 66,4% против 52,3% у Opus 5.
- Экономность — меньше токенов на задачу при более дешёвом токене.
- Другой стиль письма — вместо многословия Opus 5 ответы, которые начинаются с сути.
Какие характеристики у Claude Opus 5.5?
Claude Opus 5.5 принимает до 1 000 000 токенов контекста и отвечает объёмом до 128 000 токенов; на вход идут текст, изображения и файлы, на выходе — текст.
| Параметр | Значение |
|---|---|
| Разработчик | Anthropic |
| Дата выхода | 22 сентября 2026 года |
| Семейство | Claude 5.5 — первая модель; Sonnet 5.5 и Haiku 5.5 обещаны в ближайшие недели |
| Контекстное окно | 1 000 000 токенов |
| Максимальный ответ | 128 000 токенов |
| Что принимает | текст, изображения, файлы |
| Что выдаёт | текст |
| Уровни усилий | low, medium, high, xhigh, max |
| Уровень по умолчанию | medium у Anthropic; в СуперИнтеллекте выбирается в чате |
| Скорость | генерирует ответ более чем на 30% быстрее Opus 5 |
| Ускоренный режим Fast | только в продуктах Anthropic; в СуперИнтеллекте его нет |
| В СуперИнтеллекте | с тарифа Про; в каталоге — «Claude Opus 5.5» и псевдоним «Claude Opus Latest» |
Миллиона токенов хватает, чтобы загрузить в один запрос крупную кодовую базу или пачку договоров целиком, а длинный ответ позволяет получить большой документ или объёмную правку кода за один проход.
Что такое уровни усилий и какой выбрать?
Уровень усилий определяет, сколько модель рассуждает перед ответом: на low она отвечает быстро и экономно, на max думает дольше всего и тратит больше токенов. У Anthropic по умолчанию стоит medium, в СуперИнтеллекте уровень выбирается прямо в чате.
Важная деталь: у Opus 5.5 сильны даже нижние уровни. Deloitte сообщает, что на самом низком уровне модель нашла при ревью кода 72% известных багов — против 56% у Opus 5 на высоком. Rogo на самом низком уровне обошла Opus 5 на высоком примерно с 60% меньшим числом выходных токенов, а Factory называет Opus 5.5 первой моделью, которую готова по умолчанию ставить на medium. Как подбирать уровень под задачу — в гайде как пользоваться Claude Opus 5.5.
Что показывают бенчмарки Claude Opus 5.5?
По данным Anthropic, Claude Opus 5.5 опережает Opus 5 и Fable 5.1 во всех девяти тестах анонса и держит лучший результат в таблице везде, кроме двух тестов, где впереди GPT-6 Astra.
| Тест | Что проверяет | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | агентное программирование в терминале | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1 (Main) | агентное программирование | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
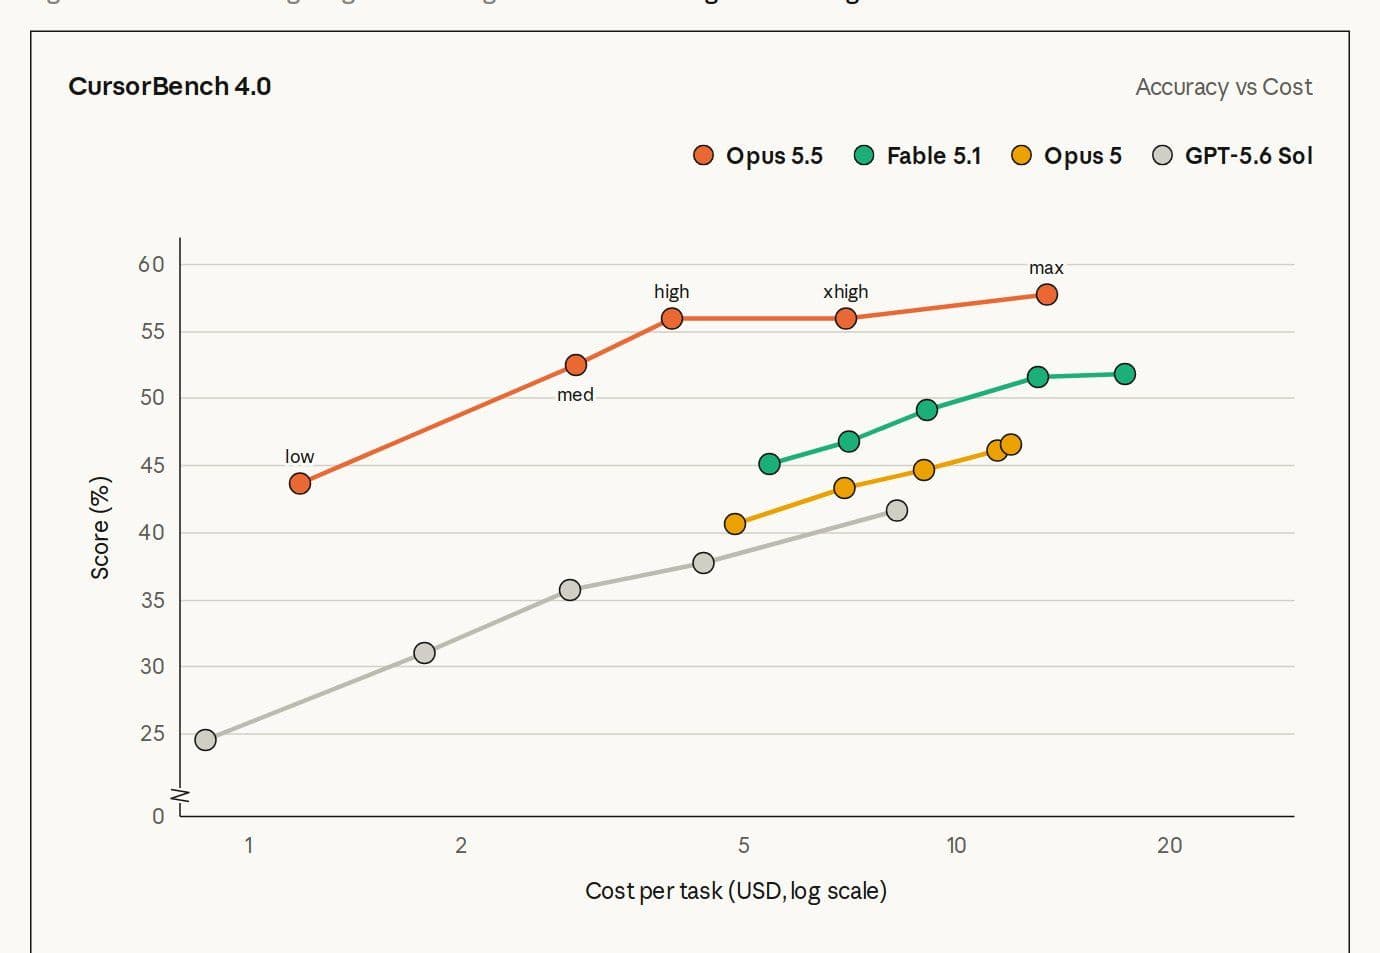
| CursorBench 4.0 | работа в редакторе кода | 57,8% | 51,8% | 46,6% | — | 41,7% |
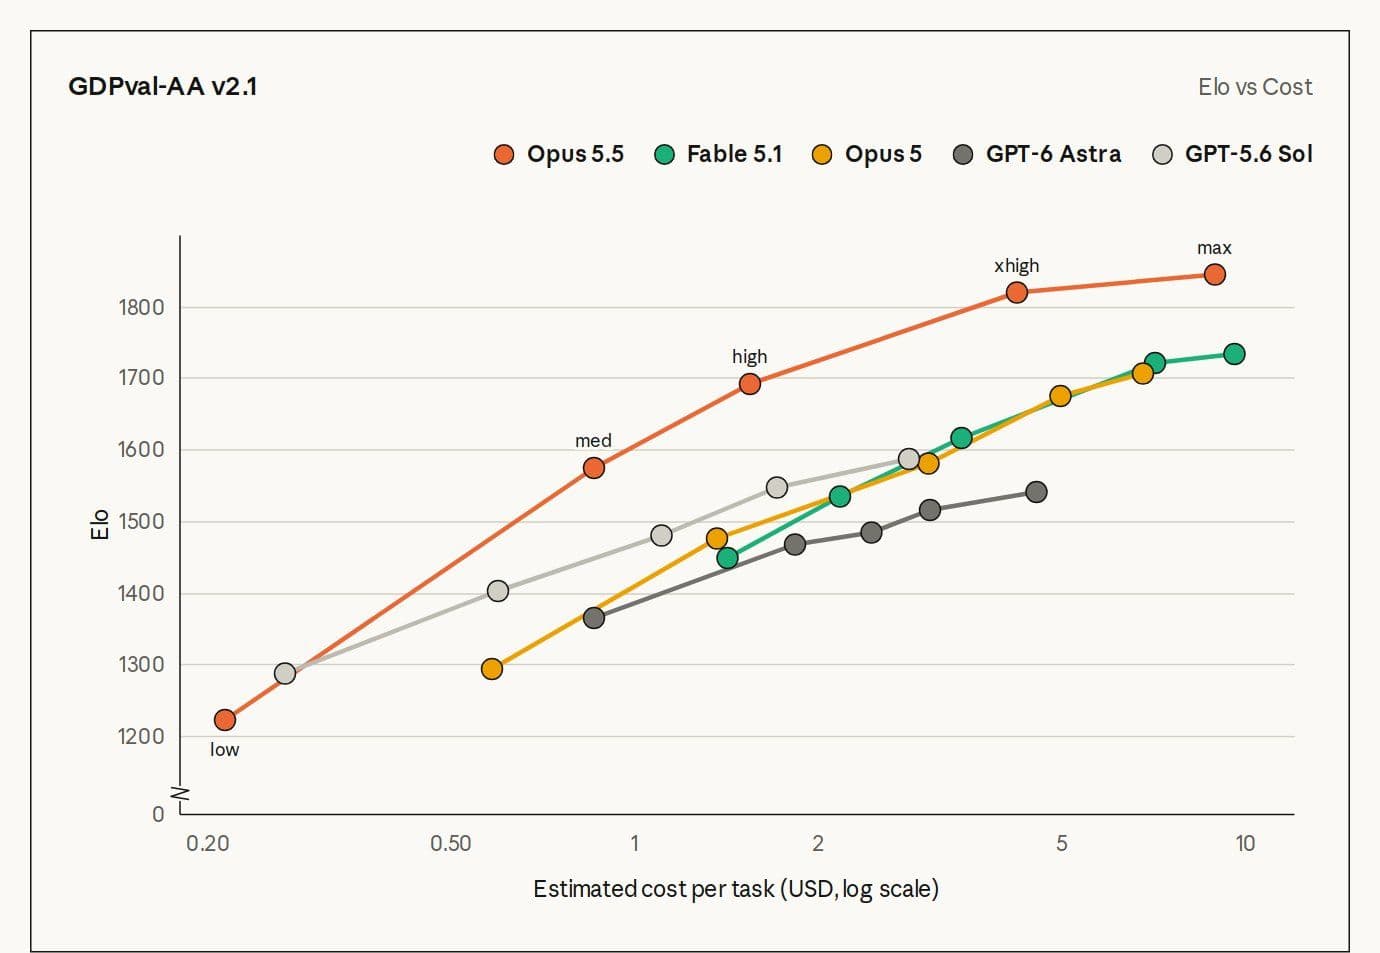
| GDPval-AA v2.1 | офисная работа в 44 профессиях, Elo | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | бизнес-автоматизации | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Humanity's Last Exam | междисциплинарные рассуждения, с инструментами | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Terminal-Bench-Science 0.1 | научные задачи в терминале | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| OSWorld 2.0 | управление компьютером | 81,8% | 80,7% | 74,0% | — | — |
| Chartography | распознавание графиков, с инструментами | 89,0% | 88,4% | 83,4% | — | — |
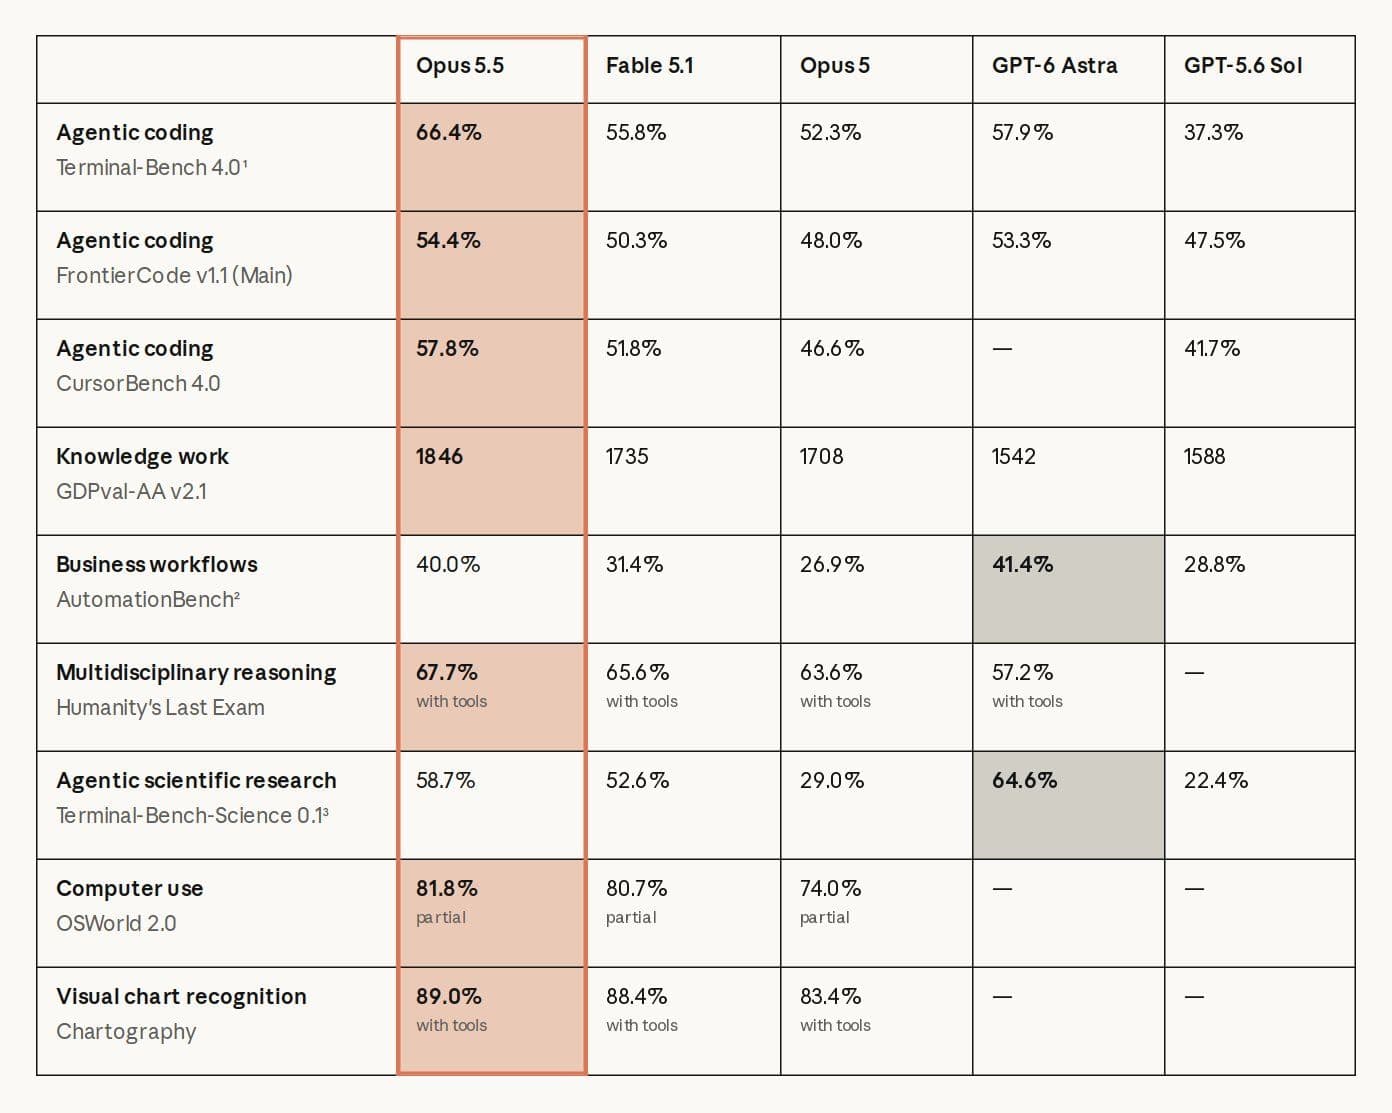
Где впереди GPT-6 Astra. В AutomationBench (бизнес-автоматизации) у GPT-6 Astra 41,4% против 40,0% у Opus 5.5 — разница небольшая, но не в пользу Claude. В Terminal-Bench-Science (научные задачи в терминале) отрыв заметнее: 64,6% против 58,7%. Кроме того, для CursorBench, OSWorld 2.0 и Chartography результатов GPT-6 Astra в таблице нет, так что сравнение с ней неполное. Подробный разбор — в статье Claude Opus 5.5 против GPT-6 Astra.
Оговорку делает и сама Anthropic: на таком уровне разница в баллах всё хуже передаёт разницу в реальной работе. По её собственному опыту использования, Fable 5.1 отстаёт от Opus 5.5 меньше, чем следует из таблицы. Тесты — ориентир, решение стоит принимать на своих задачах.
Насколько Claude Opus 5.5 экономичнее и быстрее Opus 5?
По данным Anthropic, при настройках по умолчанию Claude Opus 5.5 обходится на типичных задачах примерно на 40% дешевле Opus 5 и генерирует ответ более чем на 30% быстрее. Экономия складывается из двух частей:
- меньше токенов на задачу — модель приходит к результату за меньшее число шагов и короче рассуждает;
- дешевле сам токен — базовая цена у Anthropic на 20% ниже, чем у Opus 5, а чтение из кэша — на 60% ниже.
В сравнении с конкурентами Anthropic приводит такие соотношения качества и стоимости:
- FrontierCode: на уровне по умолчанию Opus 5.5 обходит GPT-6 Astra примерно за 20% её стоимости на задачу;
- Terminal-Bench 4.0: догоняет GPT-6 Astra примерно за 40% стоимости, а на уровне по умолчанию обходит Opus 5 на максимальном уровне примерно за пятую часть стоимости;
- CursorBench: обходит GPT-5.6 Sol примерно за треть её стоимости;
- GDPval-AA: на medium обходит GPT-6 Astra на максимальном уровне примерно за пятую часть стоимости задачи.
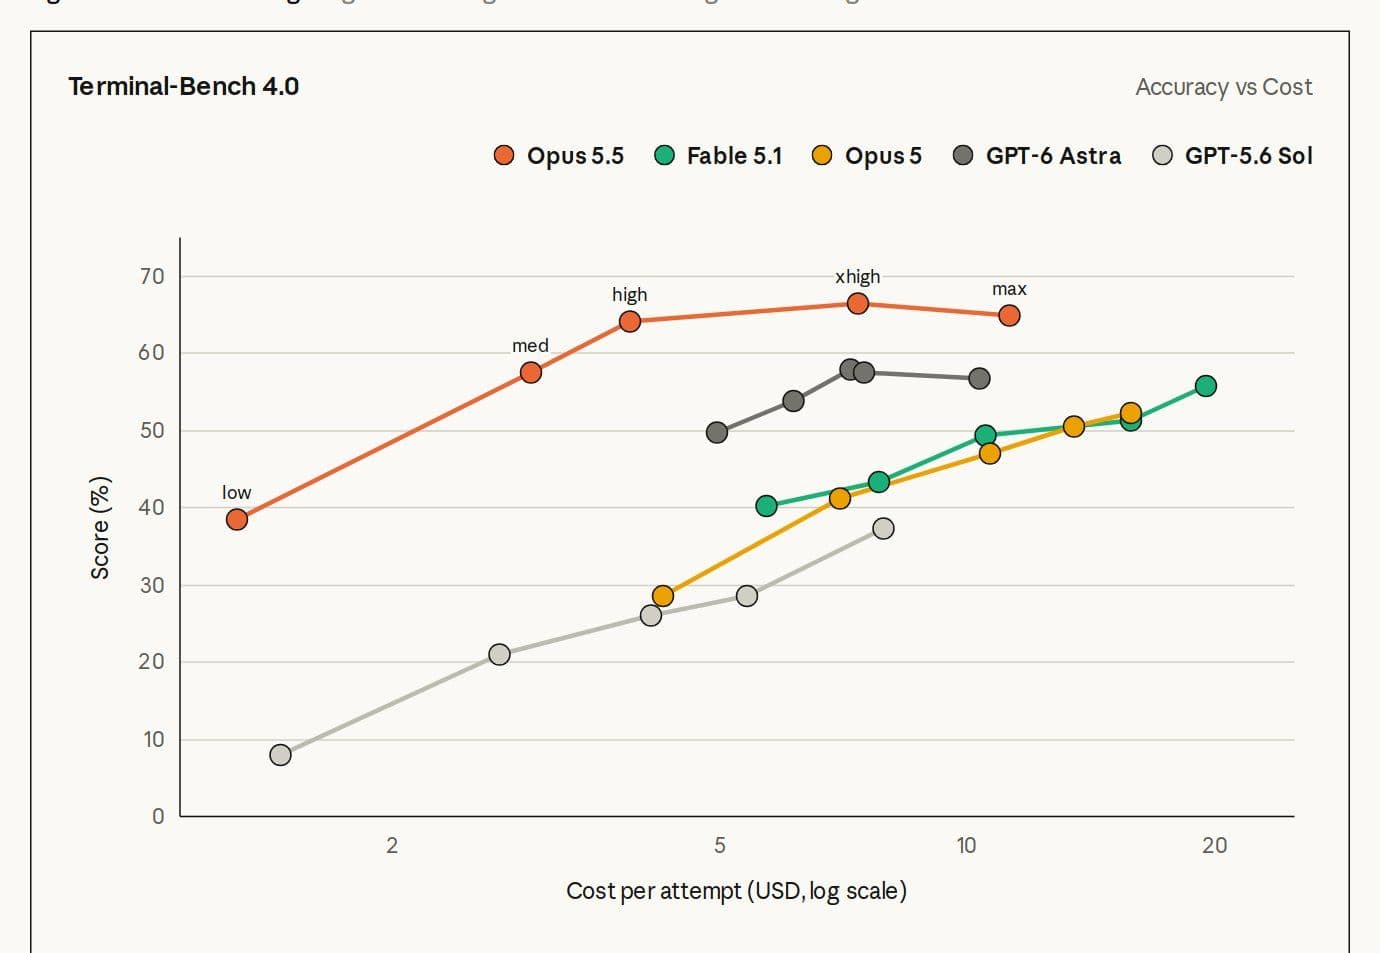
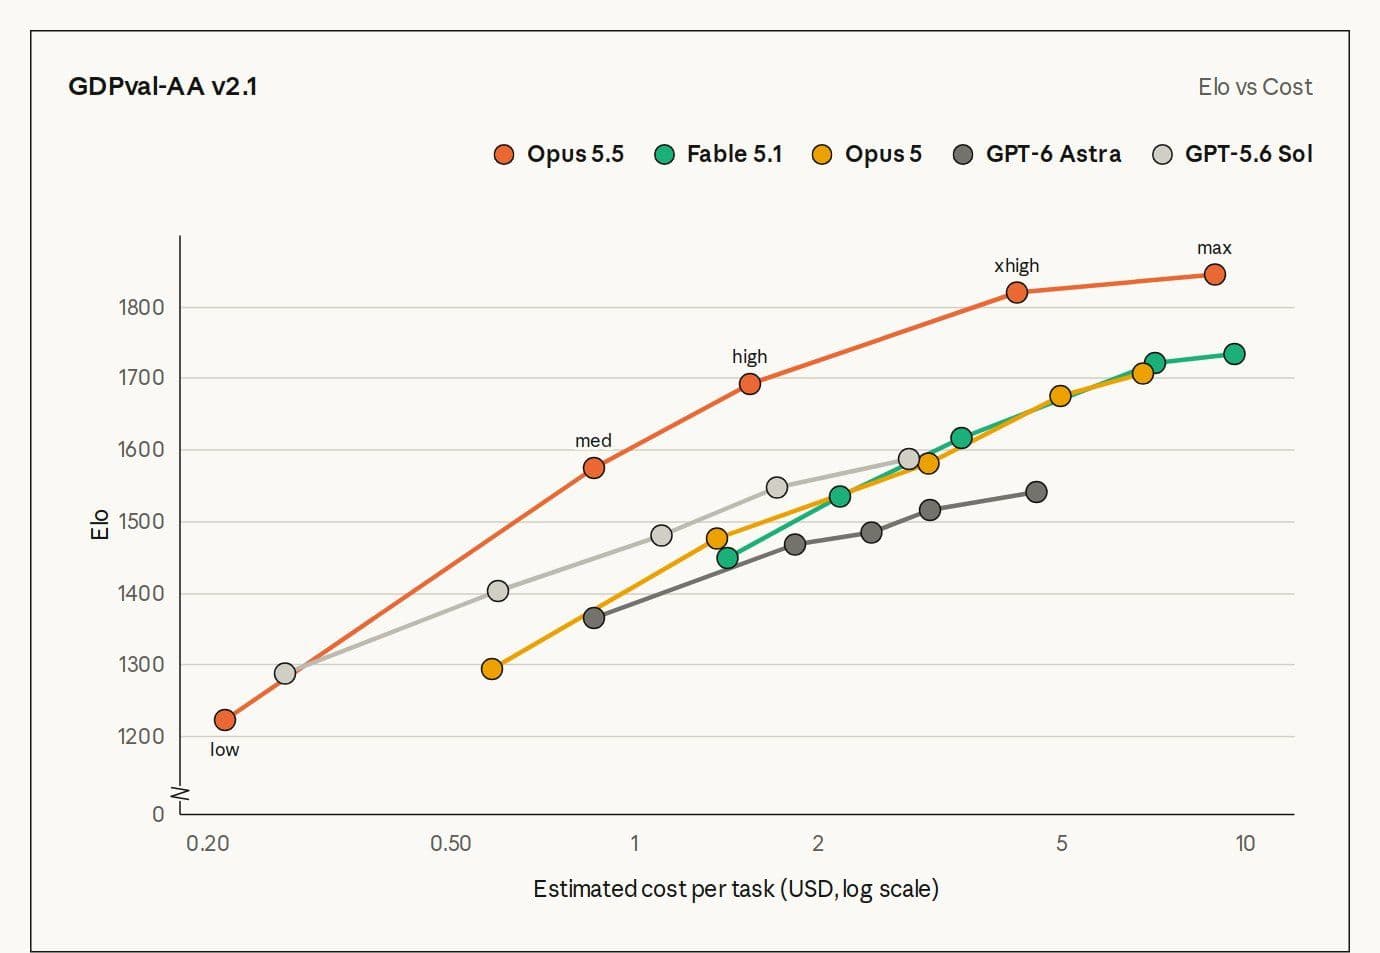
Ранние пользователи видят ту же картину: Optiver получила качество Opus 5 примерно за половину ходов, времени и токенов и снизила стоимость этой нагрузки на 40–50%, а у Box модель потратила треть токенов Opus 5 без потери точности.
Что это значит в СуперИнтеллекте. Нейроны списываются по числу токенов, поэтому экономность Opus 5.5 напрямую превращается в меньший расход нейронов на ту же задачу. Ускоренного режима Fast в СуперИнтеллекте нет — он работает только в продуктах Anthropic; обычный режим и без него более чем на 30% быстрее Opus 5.
В чём Claude Opus 5.5 сильнее всего?
Сильнее всего Claude Opus 5.5 в четырёх направлениях: программирование, аналитика и офисная работа, длинные агентные задачи и деловое письмо.
Программирование
В программировании у Opus 5.5 лучшие опубликованные результаты сразу в трёх тестах: Terminal-Bench 4.0 — 66,4%, FrontierCode — 54,4%, CursorBench — 57,8%. Примеры из анонса: ранний тестировщик провёл миграцию кода на 680 000 строк быстрее чем за сутки; аудит и исправление кодовой базы на 200 000 строк заняли меньше трёх часов — у Opus 5 на то же ушло больше 20 часов и в 2,5 раза больше токенов. В задаче ускорить загрузку всех страниц веб-приложения модель справилась 39 раз из 40, тогда как Opus 5 добивалась меньших улучшений и попутно меняла поведение приложения. А при переводе балансировщика нагрузки HAProxy с C на Rust обе модели прошли почти все регрессионные тесты, но Opus 5.5 уложилась в 9,5 часа против 12 у Fable 5.1 и обошлась на 51% дешевле.
Ранние пользователи говорят о том же, только своими цифрами. GitHub отмечает в Copilot CLI и VS Code одни из самых малых объёмов токенов и шагов: в VS Code модель решила больше терминальных задач, чем Opus 5, менее чем за половину шагов. Lovable собирает результат за треть–половину прежних шагов при том же качестве. Quantium уложила задачу, прежде занимавшую 38 промптов за четыре дня, в 11 промптов за три часа. Kiro на публичном бенчмарке решила больше задач, чем Opus 5, примерно с 40% меньшим числом вызовов и половиной токенов. Сценарии и промпты — в гайде Claude Opus 5.5 для программирования.
Аналитика и офисная работа
В офисных задачах 44 профессий (GDPval-AA) у Opus 5.5 рейтинг 1846 Elo — выше всех в сравнении. Но для аналитика важнее другое: в задаче собрать отчёт о квартальных результатах компании по архивной копии интернета, где нужный пресс-релиз трудно найти, 16 из 18 отчётов Opus 5.5 прошли проверку без единой выдуманной цифры или цитаты — у Fable 5.1 и Opus 5 таких не оказалось ни одного.
В разборе слияния двух вымышленных HR-компаний модель собрала расчёт в Excel и презентацию за 63 минуты против 93 у Opus 5 и вдвое дешевле: выводы у обеих совпали, но у Opus 5.5 расчёт оказался тщательнее, а презентация понятнее, тогда как у Opus 5 нашлись мелкие ошибки. Hebbia насчитала в сквозных финансовых процессах 86,6% выполненных требований против 60,3% у Opus 5. В Walleye Capital модель на самом низком уровне усилий в основном решила их набор задач, а на высоких заметила ошибку в самих инструкциях и учла её. Лидирует Opus 5.5 и в сборе больших объёмов данных — в бенчмарке WANDR. Подробнее — в гайде Claude Opus 5.5 для аналитики.
Длинные агентные задачи
Opus 5.5 держит длинные задачи без присмотра и лучше распределяет работу между субагентами — вспомогательными запусками модели, которым она сама раздаёт подзадачи; в управлении компьютером (OSWorld 2.0) у неё 81,8%. У Clio модель больше 18 часов без присмотра вела большую задачу в шести репозиториях, быстрее проходила этапы, почти не требовала переделок и оставляла короткие полезные комментарии. У Stripe одна сессия управляла ещё дюжиной и довела до автоматической проверки (CI) 40 связанных запросов на слияние. А Column отмечает, что модель заметно лучше делегирует субагентам, — и нашла в облачном счёте экономию, которую прежние модели пропускали.
Стиль письма
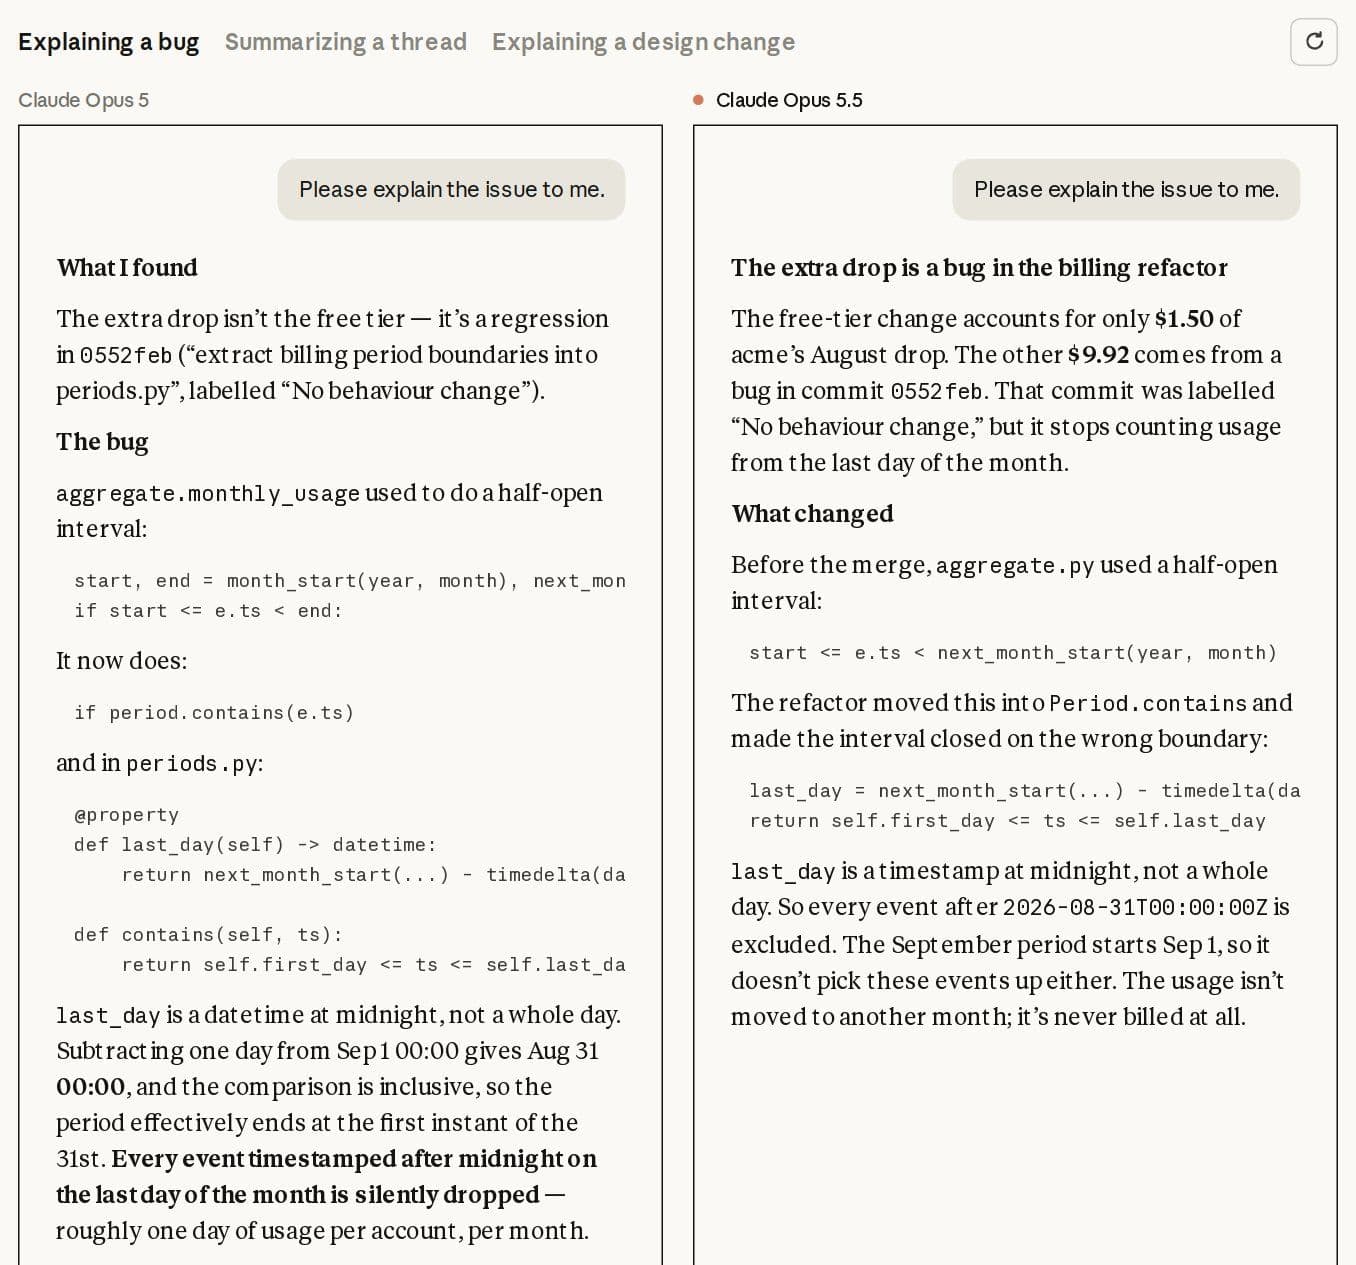
Главной претензией к Opus 5 была многословность. Opus 5.5 пишет короче и понятнее: выносит главное в начало, реже использует жаргон и странные обороты и соблюдает заданные правила письма. Anthropic показала это на трёх парах ответов — объяснение бага, пересказ рабочей переписки и объяснение изменения в дизайне, а Ramp отмечает, что модель пишет как хороший коллега и следует правилам письма команды. Примеры до и после — в статье как пишет Claude Opus 5.5.
Насколько безопасна Claude Opus 5.5?
По оценке Anthropic, Claude Opus 5.5 — самая аккуратная в поведении модель среди последних Claude: до выпуска её проверяли внешние организации, включая METR, а автоматический аудит почти на 2 000 сценариев дал лучший результат почти по всем мерам.
- Честность. Лучший результат по большинству мер честности среди последних моделей Claude.
- Осторожность в действиях. Реже совершает трудно обратимые действия и реже выходит за заданные границы.
- Устойчивость к prompt injection — подмене инструкций через содержимое, например через текст на веб-странице или в файле, который модель читает. Здесь Opus 5.5 устойчивее Opus 5, а в тесте Gray Swan делит с Fable 5.1 самый низкий процент успешных атак среди всех проверенных моделей.
- Границы «песочницы». В новом тесте на выход за пределы изолированной среды попыток примерно на 85% меньше, чем у Opus 5 и Claude Mythos 5.1; все они малой серьёзности, и о каждой модель сообщала сама.
Оговорка Anthropic: модель часто подозревает, что её тестируют, и это усложняет оценку её поведения в реальной работе.
Защитные механизмы. У Opus 5.5 защита того же класса, что у Fable 5.1. Обычное исправление ошибок в коде работает как всегда, но большинство задач по кибербезопасности модель открыто передаёт Opus 4.8. Работа с биологическими исследованиями доступна только проверенным организациям — через программу Life Sciences Verification Program.
Кому Claude Opus 5.5 не подойдёт?
Claude Opus 5.5 — не лучший выбор, если вам нужны дешёвые массовые ответы, работа по кибербезопасности или ускоренный режим Fast.
- Тем, кто на тарифе СТАРТ. Opus 5.5 доступна с тарифа Про и на старших — ULTRA и командных. На СТАРТ можно работать с Claude Sonnet 5 и GPT-6 Astra.
- Для простых массовых задач. Сортировка писем, короткие справки и шаблонные тексты не требуют флагмана — такую работу выгоднее отдать модели попроще, а в ближайшие недели Anthropic обещает Sonnet 5.5 и Haiku 5.5.
- Специалистам по кибербезопасности. Большинство таких задач модель передаёт Opus 4.8, так что качества Opus 5.5 в разборе уязвимостей вы не получите.
- Тем, кому нужен режим Fast. Ускоренный режим есть только в продуктах Anthropic; в СуперИнтеллекте его нет.
- Для биологических исследований. Без проверки организации в программе Anthropic такие задачи недоступны.
- Если на выходе нужны картинки. Opus 5.5 понимает изображения, но отвечает только текстом.
Кому подходит Claude Opus 5.5?
Claude Opus 5.5 подходит тем, у кого задачи длинные, многошаговые и с высокой ценой ошибки: разработчикам, аналитикам, консультантам, исследователям и руководителям, которым важны точные цифры и короткие ответы.
| Кто | Типичные задачи | Что говорит в пользу Opus 5.5 |
|---|---|---|
| Разработчики и тимлиды | миграции, рефакторинг, аудит кода | Terminal-Bench 4.0 — 66,4%; аудит 200 000 строк меньше чем за три часа |
| Ревьюеры кода и тестировщики | поиск багов, ревью изменений | Deloitte: 72% известных багов на самом низком уровне против 56% у Opus 5 на высоком |
| Финансовые аналитики | отчёты, сквозные финансовые процессы | Hebbia: 86,6% требований против 60,3% у Opus 5; 16 из 18 отчётов без выдуманных цифр |
| Консультанты и бизнес-аналитики | расчёты в Excel, презентации, разбор сделок | GDPval-AA — 1846 Elo; разбор слияния за 63 минуты против 93 у Opus 5 |
| Исследователи | междисциплинарные вопросы, чтение графиков | Humanity's Last Exam — 67,7% и Chartography — 89,0% (оба теста — с инструментами) |
| Руководители и менеджеры | сводки, пересказ рабочей переписки | главное в начале ответа; у Box ответы на 40% короче без потери точности |
| Редакторы и авторы | тексты по правилам редакции | соблюдает заданные правила письма, по отзыву Ramp пишет как хороший коллега |
| Специалисты по автоматизации | многошаговые агентные цепочки | OSWorld 2.0 — 81,8%; но в AutomationBench GPT-6 Astra чуть впереди |
Как попробовать Claude Opus 5.5 в России?
Попробовать Claude Opus 5.5 в России проще всего в СуперИнтеллекте: модель в каталоге с 22 сентября 2026 года, работает без VPN и зарубежной карты, оплата — нейронами.
- Зарегистрируйтесь бесплатно: my.suin.ai/auth/register.
- Подключите тариф Про или старше — ULTRA или командный.
- В списке моделей выберите «Claude Opus 5.5».
- Выберите уровень усилий в чате: medium для повседневной работы, high и выше — для сложных многошаговых задач.
- Приложите файлы, изображения или документы, если задача с ними, и отправьте промпт.
- Для сравнения переключите модель в том же чате на Claude Fable 5.1, Claude Opus 5 или GPT-6 Astra — одним кликом, без переписывания промпта.
Первый тест: отчёт без выдуманных цифр
Ты — финансовый аналитик. Во вложении квартальный отчёт компании.

1. Выпиши ключевые показатели: выручку, прибыль, маржу и их изменение к прошлому кварталу.
2. Для каждой цифры укажи раздел или страницу отчёта, откуда она взята.
3. Если показателя в отчёте нет, так и напиши — не додумывай и не бери цифры из памяти.
4. В конце дай три главных вывода для руководителя, каждый не длиннее двух предложений.

Начни ответ с самого важного вывода.
Проверка на коде: аудит модуля
Во вложении модуль нашего проекта. Проведи аудит:

— найди ошибки и места, где поведение может сломаться на граничных случаях;
— отсортируй находки по серьёзности;
— для трёх самых серьёзных предложи исправление в виде диффа и объясни, почему оно не меняет остальное поведение;
— не трогай стиль и форматирование, если это не ошибка.

Начни с короткого списка: что критично, а что можно отложить.
Какие вопросы о Claude Opus 5.5 задают чаще всего?
Чаще всего спрашивают про разницу с Opus 5 и GPT-6 Astra, размер контекста, доступность в России, выбор уровня усилий и режим Fast. Коротко отвечаем на каждый.
Чем Claude Opus 5.5 отличается от Opus 5?
По данным Anthropic, Opus 5.5 сильнее Opus 5 во всех девяти тестах анонса, на типичных задачах примерно на 40% дешевле и отвечает более чем на 30% быстрее. К тому же она пишет короче.
Claude Opus 5.5 лучше, чем GPT-6 Astra?
В большинстве опубликованных тестов — да, но не во всех: в AutomationBench и Terminal-Bench-Science впереди GPT-6 Astra. Учтите, что таблицу публикует Anthropic, а результаты Astra взяты из данных OpenAI при уровне усилий high.
Какой контекст у Claude Opus 5.5?
У Claude Opus 5.5 контекст 1 000 000 токенов и ответ до 128 000 токенов. Модель принимает текст, изображения и файлы, а отвечает текстом.
Можно ли пользоваться Claude Opus 5.5 в России?
Да, в СуперИнтеллекте — без VPN и зарубежной карты, с тарифа Про. Регистрация бесплатная.
Какой уровень усилий выбрать в Claude Opus 5.5?
Для повседневной работы начните с medium, а high, xhigh и max оставьте для сложных многошаговых задач. Даже на самом низком уровне модель, по отзывам Deloitte и Rogo, обходит Opus 5 на высоком.
Есть ли у Claude Opus 5.5 режим Fast в СуперИнтеллекте?
Нет. Ускоренный режим Fast работает только в продуктах Anthropic. В СуперИнтеллекте модель работает в обычном режиме, который и так более чем на 30% быстрее Opus 5.