Claude Opus 5.5 для программирования подходит прежде всего там, где задача длинная и состоит из десятков шагов: миграция большой кодовой базы, аудит чужого проекта, перевод сервиса на другой язык, ревью с поиском неочевидных багов, оптимизация без изменения поведения. Модель вышла 22 сентября 2026 года и в тот же день появилась в каталоге СуперИнтеллекта — доступна с тарифа Про. Главное отличие от Claude Opus 5 — не проценты в тестах, а то, что до результата она доходит за меньшее число шагов и токенов.
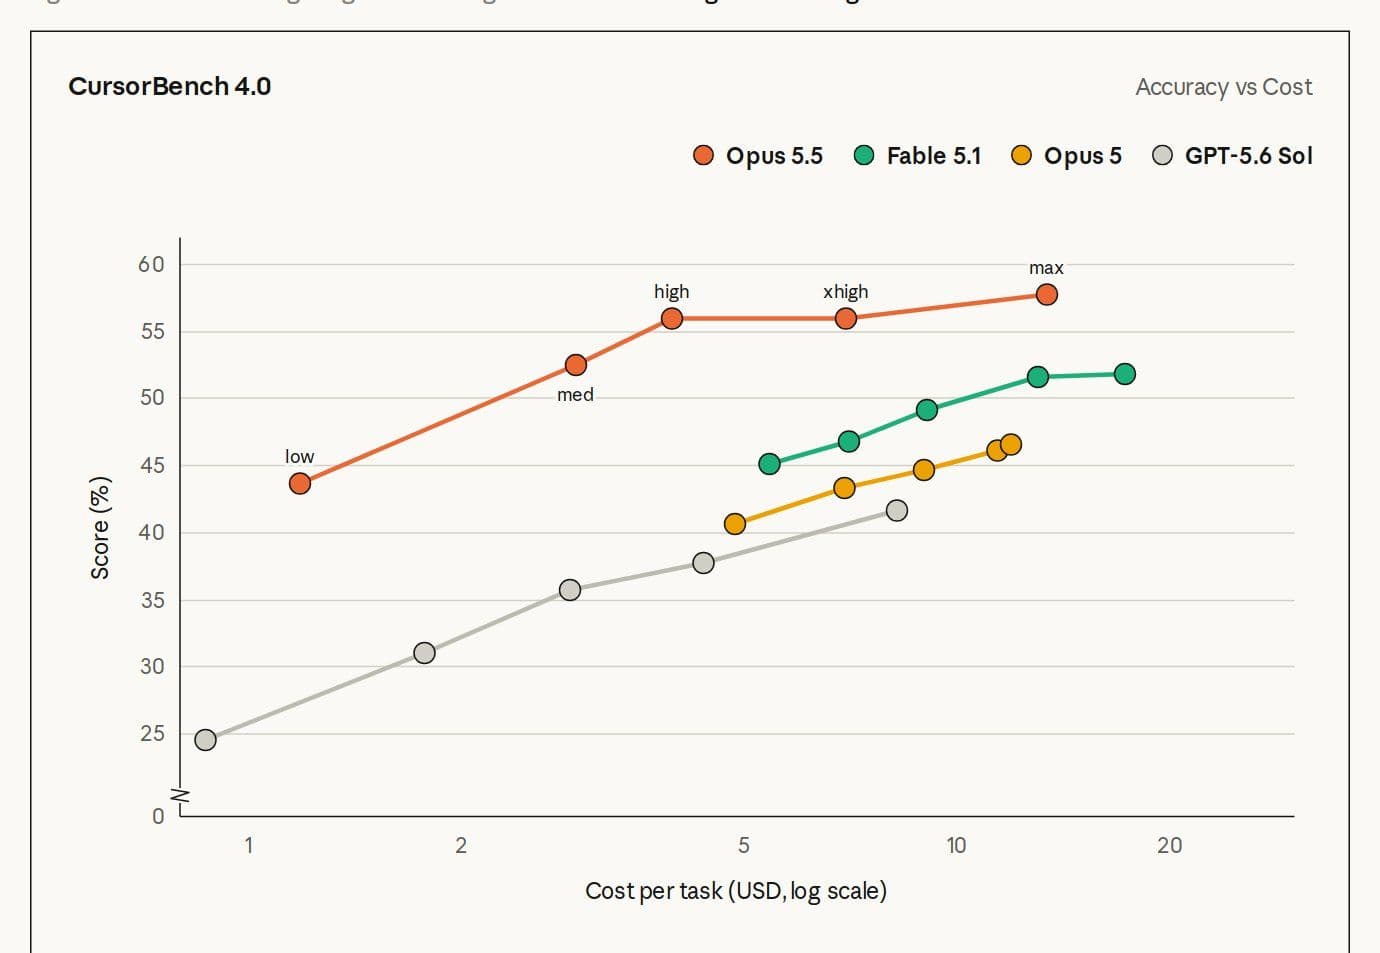
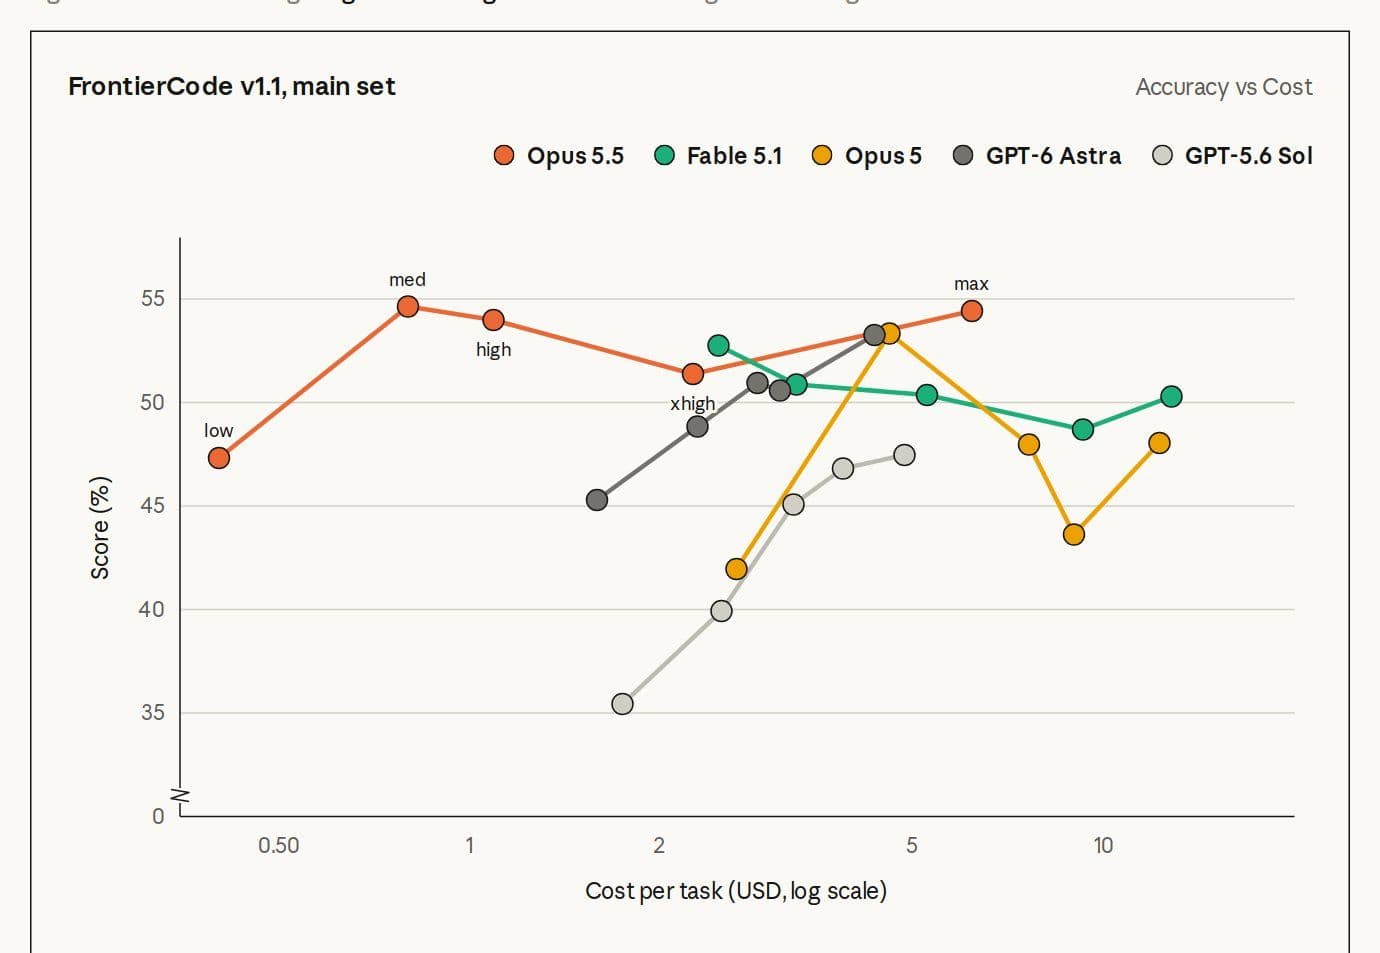
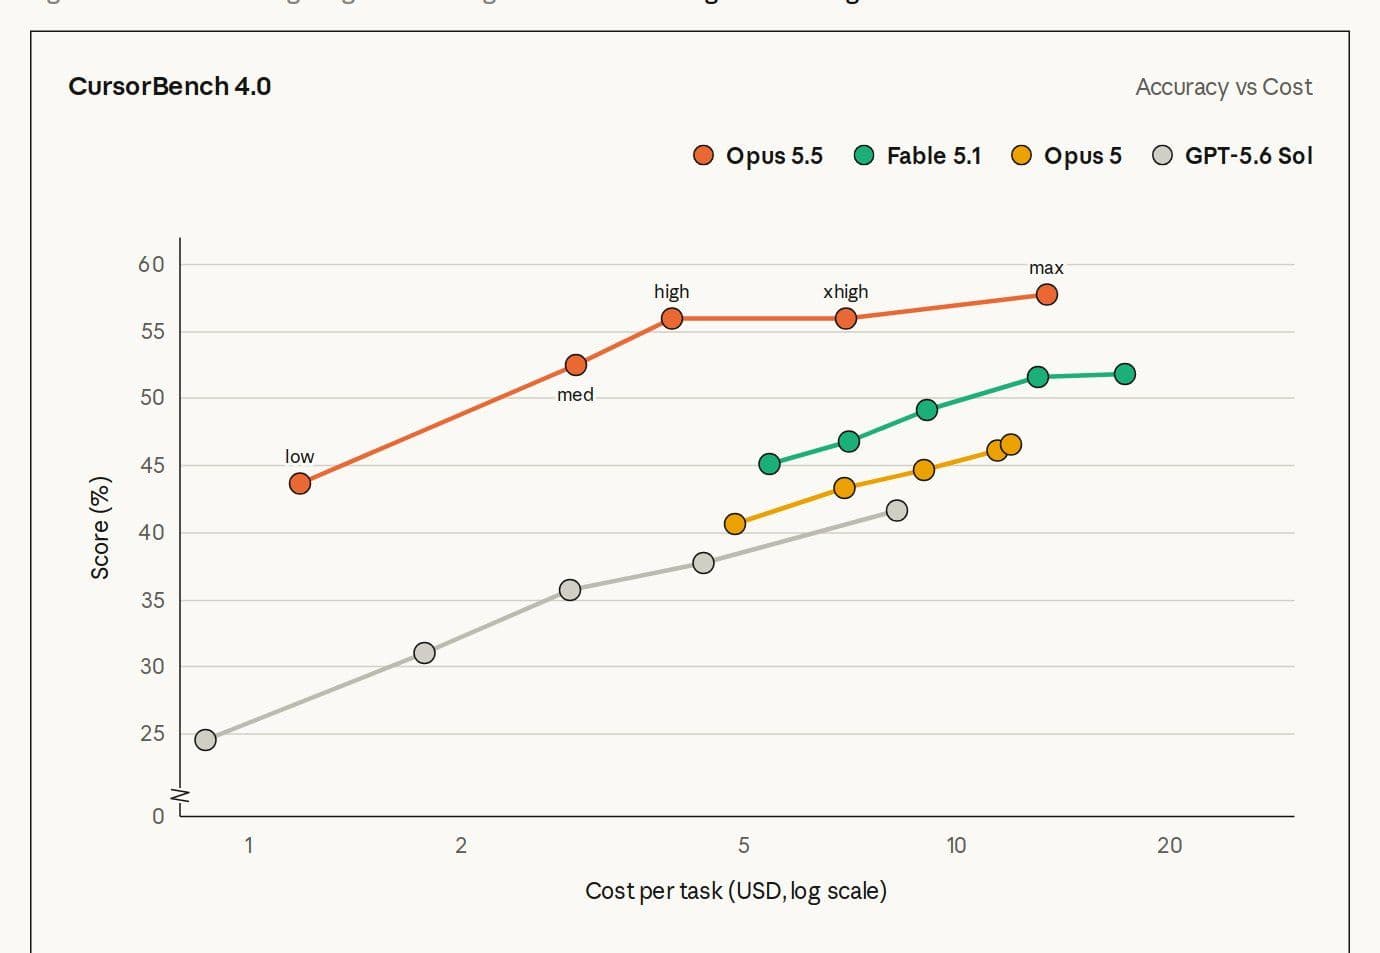
Цифры Anthropic по кодовым тестам: Terminal-Bench 4.0 — 66,4% против 52,3% у Opus 5, CursorBench 4.0 — 57,8% против 46,6%, FrontierCode — 54,4% против 48,0%. При настройках по умолчанию типичная задача, по оценке Anthropic, обходится примерно на 40% дешевле, чем у Opus 5: модель тратит меньше токенов, и сам токен стоит меньше. В СуперИнтеллекте расход нейронов считается от числа токенов, поэтому экономия переносится напрямую. Ответ модель выдаёт более чем на 30% быстрее.
Что изменилось в коде по сравнению с Claude Opus 5?
Прибавка есть на всех трёх кодовых тестах, и она крупнее, чем обычно бывает между соседними поколениями. Но практичнее другое: тот же результат достигается меньшим числом ходов.
| Тест | Что проверяет | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | агентное программирование в терминале | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1 (Main) | агентное программирование | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 | работа в редакторе кода | 57,8% | 51,8% | 46,6% | — | 41,7% |
Условия замеров важны не меньше самих чисел. Результаты Opus 5.5 получены на максимальном уровне усилий (Terminal-Bench 4.0 — при xhigh), у GPT-6 Astra — при high по данным OpenAI. Защитные механизмы были включены: когда они срабатывали, задачи по кибербезопасности выполняла Opus 4.8, а по биологии и разработке ИИ — Opus 5, из-за чего часть баллов 5.5, по оценке Anthropic, занижена. Сама Anthropic предупреждает: на таком уровне разрыв в баллах всё хуже отражает разницу в реальной работе, и в её собственном использовании Fable 5.1 отстаёт от Opus 5.5 меньше, чем в таблице. Подробный разбор различий — в отдельном материале Opus 5.5 против Opus 5.
Вторая половина изменений — про расход. По расчётам Anthropic, на FrontierCode модель при уровне усилий по умолчанию обходит GPT-6 Astra примерно за 20% его стоимости задачи. На Terminal-Bench 4.0 при том же уровне по умолчанию она догоняет Astra примерно за 40% стоимости, а Opus 5 на максимальном уровне обходит примерно за пятую часть. На CursorBench опережает GPT-5.6 Sol на 11 пунктов примерно за треть стоимости.
То же самое видят команды, получившие модель до выхода. GitHub: в Copilot CLI и VS Code — одни из самых малых объёмов токенов и шагов среди проверенных моделей, а терминальных задач в VS Code решено больше, чем у Opus 5, менее чем за половину шагов. Kiro: на публичном бенчмарке решено больше задач, чем у Opus 5, примерно с 40% меньшим числом вызовов инструментов и половиной токенов. Lovable: сборка за треть–половину прежних шагов при том же качестве. Box: треть токенов Opus 5 и ответы на 40% короче без потери точности. Optiver: качество Opus 5 примерно за половину ходов, времени и токенов, стоимость этой нагрузки ниже на 40–50%.
Для каких задач кода Opus 5.5 подходит лучше всего?
Лучше всего — миграции, аудит незнакомой кодовой базы, перевод кода на другой язык, ревью и оптимизация без изменения поведения. Общее у них одно: много шагов подряд. На короткой правке разницу с Opus 5 вы почти не заметите, на многочасовом прогоне — увидите сразу. Ниже сценарии из анонса Anthropic, по которым видно, чего ждать.
Миграции больших кодовых баз
Ранний тестировщик провёл миграцию кода на 680 000 строк быстрее чем за сутки. В таких задачах работают две вещи сразу: контекст в миллион токенов позволяет держать перед глазами много файлов, а экономия токенов решает, дойдёт ли прогон до конца или упрётся в бюджет на половине пути.
Аудит и исправление чужого проекта
Аудит и исправление кодовой базы на 200 000 строк заняли меньше трёх часов. Opus 5 на той же работе потратила больше 20 часов и в 2,5 раза больше токенов — разница уже не в качестве ответа, а в том, доведёте вы дело до конца за рабочий день или нет.
Оптимизация без изменения поведения
В задаче «ускорить загрузку всех страниц веб-приложения» Opus 5.5 справилась 39 раз из 40. Opus 5 добивалась меньших улучшений и при этом меняла поведение приложения — а это худший исход оптимизации: стало быстрее, но работает уже не так, как раньше.
Перевод кода на другой язык
HAProxy — балансировщик нагрузки — переводили с C на Rust. Обе модели прошли почти все регрессионные тесты, но Opus 5.5 потратила на это 9,5 часа против 12 у Claude Fable 5.1 и обошлась на 51% дешевле.
Ревью и поиск багов
В Deloitte на самом низком уровне усилий модель нашла 72% известных багов против 56% у Opus 5 на высоком уровне. Это, пожалуй, самый практичный вывод всего гайда: на ревью не нужно включать максимум — низкий уровень справляется лучше, чем прежняя модель на высоком, и тратит заметно меньше.
Долгие автономные прогоны
Clio: большая задача в шести репозиториях, больше 18 часов без присмотра — модель быстрее доходила до промежуточных этапов, почти не требовала переделок и оставляла короткие полезные комментарии. Stripe: одна сессия управляла ещё дюжиной и довела до CI 40 связанных pull request. В Column отмечают, что модель заметно лучше делегирует подзадачи вспомогательным агентам и что она нашла экономию в облачном счёте, которую прежние модели пропускали.
Честная оговорка: такие прогоны идут в инструментах с прямым доступом к репозиторию, а чат — другой формат работы. В чате СуперИнтеллекта ту же задачу разбивают на шаги: план, затем кусок работы, затем проверка. Сильная сторона Opus 5.5 здесь в том, что она реже теряет нить между шагами и короче объясняет, что сделала.
Рутина, которой много
Quantium: задача, раньше занимавшая 38 промптов за четыре дня, решена за 11 промптов и три часа. В Ramp отмечают, что модель пишет как хороший коллега и соблюдает заданные командой правила письма — значит, свод правил проекта имеет смысл выдавать ей прямо в чат, а не надеяться на умолчания.
Как выбирать уровень усилий для кода?
Ставьте medium по умолчанию, low — на рутину, а high и xhigh берегите для задач, где много шагов и дорого ошибиться. У Anthropic уровень по умолчанию — medium; в СуперИнтеллекте он переключается прямо в чате, переписывать промпт не нужно.
| Уровень | Какие задачи | Что показывают замеры |
|---|---|---|
| low | мелкая правка, шаблонный тест, переименование, разбор лога, первое ревью | Deloitte: 72% известных багов против 56% у Opus 5 на высоком уровне |
| medium | обычная фича, рефакторинг файла, разбор незнакомого модуля | Factory ставит medium по умолчанию: догнали Opus 5 на high с 20–25% меньшим числом выходных токенов |
| high | несколько модулей сразу, спорная архитектура, разбор запутанного бага | Walleye Capital: на высоких уровнях модель заметила ошибку в самих инструкциях и учла её |
| xhigh / max | миграция, перевод на другой язык, многочасовой прогон | результат Terminal-Bench 4.0 в 66,4% получен именно при xhigh |
Смысл низких уровней изменился: раньше «подешевле» означало «похуже», теперь — нет. У Rogo модель на самом низком уровне обошла Opus 5 на высоком примерно с 60% меньшим числом выходных токенов. В Factory называют Opus 5.5 первой моделью, которую готовы по умолчанию ставить на medium. То есть по коду разумнее начинать снизу и подниматься, а не наоборот.
Какие промпты дать Opus 5.5 для работы с кодом?
Работают промпты, где заданы три вещи: что считать проблемой, в каком виде нужен ответ и чего делать не надо. Ниже семь заготовок — подставьте свои названия в угловых скобках и приложите к сообщению сами файлы.
Ревью изменений
Ты — старший инженер, который ревьюит мой код. Ниже описание задачи, diff и файлы, которых он касается.

Проверь по порядку:
1) поведение расходится с тем, что заявлено в задаче;
2) необработанные ошибки и проглоченные исключения;
3) запросы в цикле, лишние обходы, блокировки основного потока;
4) доступ к данным: не расширяем ли мы видимость чужих записей;
5) обратная совместимость с уже работающими клиентами.

Формат ответа: список находок, каждая — файл и строка, что сломается и при каких входных данных, как чинить. Сначала блокирующие, потом остальные. Если находок нет — скажи прямо, не придумывай.
Поиск причины бага
Симптом: <что видит пользователь>. Воспроизведение: <когда и как часто>. Ожидаемое поведение: <...>.
Прикладываю: фрагмент лога, код обработчика, схему таблицы.

Сначала выпиши 3–5 гипотез о причине. Для каждой — проверку, которую я выполню за минуту: запрос, строка в логе, флаг, эксперимент. Отсортируй по вероятности и объясни, почему именно так.

Не предлагай правку, пока не назовёшь проверку, которая подтверждает гипотезу.
План миграции
Нужно перевести <модуль или сервис> с <текущее решение> на <целевое>. Прикладываю точки входа, список зависимостей и тесты.

Составь план:
— этапы, каждый из которых можно выкатить и откатить отдельно;
— что ломается на каждом этапе и по какому признаку я это замечу;
— места, где нужно решение человека, а не автозамена;
— тесты, которые надо написать до начала работ.

Отдельным списком: чего ты не видишь в приложенных файлах, но что обязательно проверить.
Рефакторинг модуля
Файл <имя> разросся, его правят несколько человек. Задача — разнести его, не меняя поведение.

Шаг 1. Опиши, что модуль делает сейчас: публичные функции, кто их вызывает, скрытое состояние, побочные эффекты. Остановись и дождись моего подтверждения, что описание верное.
Шаг 2. Предложи разбиение, где у каждого файла одна причина для изменения.
Шаг 3. Дай порядок шагов так, чтобы после каждого код собирался и тесты проходили.

Ничего не переименовывай ради красоты.
Написание тестов
Напиши тесты на <функцию или модуль> из приложенного файла. Фреймворк — <какой>, стиль — как в приложенном примере теста.

Покрой: обычный сценарий; границы (пусто, ноль, максимум, дубликаты, юникод); отказы зависимостей (таймаут, ошибка, неверный формат ответа); параллельные вызовы, если они возможны.

Не переписывай исходный код под тесты. Если функцию нельзя проверить без правки — вынеси это отдельным пунктом и предложи минимальное изменение.
Перевод кода на другой язык
Переведи приложенный модуль с <язык-источник> на <язык-цель>. Требование: внешнее поведение совпадает, включая обработку ошибок и граничные случаи.

Порядок: сначала список мест, где у языков разная семантика (числа, строки и кодировки, время и часовые пояса, параллелизм, исключения) и твоё решение по каждому. Потом код. Потом тесты, которые прогоняются на обеих версиях и сравнивают результат.

Логику по дороге не улучшай — предложения вынеси в конец отдельным списком.
Разбор незнакомого проекта
Я получил проект, которого не знаю. Прикладываю дерево файлов, список зависимостей и 3–5 ключевых файлов.

Объясни: что это за система, какие у неё внешние связи (база, очереди, сторонние сервисы), где точка входа, где бизнес-логика, а где обвязка. Отметь опасные места: молчаливые перехваты ошибок, собранные строками запросы, ключи в коде, задачи по расписанию.

Закончи списком вопросов ко мне — того, что по коду понять нельзя.
Общее у этих промптов — запрет на «улучшения по дороге» и требование назвать проверку до правки. Opus 5.5 такие рамки держит лучше Opus 5: главное она выносит в начало ответа, реже уходит в длинные рассуждения и соблюдает заданный формат. Многословность была основной претензией к Opus 5, и в новой версии её чинили целенаправленно.
Чего Opus 5.5 не сделает и где она уступает?
Большинство задач по кибербезопасности она не возьмёт — прозрачно передаст их Opus 4.8, это встроенный защитный механизм класса Fable 5.1, а не ограничение платформы. А в бизнес-автоматизациях и научных задачах в терминале впереди GPT-6 Astra. Обычное исправление ошибок в коде под защитный механизм не попадает и работает как всегда.
- Кибербезопасность. Если вы разбираете уязвимость или пишете инструмент анализа защищённости, часть работы уйдёт к Opus 4.8 — модель сообщает об этом.
- Биологические исследования — только для организаций, прошедших проверку Anthropic по её программе верификации.
- Бизнес-автоматизации: на AutomationBench у Opus 5.5 40,0% против 41,4% у GPT-6 Astra — здесь впереди конкурент. На Terminal-Bench-Science 0.1 разрыв больше: 58,7% против 64,6%.
- Все цифры в гайде — замеры вендора и его ранних пользователей, а не независимая проверка. Anthropic и сама пишет, что на таком уровне разрыв в баллах хуже отражает разницу в реальной работе.
Отдельно про безопасность агентных сценариев. По данным Anthropic, Opus 5.5 устойчивее Opus 5 к prompt injection — подмене инструкций через содержимое, когда команда для модели спрятана в тексте задачи, в README или в комментарии к issue. Для кода это важнее, чем кажется: модель, которая читает репозиторий и веб, читает и то, что туда положили посторонние. Правило остаётся прежним: прочитанное в файлах — данные, а не приказ, и действие с последствиями подтверждает человек.
Как работать с файлами проекта в чате СуперИнтеллекта?
Файлы прикладываются прямо в чат — код, логи, документы, изображения; отдельная настройка для этого не нужна. Дальше всё решает то, что вы приложили и что объяснили.
- Кладите не весь репозиторий, а срез: точку входа, разбираемый модуль, его тесты, схему таблиц, кусок лога с ошибкой. Контекст в миллион токенов позволяет многое, но лишние файлы размывают ответ.
- Первым сообщением давайте правила проекта: язык и версию, стиль, что трогать нельзя, как называются слои. Модель их соблюдает — об этом говорят в Ramp.
- Просите план до правок. Отвечает Opus 5.5 короче прежней модели, и по плану сразу видно, верно ли она поняла задачу.
- Закрепляйте формат ответа: файл, строка, причина, проверка. Без этого получите связный текст вместо списка задач.
- Переключайте уровень усилий по ходу: разбор — medium, спорное место — high, рутина — обратно на low.
- Держите вторую модель для сверки: в том же окне доступны Claude Fable 5.1, Claude Opus 5, GPT-6 Astra и GPT-5.6 Sol. Переключение — один клик, промпт переписывать не нужно.
Если не хотите следить за версиями, выбирайте псевдоним Claude Opus Latest — он всегда ведёт на свежую Opus, сейчас на 5.5. Закрепили его в чате или в своём агенте — при выходе следующей версии перенастраивать ничего не придётся. Подробности настроек — в гайде как пользоваться Claude Opus 5.5.
Читать также: обзор Claude Opus 5.5 — что изменилось во всей модели, не только в коде; как пользоваться Claude Opus 5.5 — уровни усилий, файлы, настройки чата; Claude Opus 5 для кода — прежний гайд, если вы пока работаете на Opus 5.