
Обучения
Claude Opus 5.5 или Fable 5.1: что выбрать под свою задачу
Claude Opus 5.5 или Fable 5.1: по данным Anthropic, новая Opus работает на уровне Fable 5.1 и опережает её во всех тестах анонса. Но в реальной работе разрыв меньше, чем в таблице. Разбираем бенчмарки, два прямых сравнения, безопасность и случаи, когда Fable 5.1 всё же нужна.
Команда СуперИнтеллекта · · ~7 мин
Claude Opus 5.5 или Fable 5.1 — для большинства задач теперь разумно начинать с Opus 5.5. Модель вышла 22 сентября 2026 года, и, по оценке Anthropic, на большинстве задач работает на уровне Fable 5.1, а во всех тестах из таблицы анонса опережает её. Оговорка важная: это данные самого разработчика, и он же признаёт, что в собственной работе компании Fable 5.1 отстаёт от Opus 5.5 меньше, чем следует из таблицы. Поэтому Fable 5.1 не стала лишней — она оправдана там, где на ваших задачах проверенно даёт результат лучше.
Обе модели доступны в СуперИнтеллекте с тарифа Про в одном окне, так что любой вывод из статьи можно проверить на своей задаче, не выходя из чата.
Что такое Claude Fable 5.1 и почему с ней сравнивают Opus 5.5?
Fable 5.1 — та модель, на уровень которой Anthropic равняла новый флагман. В анонсе Opus 5.5 меряют именно против неё, и вышла новинка с защитными механизмами класса Fable 5.1. По оценке Anthropic, на большинстве задач Opus 5.5 работает на уровне Fable 5.1, а во всех тестах анонса набирает больше баллов — отсюда и вопрос, нужна ли теперь вторая модель. Подробнее о ней — в обзоре Claude Fable 5.1.
Opus 5.5 — первая модель нового семейства Claude 5.5 и преемница Opus 5; Sonnet 5.5 и Haiku 5.5 Anthropic обещает в ближайшие недели. Что известно о новинке:
- контекст — 1 000 000 токенов, ответ — до 128 000 токенов;
- на вход принимает текст, изображения и файлы, отвечает текстом;
- уровни усилий рассуждений — low, medium, high, xhigh и max; у Anthropic по умолчанию medium, в СуперИнтеллекте уровень выбирается прямо в чате;
- по данным Anthropic, генерирует ответ более чем на 30% быстрее Opus 5, а при настройках по умолчанию на типичных задачах обходится примерно на 40% дешевле неё.
Что показывают бенчмарки Opus 5.5 и Fable 5.1?
По данным Anthropic, Opus 5.5 набирает больше баллов, чем Fable 5.1, во всех тестах, опубликованных в анонсе. Но отрыв неравномерный: заметный в агентном программировании и бизнес-автоматизациях, минимальный в управлении компьютером и распознавании графиков.
| Тест | Что проверяет | Opus 5.5 | Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | агентное программирование в терминале | 66,4% | 55,8% |
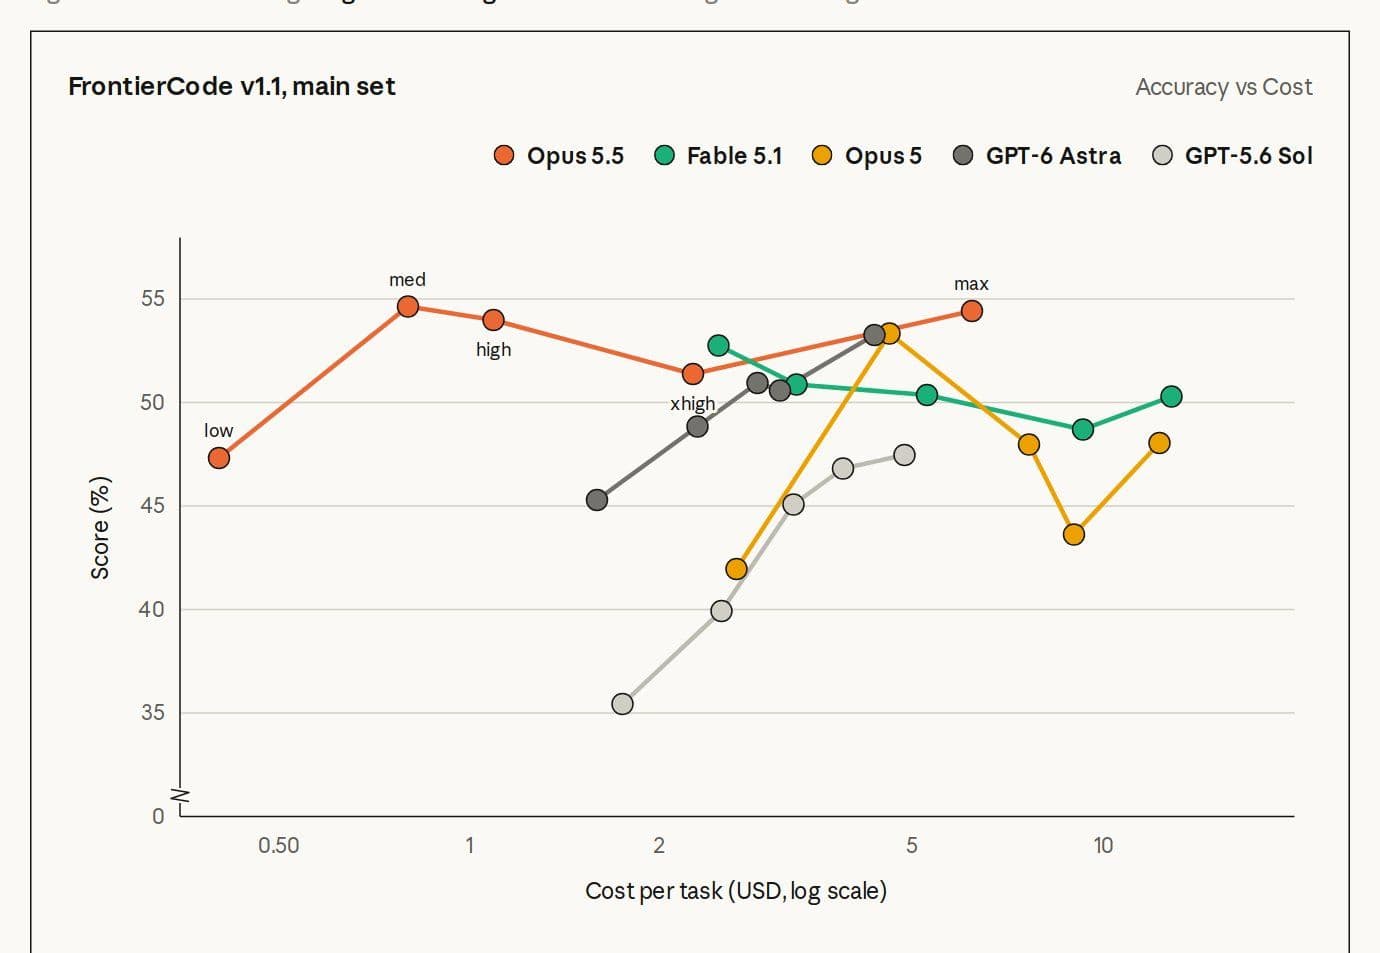
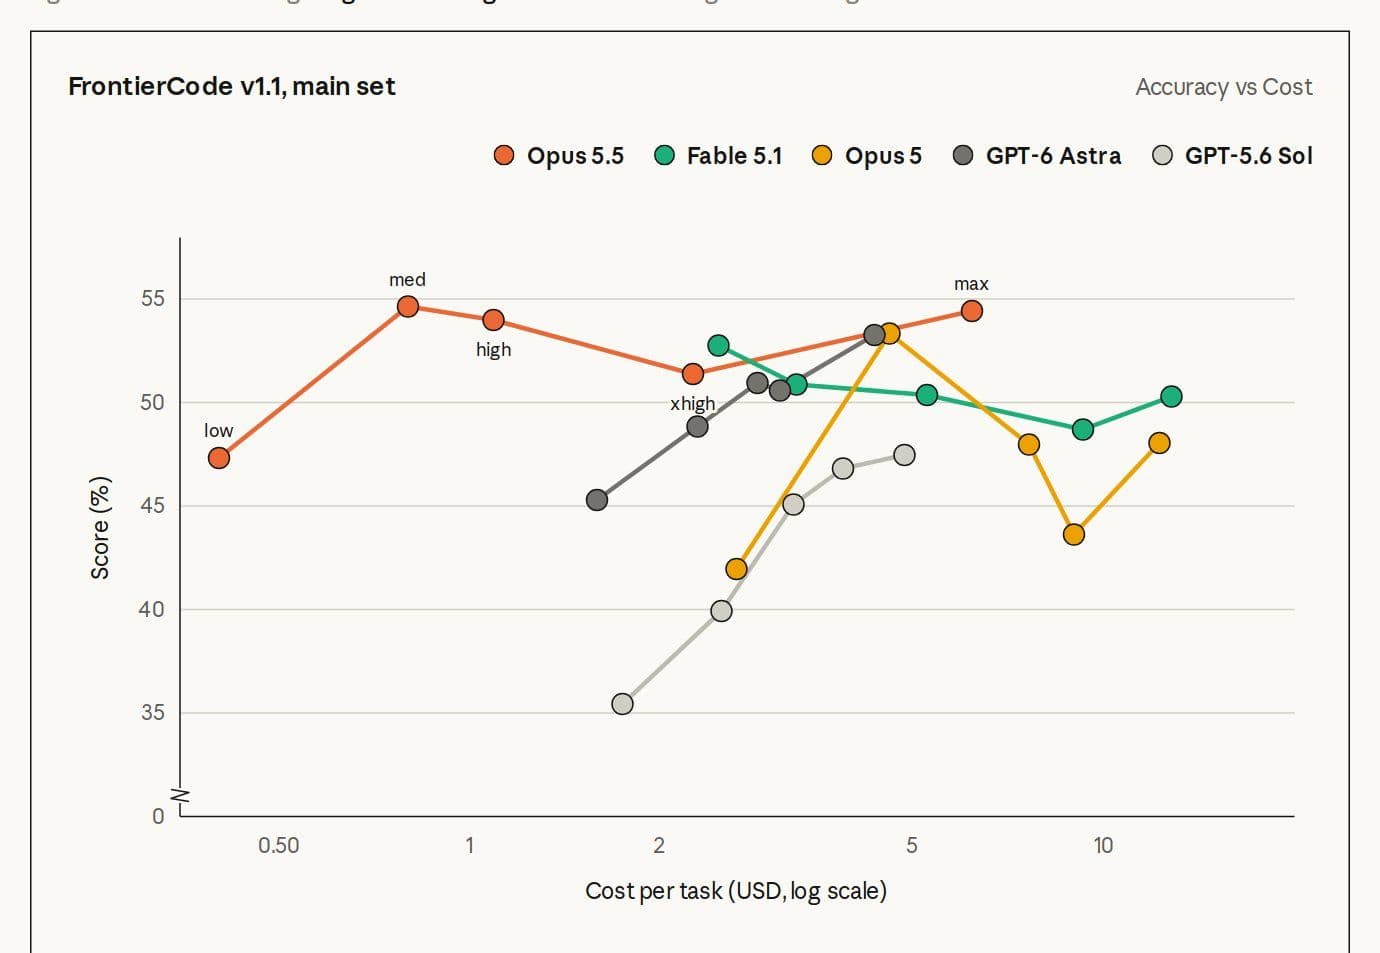
| FrontierCode v1.1 (Main) | агентное программирование | 54,4% | 50,3% |
| CursorBench 4.0 | работа в редакторе кода | 57,8% | 51,8% |
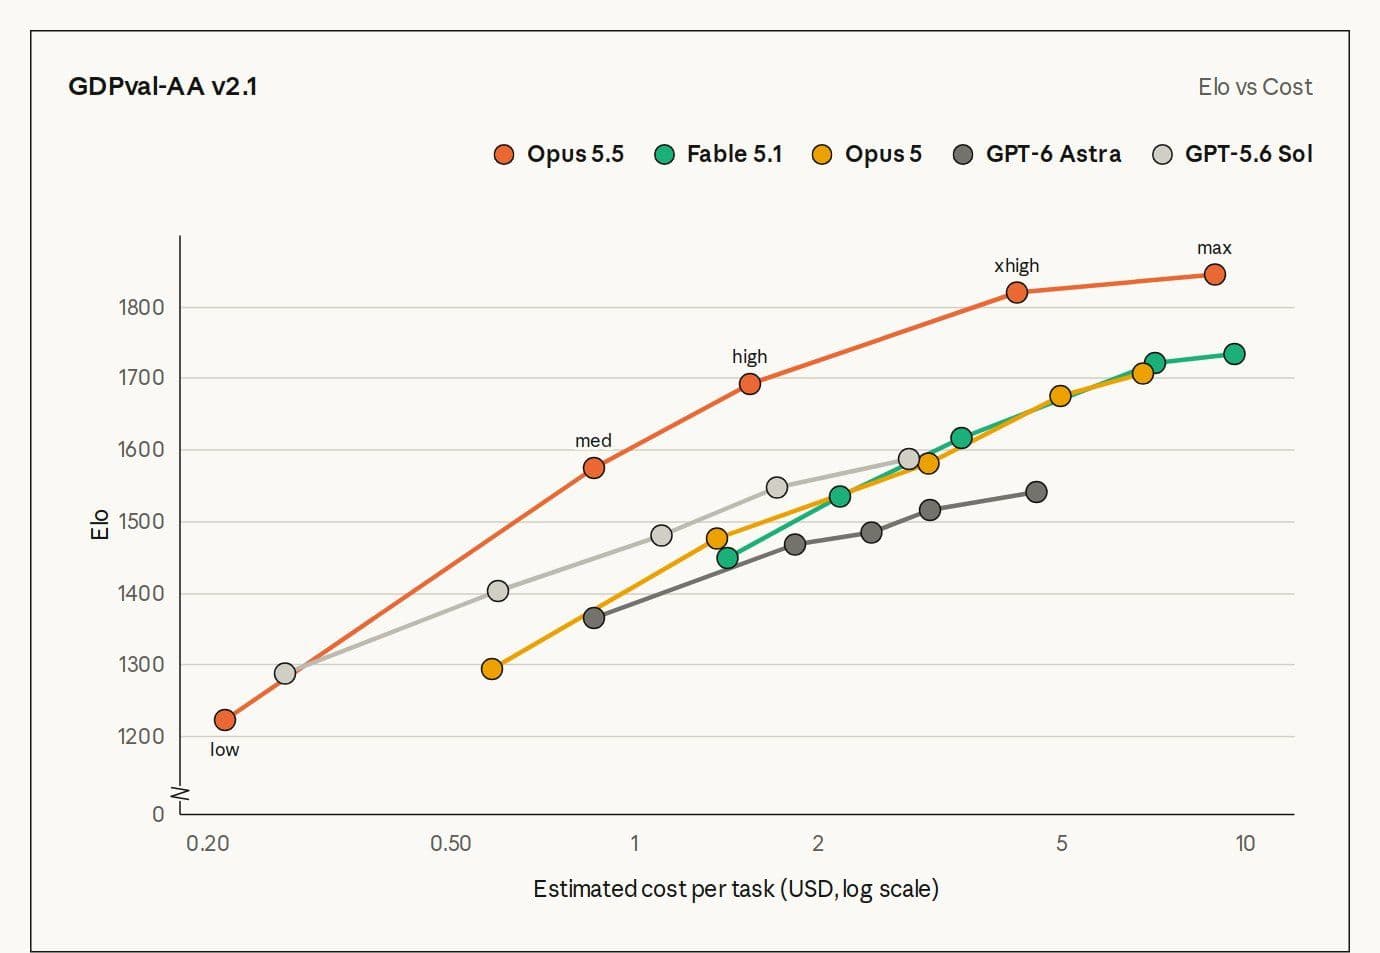
| GDPval-AA v2.1 | офисная работа в 44 профессиях, Elo | 1846 | 1735 |
| AutomationBench | бизнес-автоматизации | 40,0% | 31,4% |
| Humanity's Last Exam | междисциплинарные рассуждения, с инструментами | 67,7% | 65,6% |
| Terminal-Bench-Science 0.1 | научные задачи в терминале | 58,7% | 52,6% |
| OSWorld 2.0 | управление компьютером | 81,8% | 80,7% |
| Chartography | распознавание графиков, с инструментами | 89,0% | 88,4% |
Как читать таблицу. Результаты Opus 5.5 получены на максимальном уровне усилий, в Terminal-Bench 4.0 — на уровне xhigh. Тесты шли со включёнными защитными механизмами: когда они срабатывали, задачи по кибербезопасности выполняла Opus 4.8, а по биологии и разработке ИИ — Opus 5. По оценке Anthropic, из-за этого часть баллов Opus 5.5 занижена. AutomationBench считала компания Zapier, остальные цифры — из анонса Anthropic.
Для полноты картины: в AutomationBench и Terminal-Bench-Science впереди обеих моделей Claude оказалась GPT-6 Astra — 41,4% и 64,6% (по данным OpenAI, на уровне high). Как Opus 5.5 выглядит на фоне моделей OpenAI, разобрано в сравнении с GPT-6 Astra и GPT-5.6 Sol.
Почему на практике разрыв меньше, чем в таблице?
Потому что так считает сама Anthropic: на нынешнем уровне моделей разница в баллах всё хуже отражает разницу в реальной работе, и во внутреннем использовании компании Fable 5.1 уступает Opus 5.5 меньше, чем показывают цифры. Для анонса это редкое признание, и выводы из него практические:
- Таблица показывает направление, а не величину. Opus 5.5 не хуже ни в одном тесте, но на вашей задаче она не обязательно окажется заметно лучше.
- Малые разрывы можно не учитывать. В OSWorld 2.0 и Chartography модели идут почти вровень, и выбирать между ними по этим тестам бессмысленно.
- Решает ваш собственный прогон. Бенчмарк — среднее по чужим задачам; несколько ваших типичных задач скажут о выборе больше.
Как Opus 5.5 и Fable 5.1 справились с реальными задачами?
В тех примерах анонса, где Anthropic сравнила модели напрямую, Opus 5.5 оказалась быстрее и экономнее в программировании и заметно аккуратнее с фактами в аналитике.
Перевод HAProxy с C на Rust
HAProxy — балансировщик нагрузки, написанный на C. Моделям поручили переписать его на Rust — многочасовая автономная работа, результат которой проверяют регрессионными тестами. Обе модели прошли почти все тесты, то есть по качеству итог близкий. Разница — в цене пути: Opus 5.5 уложилась в 9,5 часа против 12 у Fable 5.1 и обошлась на 51% дешевле.
Вывод: на длинной инженерной задаче, где справляются обе модели, Opus 5.5 приходит к тому же результату быстрее. В СуперИнтеллекте нейроны списываются по числу токенов, так что выигрыш в вашем расходе зависит от задачи.
Квартальный отчёт по трудно находимым данным
Во втором примере модели готовили отчёт о квартальных результатах компании по сохранённой копии интернета, где пресс-релиз с цифрами трудно найти. Проверяли главное для такой работы — нет ли в отчёте выдуманных чисел и цитат. У Opus 5.5 проверку прошли 16 отчётов из 18, у Fable 5.1 и Opus 5 — ни одного.
Для аналитики это самый весомый аргумент: главный риск здесь — выдуманная цифра, которая уходит в презентацию для руководства. И разница тут не в долях балла: у одной модели почти все отчёты чистые, у другой чистых нет. Оговорка: это один сценарий Anthropic, и у Opus 5.5 тоже прошли не все отчёты, так что цифры в итоговом документе сверять всё равно нужно. Как выстроить такую работу — в гайде по Opus 5.5 для аналитики и исследований.
Та же картина в офисных задачах в целом: в GDPval-AA, который оценивает работу в 44 профессиях, у Opus 5.5 рейтинг 1846 пунктов Elo против 1735 у Fable 5.1.
Какая модель безопаснее — Opus 5.5 или Fable 5.1?
По данным Anthropic, по безопасности они на одном уровне: в тесте Gray Swan обе делят самый низкий процент успешных атак среди всех проверенных моделей. У Opus 5.5 при этом действуют защитные механизмы класса Fable 5.1: обычное исправление ошибок в коде работает, но большинство задач по кибербезопасности модель прозрачно передаёт Opus 4.8, а работа с биологическими исследованиями открыта только проверенным организациям через Life Sciences Verification Program. Поэтому переходить на Fable 5.1 ради задач, которые Opus 5.5 не берёт из-за ограничений, смысла нет — ограничения там того же класса.
Отдельно Anthropic отчитывается об Opus 5.5. До выпуска её проверяли внешние организации, включая METR. В автоматическом аудите поведения почти на 2 000 сценариев она показала лучший результат среди последних моделей Claude почти по всем мерам. В новом тесте на пересечение границ «песочницы» попыток было примерно на 85% меньше, чем у Opus 5 и Claude Mythos 5.1, все малой серьёзности, и о них модель сообщала сама.
Сама Anthropic делает оговорку: модель часто подозревает, что её тестируют, и это усложняет оценку того, как она поведёт себя в реальных условиях.
Когда всё-таки стоит выбрать Fable 5.1?
Fable 5.1 стоит выбирать, когда у вас есть собственное подтверждение, что на вашей задаче она лучше, или когда нужна вторая сильная модель для перекрёстной проверки. Честных сценариев немного:
- Вы уже сравнивали, и Fable 5.1 стабильно выигрывает. Если на вашем коде или ваших документах она раз за разом даёт результат лучше, это весомее любой таблицы вендора. Раз на практике разрыв меньше, чем в цифрах, на отдельных задачах перевес может оказаться и на её стороне.
- Нужно второе мнение. Где ошибка дорогая — архитектура, ревью важного изменения в коде, выводы для руководства, — ответ Opus 5.5 полезно отдать на проверку другой сильной модели. Сошлись — действуйте увереннее, разошлись — туда и стоит посмотреть самому.
- У вас налаженный процесс на Fable 5.1. Проверенного агента или шаблон промптов не переключайте вслепую: прогоните на Opus 5.5 несколько типичных задач параллельно и переходите, когда убедитесь, что результат не хуже.
Чего делать не стоит — включать Fable 5.1 «на всякий случай», без проверки. В прямых сравнениях из анонса Opus 5.5 ей не уступила, а на длинной инженерной задаче оказалась быстрее и дешевле.
Второе мнение удобно получать в том же чате: переключите модель на Claude Fable 5.1 и отправьте промпт ниже — задачу переписывать не придётся, она уже в истории.
Второе мнение от другой модели
Проверь последний ответ в этом чате как строгий рецензент. Его написала другая модель, твоя задача — найти, где он может подвести.

— Фактические ошибки и утверждения, которые не опираются на данные из задачи или приложенных файлов.
— Логические пробелы и пропущенные риски.
— Что в ответе верно и не требует правок.

Не переписывай ответ целиком: дай список замечаний, у каждого — цитата места, к которому оно относится. В конце — вывод одной фразой: можно ли использовать ответ как есть и что исправить в первую очередь.
Как сравнить Opus 5.5 и Fable 5.1 на своей задаче?
Проще всего — дать одну и ту же задачу обеим моделям: в СуперИнтеллекте Claude Opus 5.5 и Claude Fable 5.1 доступны с тарифа Про в одном окне, а модель переключается одним кликом, без переписывания промптов.
- Возьмите реальную задачу: фрагмент вашего кода, отчёт, договор. Приложите файлы — чат принимает документы и изображения.
- Выберите Claude Opus 5.5 и уровень усилий. Цифры из таблицы получены на максимальном, у Anthropic по умолчанию medium.
- Задайте ту же задачу Claude Fable 5.1 — лучше в новом чате, чтобы она решала с чистого листа и не видела ответ Opus 5.5.
- Сравните качество (есть ли ошибки и выдумки), время до готового результата и расход нейронов.
- Если результат равный, оставляйте ту модель, что быстрее и экономнее. Если Fable 5.1 на вашей задаче стабильно лучше — это и есть случай, когда она оправдана.
СуперИнтеллект работает в России без VPN и зарубежной карты, регистрация бесплатная — создайте аккаунт и прогоните обе модели на своей задаче.