
Обучения
Claude Opus 5.5 vs GPT-6 Astra и GPT-5.6 Sol: какую модель выбрать
Claude Opus 5.5 vs GPT-6 Astra: Opus 5.5 впереди в коде, офисной работе и сложных рассуждениях, GPT-6 Astra — в бизнес-автоматизациях и научных задачах в терминале. Таблица бенчмарков, экономичность по данным Anthropic, честные оговорки и способ проверить выбор на своей задаче.
Команда СуперИнтеллекта · · ~7 мин
Claude Opus 5.5 vs GPT-6 Astra: по данным Anthropic, опубликованным 22 сентября 2026 года вместе с выходом Opus 5.5, новая модель впереди в программировании, офисной работе и сложных рассуждениях, а GPT-6 Astra — в автоматизации бизнес-процессов и научных задачах в терминале. Для кода, отчётов и аналитики выбирайте Opus 5.5, для автоматизаций и научных расчётов сначала проверьте GPT-6 Astra. GPT-5.6 Sol в этой тройке отстаёт почти везде, где есть его результаты.
Все три модели доступны в СуперИнтеллекте в одном окне чата: GPT-6 Astra — с тарифа СТАРТ, Claude Opus 5.5 и GPT-5.6 Sol — с тарифа Про. Ниже — сводная таблица, разбор сильных сторон каждой модели и способ проверить выбор на собственной задаче. Подробно о самой новинке — в обзоре Claude Opus 5.5.
Как Opus 5.5, GPT-6 Astra и GPT-5.6 Sol выглядят в бенчмарках?
В сводной таблице Anthropic Opus 5.5 лидирует в большинстве тестов, где есть с чем сравнить, а GPT-6 Astra — в двух: AutomationBench и Terminal-Bench-Science. Прочерк означает, что результата модели в публикации нет.
| Тест | Что проверяет | Claude Opus 5.5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | агентное программирование в терминале | 66,4% | 57,9% | 37,3% |
| FrontierCode v1.1 (Main) | агентное программирование | 54,4% | 53,3% | 47,5% |
| CursorBench 4.0 | работа в редакторе кода | 57,8% | — | 41,7% |
| GDPval-AA v2.1 | офисная работа в 44 профессиях, Elo | 1846 | 1542 | 1588 |
| AutomationBench | бизнес-автоматизации | 40,0% | 41,4% | 28,8% |
| Humanity's Last Exam | междисциплинарные рассуждения, с инструментами | 67,7% | 57,2% | — |
| Terminal-Bench-Science 0.1 | научные задачи в терминале | 58,7% | 64,6% | 22,4% |
| OSWorld 2.0 | управление компьютером | 81,8% | — | — |
| Chartography | распознавание графиков, с инструментами | 89,0% | — | — |
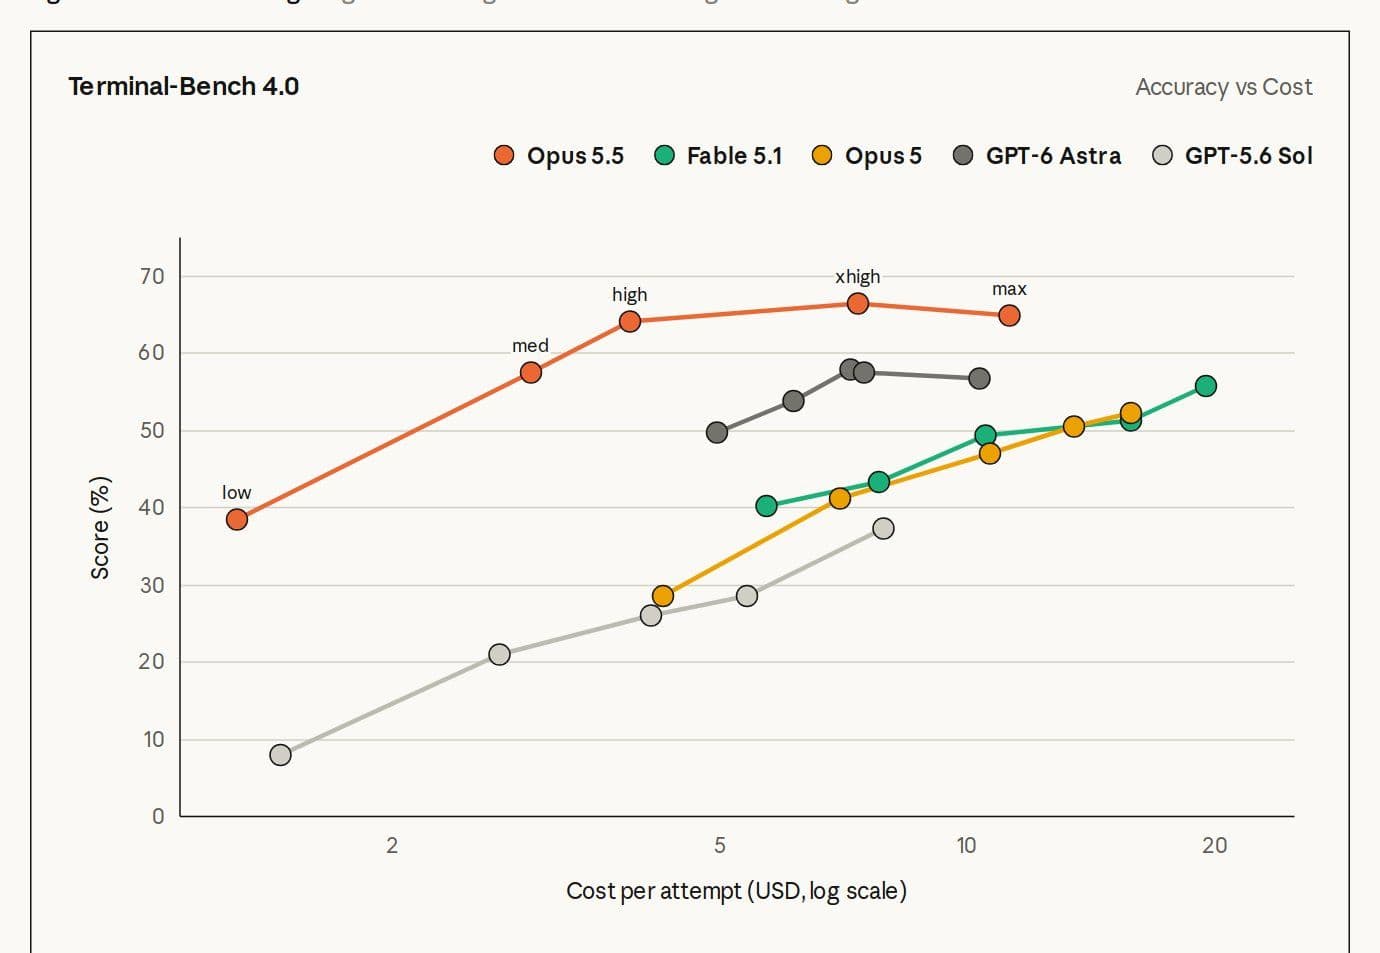
Условия замера важны. Opus 5.5 проверяли на максимальном уровне усилий рассуждений, в Terminal-Bench 4.0 — на уровне xhigh; GPT-6 Astra — на уровне high, по данным OpenAI. AutomationBench считала компания Zapier. Защитные механизмы Opus 5.5 во время замеров оставались включены: когда они срабатывали, задачи по кибербезопасности выполняла Opus 4.8, а по биологии и разработке ИИ — Opus 5. По оценке Anthropic, из-за этого часть баллов Opus 5.5 занижена.
Где Claude Opus 5.5 сильнее GPT-6 Astra?
Opus 5.5 сильнее в агентном программировании, офисной работе и междисциплинарных рассуждениях. Разберём по порядку.
Программирование
Среди тестов на программирование сильнее всего Opus 5.5 отрывается от GPT-6 Astra в Terminal-Bench 4.0, где модель сама работает в терминале: 66,4% против 57,9% у Astra и 37,3% у GPT-5.6 Sol. В FrontierCode, другом тесте на агентное программирование, модели идут почти вровень: 54,4% против 53,3%. В CursorBench 4.0, где проверяют работу в редакторе кода, Opus 5.5 набрала 57,8% против 41,7% у Sol; результата Astra здесь нет.
На практике это значит, что длинные задачи с запуском команд, прогоном тестов и правкой нескольких файлов — сильная сторона Opus 5.5. Сценарии и готовые промпты для разработки собраны в гайде Claude Opus 5.5 для программирования.
Офисная работа
В GDPval-AA, где проверяют офисные задачи из 44 профессий, отрыв большой: 1846 пунктов Elo у Opus 5.5 против 1542 у GPT-6 Astra и 1588 у GPT-5.6 Sol. Elo здесь — сравнительный рейтинг: чем он выше, тем выше оценили работу модели. Любопытная деталь — здесь Sol обходит Astra, и это единственный такой случай в таблице. Для отчётов, служебных записок, таблиц и презентаций это главный аргумент в пользу Opus 5.5.
Рассуждения
В Humanity's Last Exam — трудных вопросах из разных областей знаний, которые модели решают с инструментами, — у Opus 5.5 67,7% против 57,2% у GPT-6 Astra. Это 10,5 пункта разницы, самый большой разрыв этой пары среди процентных тестов таблицы; результата Sol здесь нет. Ещё в двух тестах, OSWorld 2.0 (управление компьютером) и Chartography (распознавание графиков), данных по моделям OpenAI нет, так что сравнивать там не с чем: у Opus 5.5 81,8% и 89,0%.
Где GPT-6 Astra сильнее Claude Opus 5.5?
GPT-6 Astra впереди в двух тестах: AutomationBench, где проверяют бизнес-автоматизации, и Terminal-Bench-Science, где модель решает научные задачи в терминале.
В AutomationBench разница небольшая: 41,4% у GPT-6 Astra против 40,0% у Opus 5.5 — почти паритет, но перевес на стороне OpenAI. Этот тест считала не Anthropic, а Zapier. В Terminal-Bench-Science отрыв заметнее: 64,6% против 58,7%. GPT-5.6 Sol в обоих тестах далеко позади — 28,8% и 22,4%.
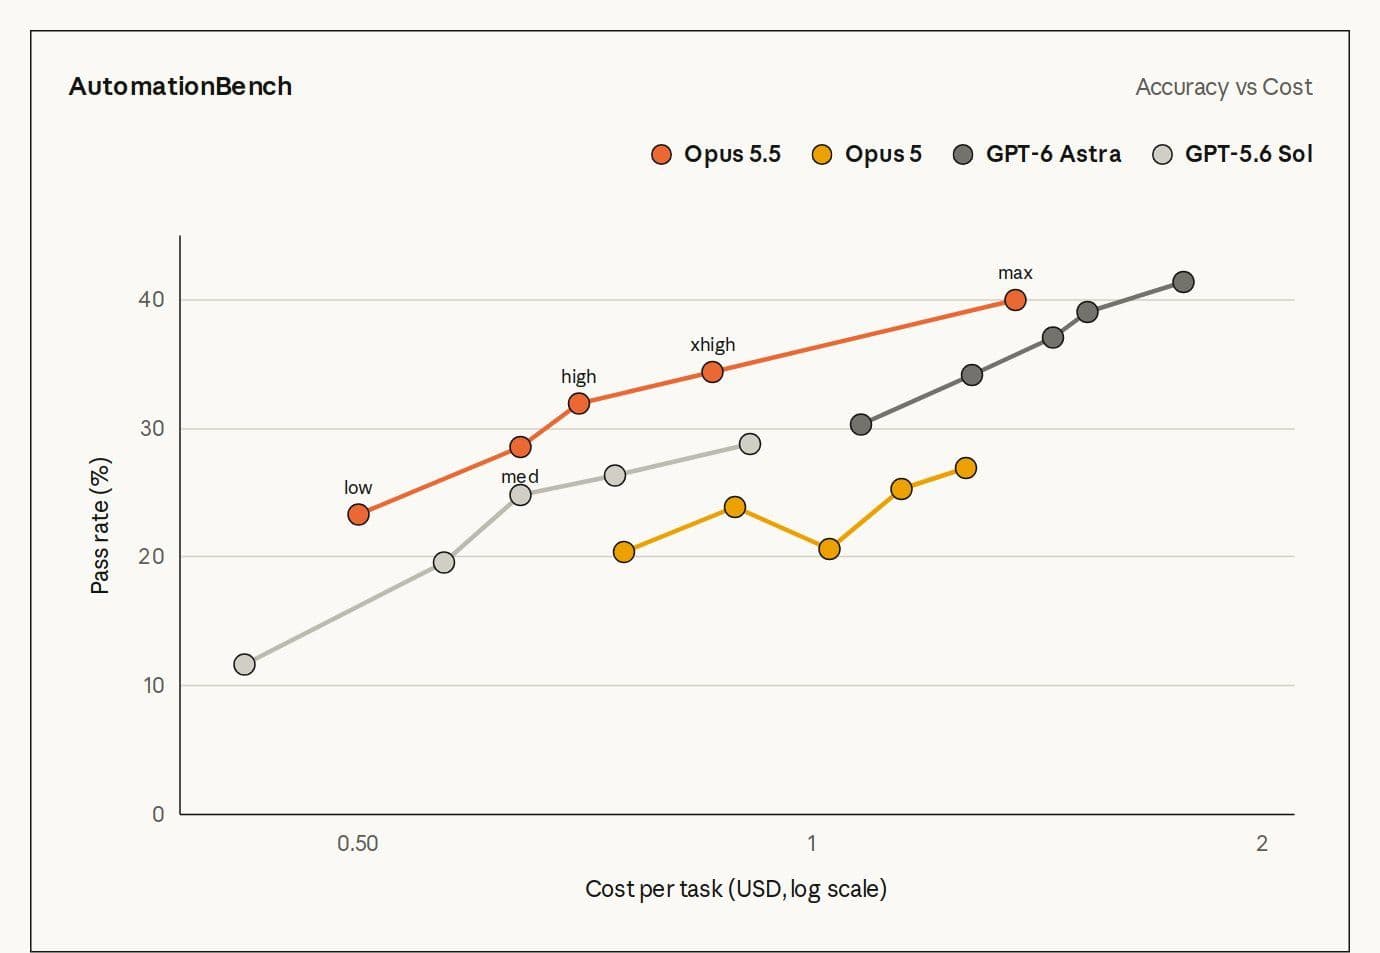
Если ваша задача — автоматизация бизнес-процессов или научные расчёты в терминале, начните с GPT-6 Astra, а Opus 5.5 держите для сверки. К тому же Astra открывается уже с тарифа СТАРТ.
Стоит ли выбирать GPT-5.6 Sol?
По этим данным — только если нужна именно она: GPT-5.6 Sol отстаёт от Opus 5.5 во всех тестах, где есть её результаты, и от GPT-6 Astra — везде, кроме GDPval-AA. Sol и Opus 5.5 открываются с одного тарифа Про, и на этом тарифе сильнее Opus 5.5; на СТАРТе из флагманов OpenAI доступна GPT-6 Astra. Как соотносилось прошлое поколение — в материале Claude Opus 5 против GPT-5.6.
Какая модель экономнее: Opus 5.5 или GPT-6 Astra?
По данным Anthropic, Opus 5.5 добивается того же или лучшего результата заметно дешевле GPT-6 Astra: в разных тестах — от примерно пятой части до 40% её стоимости. Сравнения такие:
- FrontierCode: на уровне усилий по умолчанию Opus 5.5 обходит GPT-6 Astra, тратя примерно 20% её стоимости на задачу.
- Terminal-Bench 4.0: догоняет GPT-6 Astra примерно за 40% стоимости.
- GDPval-AA: на уровне medium, который у Anthropic стоит по умолчанию, обходит GPT-6 Astra на максимальном уровне примерно за пятую часть стоимости задачи.
- CursorBench: обходит GPT-5.6 Sol на 11 пунктов примерно за треть его стоимости.
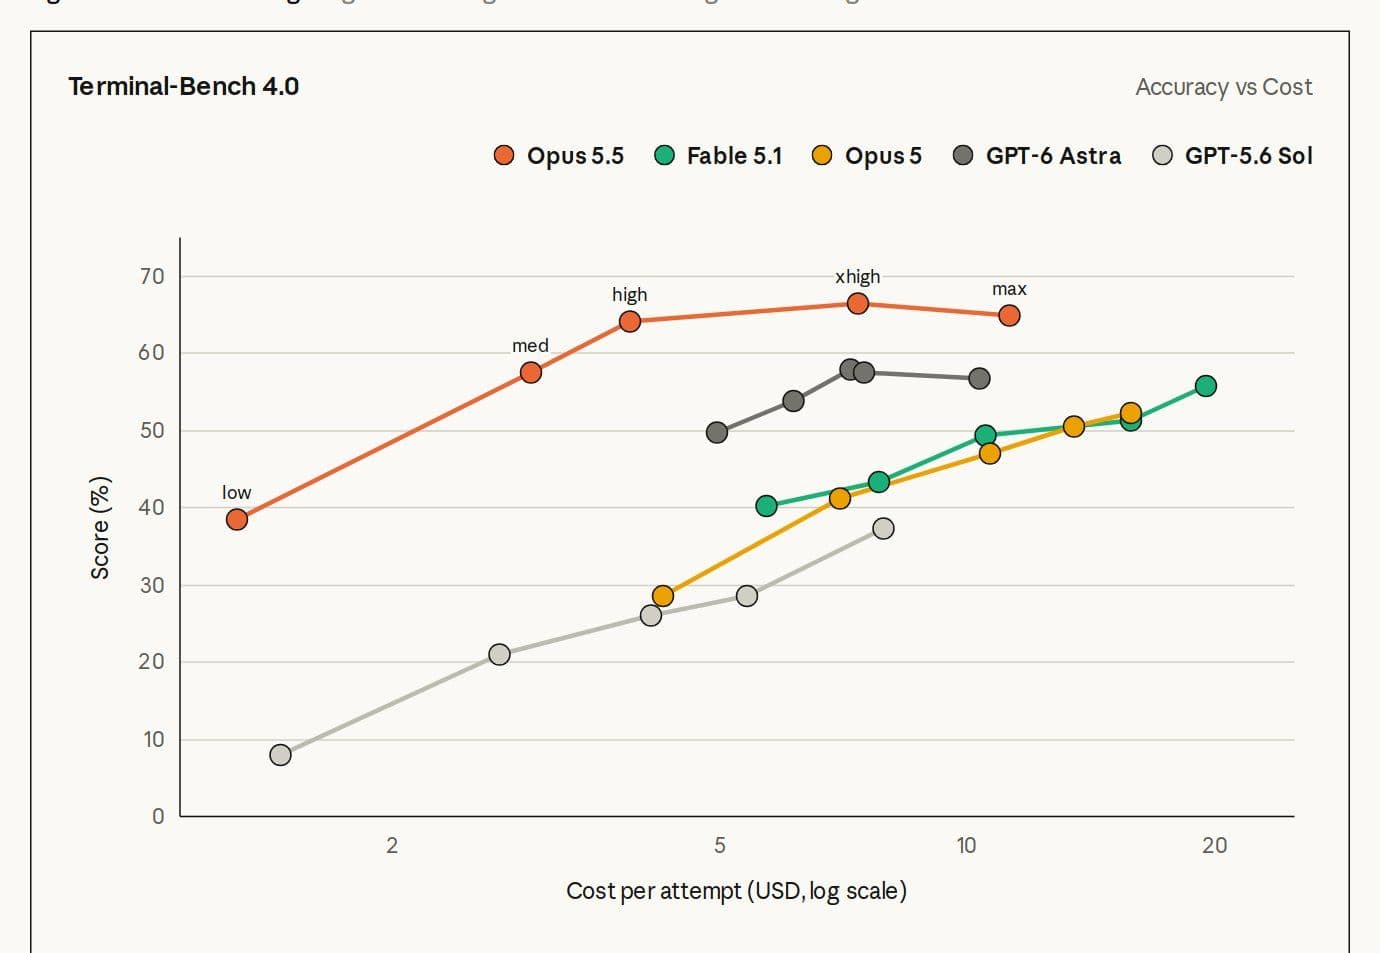
Эти сравнения взяты с графиков «качество — стоимость попытки» и сделаны на конкретных уровнях усилий, часто на уровне по умолчанию. Поэтому разрывы в них не совпадают с таблицей выше, где Opus 5.5 работала на максимальном уровне.
Для работы в СуперИнтеллекте экономичность важна напрямую: оплата идёт «нейронами», а их расход зависит от числа токенов. Проценты Anthropic посчитаны по стоимости обращений к моделям на стороне разработчика, и в нейронах пропорция может быть другой, но правило общее: чем меньше токенов модель тратит на задачу, тем меньше нейронов уходит.
Можно ли доверять этим цифрам?
Доверять можно, но с поправкой: это данные одной стороны. Вот что стоит держать в голове:
- Таблицу и графики опубликовала Anthropic вместе с выходом собственной модели. Результаты GPT-6 Astra и GPT-5.6 Sol взяты из отчётов OpenAI, а не получены в одном общем замере.
- Модели сравнивают на разных уровнях усилий: Opus 5.5 — на максимальном (в Terminal-Bench 4.0 — на xhigh), GPT-6 Astra — на high.
- Часть баллов Opus 5.5 занижена из-за срабатывания защитных механизмов — так считает сама Anthropic.
- Anthropic признаёт, что на таком уровне разрыв в баллах всё хуже отражает разницу в реальной работе.
- AutomationBench считала не Anthropic, а Zapier, и там впереди как раз GPT-6 Astra.
Вывод простой: таблица показывает направление, а выбор под свою работу надёжнее проверить самому.
Где попробовать Claude Opus 5.5 и GPT-6 Astra в России?
В СуперИнтеллекте все три модели работают в одном окне чата — в России, без VPN и зарубежной карты.
- GPT-6 Astra — с тарифа СТАРТ.
- Claude Opus 5.5 — с тарифа Про и на старших тарифах: ULTRA и командных. В каталоге модель появилась в день выхода, 22 сентября 2026 года.
- GPT-5.6 Sol — с тарифа Про.
Если закрепить в чате или агенте псевдоним Claude Opus Latest, он всегда будет вести на свежую Opus — сейчас это уже 5.5, и при выходе следующей версии ничего перенастраивать не придётся. В чат можно прикладывать файлы, изображения и документы, а уровень усилий рассуждений Opus 5.5 выбирается прямо в чате. Регистрация бесплатная: создать аккаунт.
Как сравнить Opus 5.5 и GPT-6 Astra на своей задаче?
Отправьте один и тот же запрос двум моделям и сравните ответы по критериям, выписанным заранее. Так вы проверите не чужой бенчмарк, а собственную работу.
- Возьмите реальную задачу, которую вы и так делаете: фрагмент кода с ошибкой, выгрузку для отчёта, договор для разбора. Искусственные загадки мало говорят о повседневной пользе.
- Откройте два чата и отправьте в них одинаковый запрос с одинаковыми файлами: в первом — Claude Opus 5.5, во втором — GPT-6 Astra. Так вторая модель не увидит ответ первой. Если продолжаете работу в одном чате, модель переключается одним кликом, а промпт переписывать не нужно.
- Для Opus 5.5 начните с уровня medium — на нём Anthropic делала часть сравнений по стоимости. Поднимайте уровень, только если ответ не устроил. Как устроены уровни, рассказано в гайде как пользоваться Claude Opus 5.5.
- Сравните результаты по своим критериям: верны ли факты и цифры, запускается ли код, сколько правок понадобилось и сколько нейронов ушло.
Промпт для сравнения двух моделей на одной задаче
Задача: [опишите задачу и приложите файлы].

Требования к ответу:
— Сначала дай короткий итог, потом подробности.
— Каждую цифру и каждый факт сопровождай указанием, где именно в приложенных файлах ты их нашёл. Если данных нет, прямо напиши «нет данных» и ничего не додумывай.
— Если в задаче есть неоднозначность, перечисли свои допущения отдельным списком.
— В конце перечисли, что человеку стоит перепроверить перед использованием результата.
Отправьте этот промпт обеим моделям и сравните: кто точнее опирается на файлы, у кого меньше допущений без предупреждения и чей ответ пришлось меньше править. Если победитель очевиден, закрепите его за этим типом задач и переключайтесь на другую модель, только когда задача меняется.