
Новости
Claude Opus 5.5 вышел и уже доступен в СуперИнтеллекте
22 сентября Anthropic выпустила Claude Opus 5.5 — первую модель семейства Claude 5.5. По данным разработчика, она работает на уровне Fable 5.1, отвечает быстрее Opus 5 и тратит меньше токенов на ту же задачу. Модель уже в чате СуперИнтеллекта — без VPN и зарубежной карты.
Команда СуперИнтеллекта · · ~7 мин
Claude Opus 5.5 — новая флагманская модель Anthropic, представленная 22 сентября 2026 года. Это первая модель семейства Claude 5.5 и преемница Claude Opus 5. По данным Anthropic, на большинстве задач она работает на уровне старшей Claude Fable 5.1, при этом отвечает быстрее Opus 5 и расходует заметно меньше токенов на ту же работу. В СуперИнтеллекте модель появилась в день выхода: её можно выбрать в чате — в России, без VPN и без зарубежной карты.
Что такое Claude Opus 5.5?
Claude Opus 5.5 — старшая модель линейки Opus, рассчитанная на сложные рассуждения, программирование и долгую автономную работу агентов. Anthropic выпустила её как начало нового семейства Claude 5.5: младшие Sonnet 5.5 и Haiku 5.5 обещаны в ближайшие недели.
Контекстное окно — 1 000 000 токенов, один ответ может достигать 128 000 токенов. На вход модель принимает текст, изображения и файлы, на выход выдаёт текст. Глубину рассуждений можно выбирать: в чате доступны пять уровней усилий — от быстрого low до самого тщательного max.
Что нового в Claude Opus 5.5 по сравнению с Opus 5?
Главное изменение — не столько рост баллов, сколько эффективность: модель приходит к тому же результату за меньшее число шагов и токенов. Вот что Anthropic выделяет в анонсе:
- Качество уровня Fable 5.1. На большинстве рабочих задач Opus 5.5 не уступает старшей модели Anthropic, хотя относится к более массовой линейке Opus.
- Экономнее. По оценке Anthropic, на типичных задачах при настройках по умолчанию работа с моделью обходится примерно на 40% дешевле, чем с Opus 5: она тратит меньше токенов, а сами токены подешевели.
- Быстрее. Текст ответа генерируется более чем на 30% быстрее, чем у Opus 5.
- Сильнее в больших проектах. Модель уверенно ведёт длинные задачи на всю кодовую базу — миграции, аудит, рефакторинг — и реже требует переделок.
- Понятнее пишет. Главное выносит в первые строки, реже злоупотребляет жаргоном и точнее следует правилам оформления, которые вы задаёте.
- Безопаснее. Лучший результат среди моделей Anthropic на внутреннем аудите поведения и заметно выше устойчивость к атакам через подмену инструкций (prompt injection).
Какие результаты Claude Opus 5.5 показывает в тестах?
Anthropic сравнила Opus 5.5 со своими Fable 5.1 и Opus 5, а также с GPT-6 Astra и GPT-5.6 Sol от OpenAI. Новая модель лидирует в агентном программировании, управлении компьютером и офисной аналитике. Ниже — результаты трёх моделей Anthropic по данным разработчика.
| Тест | Что проверяет | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | агентное программирование в терминале | 66,4% | 55,8% | 52,3% |
| FrontierCode v1.1 | агентное программирование | 54,4% | 50,3% | 48,0% |
| CursorBench 4.0 | работа в редакторе кода | 57,8% | 51,8% | 46,6% |
| GDPval-AA v2.1 | офисная работа в 44 профессиях, Elo | 1846 | 1735 | 1708 |
| AutomationBench | бизнес-автоматизации | 40,0% | 31,4% | 26,9% |
| Humanity's Last Exam | междисциплинарные рассуждения, с инструментами | 67,7% | 65,6% | 63,6% |
| Terminal-Bench-Science 0.1 | научные задачи в терминале | 58,7% | 52,6% | 29,0% |
| OSWorld 2.0 | управление компьютером | 81,8% | 80,7% | 74,0% |
| Chartography | распознавание графиков, с инструментами | 89,0% | 88,4% | 83,4% |
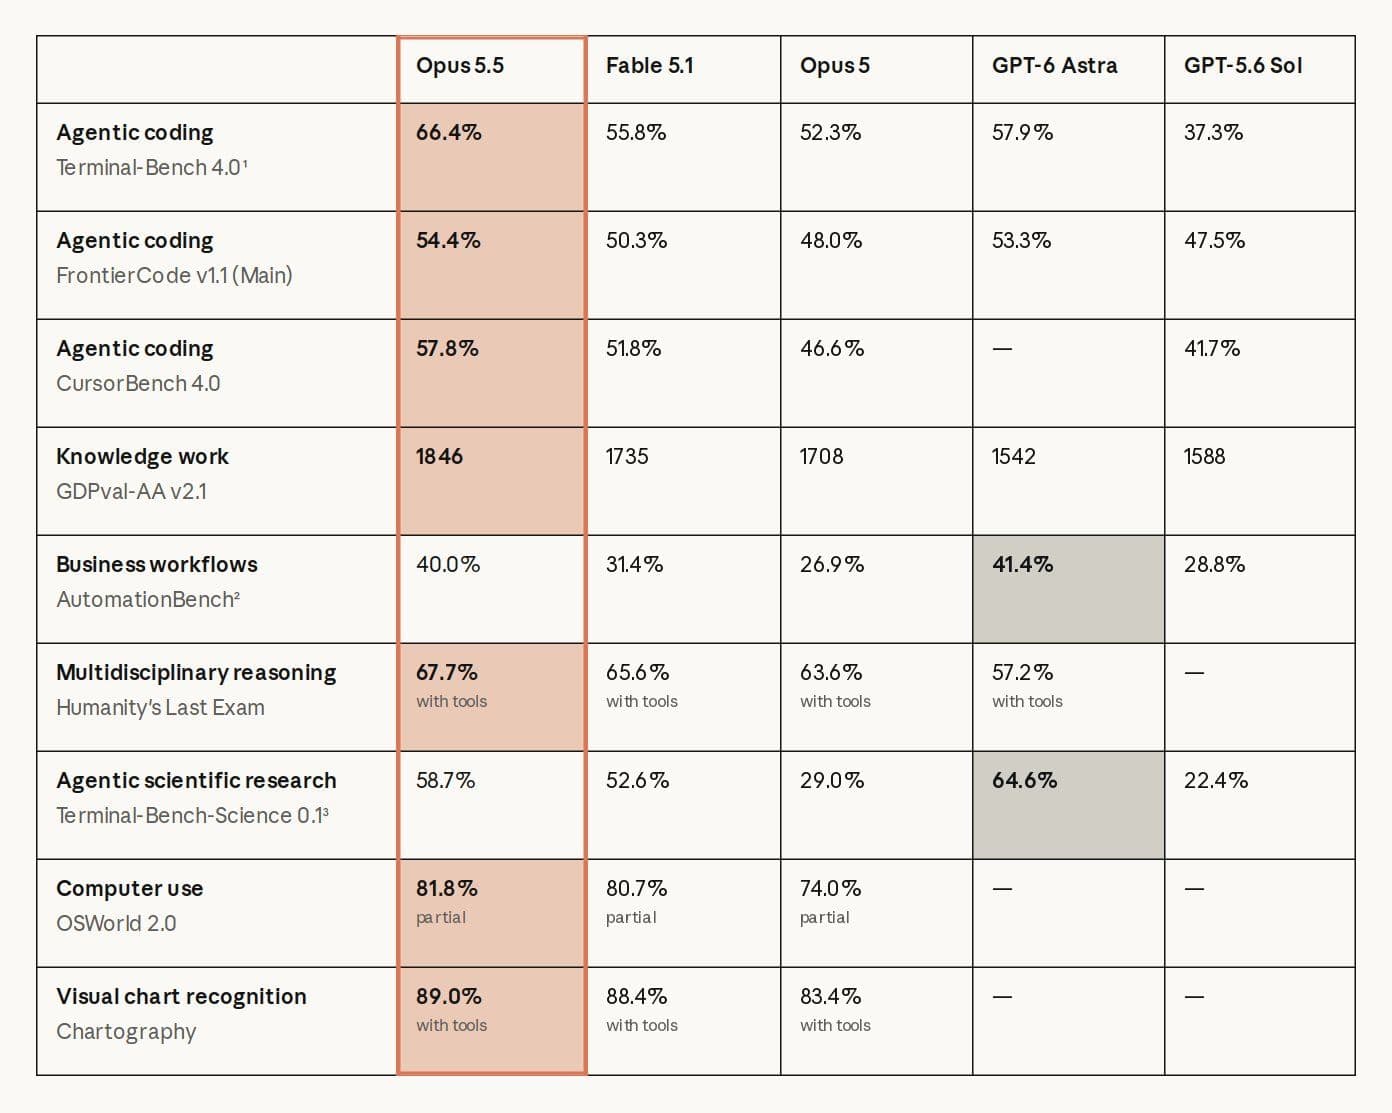
Честная оговорка: не во всех тестах Opus 5.5 первая. На AutomationBench (бизнес-автоматизации) и Terminal-Bench-Science (научные задачи в терминале) впереди GPT-6 Astra. Кроме того, Anthropic сама признаёт: на таком уровне разрыв в баллах всё хуже отражает разницу в реальной работе, и в её собственном использовании отставание Fable 5.1 от Opus 5.5 меньше, чем в таблице.
Почему Opus 5.5 выгоднее Opus 5?
Экономия складывается из двух частей. Во-первых, Anthropic снизила базовую стоимость токенов. Во-вторых — и это важнее — модель тратит их меньше: собирает контекст один раз, делает меньше и более полных правок и не зацикливается на повторах. В СуперИнтеллекте оплата идёт «нейронами», а их расход напрямую зависит от числа токенов, поэтому меньше токенов на задачу — меньше нейронов.
Anthropic приводит несколько показательных примеров. Аудит и исправление кодовой базы на 200 000 строк Opus 5.5 закончила меньше чем за три часа — у Opus 5 та же работа заняла больше двадцати. При переводе балансировщика нагрузки HAProxy с C на Rust модель справилась за 9,5 часа против 12 у Fable 5.1. А финансовый анализ слияния двух компаний с моделью в Excel и презентацией для руководства занял 63 минуты против 93 у предшественницы.
В каких задачах Claude Opus 5.5 особенно сильна?
- Программирование на всю кодовую базу — миграции, аудит, рефакторинг и перенос кода на другой язык. Один из ранних тестировщиков провёл миграцию на 680 000 строк быстрее чем за сутки.
- Исследования по открытым источникам. В тесте Anthropic модель писала отчёт о квартальных результатах компании по данным из веба: 16 из 18 отчётов прошли проверку без единой выдуманной цифры, у Fable 5.1 и Opus 5 — ни одного.
- Финансы и аналитика — модели в таблицах, презентации для руководства, проверка допущений в исходных данных.
- Долгая автономная работа агентов — модель держит задачу много часов и эффективнее передаёт части работы субагентам.
Ранние пользователи говорят о том же. В GitHub отметили, что в Copilot CLI и VS Code Opus 5.5 обходилась одним из самых малых объёмов токенов и шагов среди всех проверенных моделей, а в Lovable — что приложения собираются за треть или половину прежних шагов при том же качестве.
Как изменился стиль ответов Claude Opus 5.5?
Частая претензия к Opus 5 — многословные и тяжёлые для чтения ответы. В Opus 5.5 Anthropic исправила именно это: модель сначала даёт вывод, потом детали, избегает профессионального жаргона там, где он не нужен, и соблюдает заданные правила письма. В длинных рабочих сессиях это заметная разница: результат проще проверить глазами и быстрее передать дальше.
Что с безопасностью Claude Opus 5.5?
До выпуска модель проверили внешние организации, включая METR. На автоматическом аудите поведения — почти 2 000 смоделированных сценариев — Opus 5.5 показала лучший результат среди моделей Anthropic. Она реже предпринимает трудно обратимые действия, лучше соблюдает заданные границы и устойчивее к попыткам подменить инструкции через содержимое страниц и файлов.
Для Opus 5.5 Anthropic включила защитные механизмы того же класса, что у Fable 5.1. Обычная работа с кодом — поиск и исправление ошибок — идёт как обычно, а большинство задач по кибербезопасности модель прозрачно передаёт более ранней Opus 4.8. Работа с биологическими исследованиями открыта только проверенным организациям.
Как попробовать Claude Opus 5.5 в СуперИнтеллекте?
- Откройте чат СуперИнтеллекта — зарегистрироваться можно бесплатно.
- Нажмите на название модели под полем ввода и выберите Claude Opus 5.5 — модель доступна с тарифа Про.
- При необходимости настройте глубину рассуждений: для быстрых задач хватит low или medium, для сложного кода и анализа — high и выше.
- Задайте вопрос или приложите файлы — модель читает текст, изображения и документы.
Что дальше?
Anthropic пообещала в ближайшие недели выпустить Claude Sonnet 5.5 и Claude Haiku 5.5 с теми же улучшениями в качестве, эффективности и безопасности. Мы добавим их в СуперИнтеллект по мере выхода.