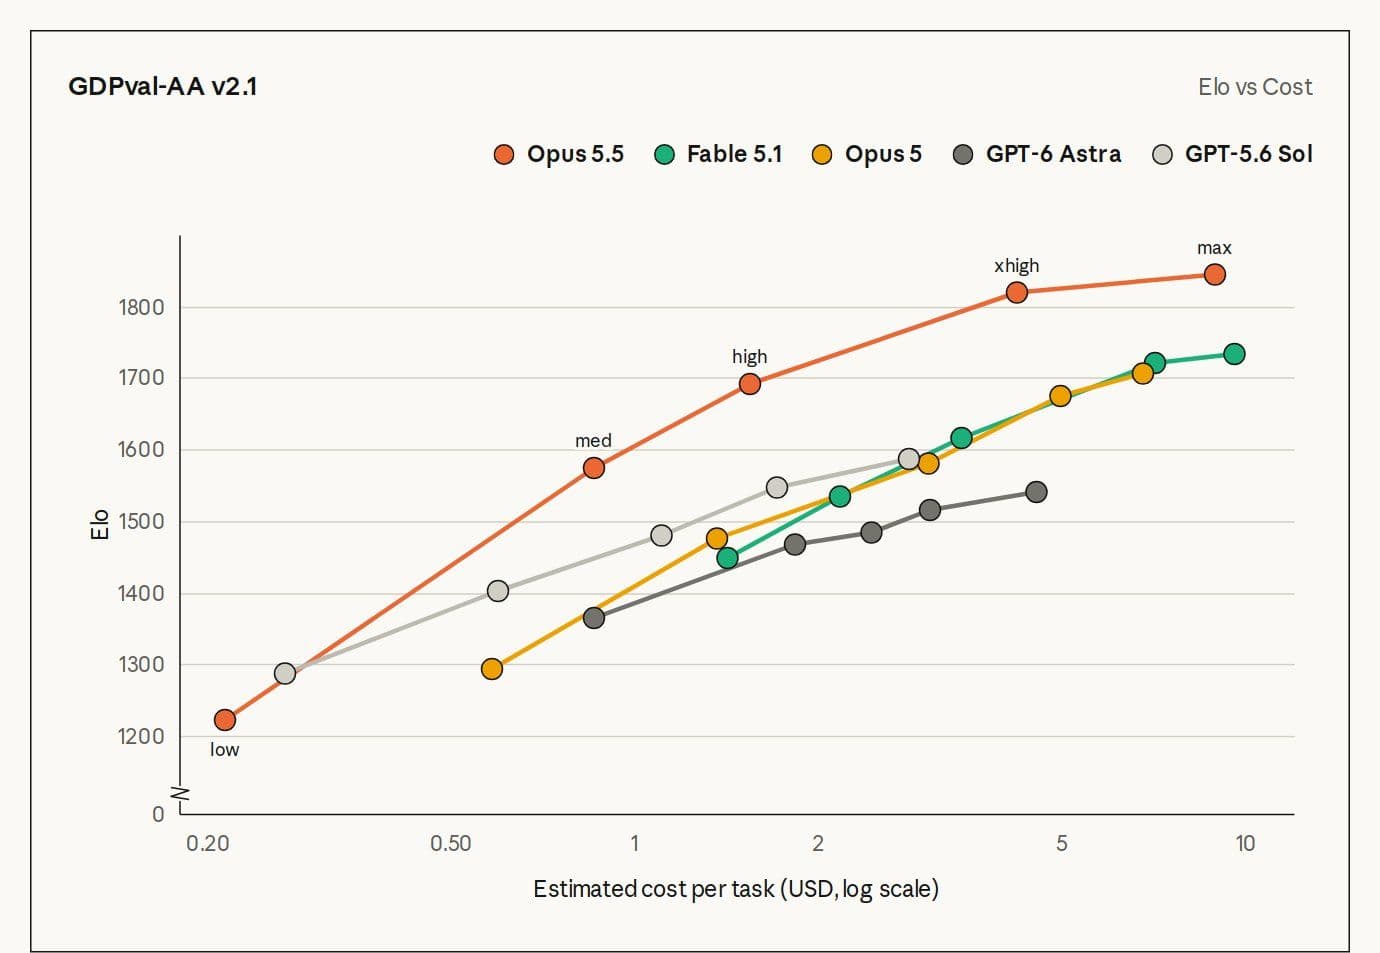
Claude Opus 5.5 для аналитики — сейчас самый сильный выбор среди моделей Claude: в тесте офисной работы GDPval-AA v2.1, который охватывает задачи 44 профессий, она набрала 1846 Elo против 1735 у Claude Fable 5.1 и 1708 у Claude Opus 5. Модель вышла 22 сентября 2026 года и в тот же день появилась в каталоге СуперИнтеллекта. Но для аналитика важнее баллов другое: в проверке на отчётах о квартальных результатах 16 из 18 её отчётов прошли контроль без единой выдуманной цифры или цитаты — у Fable 5.1 и Opus 5 не прошёл ни один.
Ниже — практический разбор: что модель делает лучше предшественниц в работе с документами и таблицами, где она уступает конкурентам, какой уровень усилий выбирать, как проверять результат и семь промптов, которые можно взять и использовать. Общий разбор возможностей — в обзоре Claude Opus 5.5, пошаговая инструкция по работе — в материале как пользоваться Claude Opus 5.5.
Почему Opus 5.5 хороша именно в офисной и аналитической работе?
Потому что сильнее всего она прибавила там, где работа состоит из документов, таблиц и выводов, а не из кода. GDPval-AA v2.1 сравнивает модели на задачах 44 профессий, и здесь Opus 5.5 набрала 1846 Elo, больше всех проверенных моделей: у Fable 5.1 — 1735, у Opus 5 — 1708, у GPT-5.6 Sol — 1588, у GPT-6 Astra — 1542.
Рядом с этим стоят тесты, которые ближе к ежедневной работе аналитика: междисциплинарные рассуждения с инструментами (Humanity's Last Exam) — 67,7%, чтение графиков (Chartography) — 89,0%, управление компьютером (OSWorld 2.0) — 81,8%. В бизнес-автоматизациях (AutomationBench, замер проводил Zapier) у Opus 5.5 40,0% против 26,9% у Opus 5 — но первое место здесь не за ней: GPT-6 Astra набирает 41,4%. В научных задачах в терминале она тоже уступает: 58,7% против 64,6%. Зато в сборе больших объёмов данных (WANDR) и в бизнес-процессах, по данным Anthropic, Opus 5.5 лидирует.
| Тест | Что проверяет | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| GDPval-AA v2.1 | офисная работа в 44 профессиях, Elo | 1846 | 1735 | 1708 | 1542 |
| AutomationBench | бизнес-автоматизации | 40,0% | 31,4% | 26,9% | 41,4% |
| Humanity's Last Exam | рассуждения с инструментами | 67,7% | 65,6% | 63,6% | 57,2% |
| Chartography | распознавание графиков, с инструментами | 89,0% | 88,4% | 83,4% | — |
| OSWorld 2.0 | управление компьютером | 81,8% | 80,7% | 74,0% | — |
Условия важны. Результаты Opus 5.5 получены на максимальном уровне усилий и со включёнными защитными механизмами: когда они срабатывали, часть задач выполняли другие модели Claude, и Anthropic признаёт, что это занижает отдельные баллы. Показатели GPT-6 Astra приведены при высоком уровне усилий по данным OpenAI, вся остальная таблица — замеры самой Anthropic. И ещё одна оговорка, которую делает сам разработчик: на таком уровне разрыв в баллах всё хуже отражает разницу в реальной работе — в её собственном использовании отставание Fable 5.1 от Opus 5.5 меньше, чем выглядит в таблице.
Выдумывает ли Opus 5.5 цифры и цитаты?
Заметно реже предшественниц — и это главное, что меняет её ценность для аналитика. Anthropic проверяла модели на трудном задании: составить отчёт о квартальных результатах компании по копии веб-страниц, где сам пресс-релиз найти непросто. 16 из 18 отчётов Opus 5.5 прошли проверку без единой выдуманной цифры или цитаты. У Fable 5.1 и Opus 5 таких отчётов не было вообще.
Разница здесь качественная, а не количественная. Модель, которая при нехватке данных дорисовывает правдоподобное число, бесполезна в аналитике: проверять за ней приходится всё, и выигрыш во времени исчезает. Модель, которая пишет «этого нет в источнике», экономит работу даже тогда, когда ошибается в остальном. Практический вывод простой: в задании прямо требуйте помечать недостающее, а не восполнять его.
Замечает ли модель ошибки в самом задании?
Да, и это отдельно проверяли в инвестиционной компании Walleye Capital. На самом низком уровне усилий модель в основном решила их набор задач, а на высоких — заметила ошибку в самих инструкциях и учла её при работе.
Для аналитика это важнее, чем скорость. Ошибка в постановке — не в расчёте — обычно и стоит дороже всего: неверно заданный период, перепутанный знак, допущение, которое противоречит данным в той же таблице. Модель, которая молча выполняет заведомо неверное задание, производит аккуратно оформленный мусор. Поэтому в промпт стоит встраивать явное разрешение спорить: «если в задании есть противоречие, скажи об этом первым делом и не подстраивайся под него».
Что Opus 5.5 даёт финансовому аналитику?
Резкий рост на сквозных финансовых процессах — когда задача идёт от исходных документов до готового результата без разбивки на мелкие шаги. В Hebbia, где такие процессы и измеряют, Opus 5.5 выполнила 86,6% требований против 60,3% у Opus 5.
Второе наблюдение касается расхода. В Rogo модель на самом низком уровне усилий обошла Opus 5 на высоком, выдав примерно на 60% меньше выходных токенов. В Box отмечают треть токенов относительно Opus 5 и ответы на 40% короче без потери точности. Для работы с оплатой по токенам это значит, что за одну и ту же задачу вы отдаёте меньше нейронов, а читать результат быстрее: главное вынесено в начало, лишних оборотов меньше — многословность была основной претензией к Opus 5, и её чинили целенаправленно.
Что из этого следует на практике: начинайте разбор отчётности и проверку моделей на низком уровне усилий, поднимайте его только там, где задача действительно длинная или требует сверки многих источников.
Чем она помогает в консалтинге и проверке документов?
Находит дефекты, которые прежние модели пропускали, и делает это на более дешёвом режиме. В Deloitte сравнивали модели на ревью кода: Opus 5.5 на самом низком уровне усилий нашла 72% известных ошибок, Opus 5 на высоком — 56%. Это про код, а не про аудит договоров, и переносить процент на свою работу нельзя — ценен здесь сам вывод об уровнях усилий.
Похожие наблюдения есть и в аналитических командах. В Quantium задача, которая раньше занимала 38 промптов за четыре дня, уложилась в 11 промптов за три часа. В Column модель нашла в счёте за облако экономию, которую прежние версии не замечали. Общий мотив один: выигрыш появляется не в отдельном ответе, а на длинной задаче, где раньше приходилось много раз переспрашивать и переделывать.
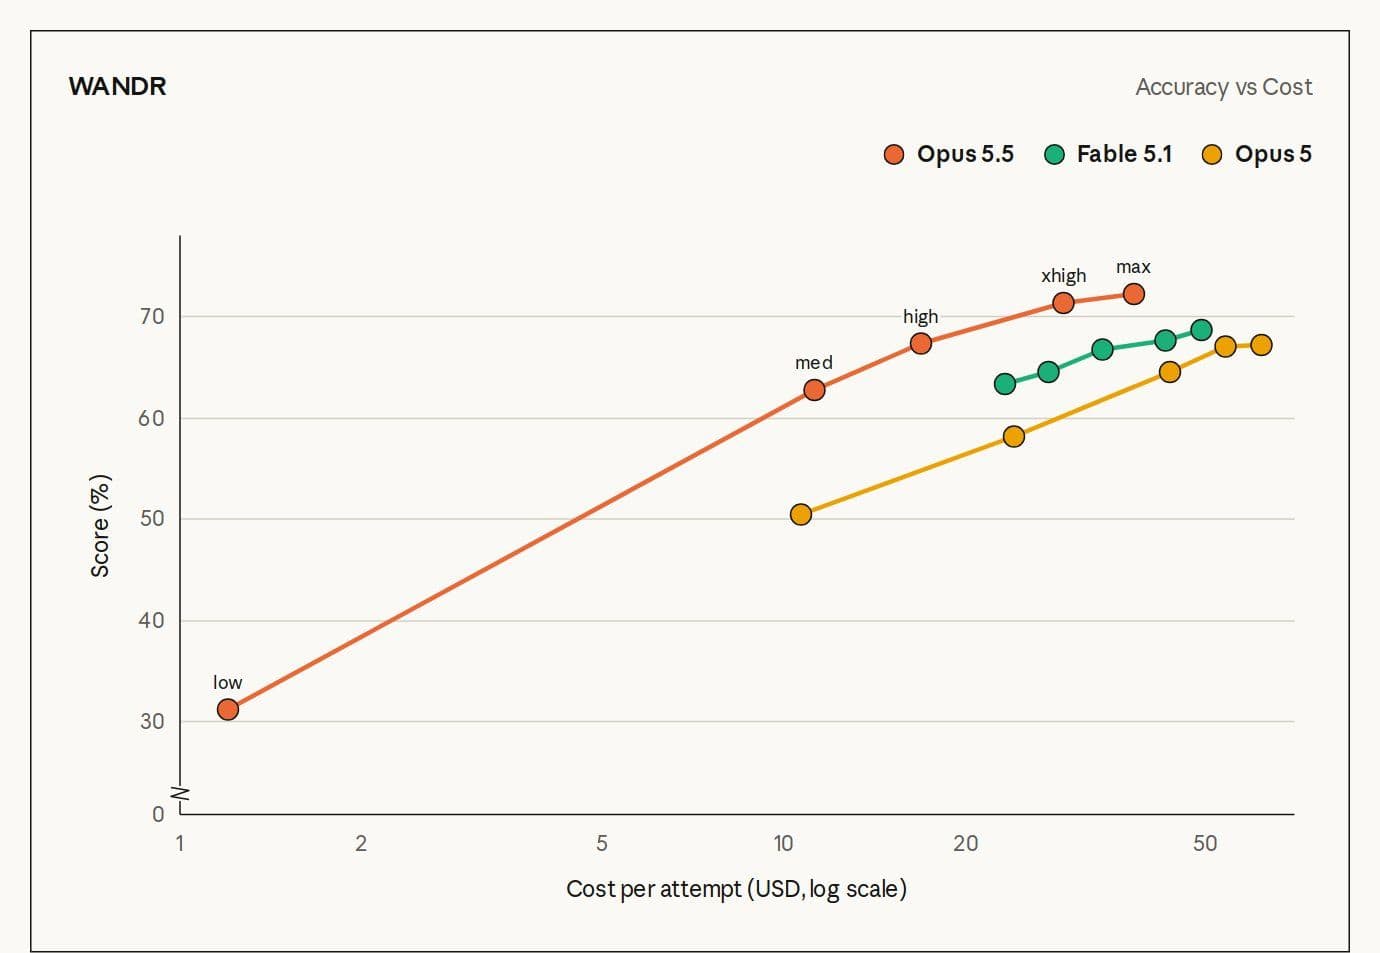
Отдельная сильная сторона — сбор данных. WANDR проверяет именно это: найти и свести большой объём разрозненной информации. По данным Anthropic, Opus 5.5 здесь впереди — что напрямую ложится на конкурентный анализ, обзоры рынка и подготовку материалов к сделке.
Как выглядит большая задача целиком: финансовая модель и презентация?
Anthropic показывает именно такой сценарий: анализ слияния двух вымышленных HR-компаний, где нужно было собрать модель в Excel и подготовить презентацию. Выводы Opus 5.5 и Opus 5 совпали, но модель у 5.5 оказалась тщательнее, презентация — понятнее, а у Opus 5 нашлись мелкие ошибки. По времени — 63 минуты против 93, и вдвое дешевле по расходу.
Повторить такой сценарий в чате можно по шагам — так проще поймать расхождение до того, как оно уедет в презентацию.
- Приложите исходные документы и данные одним сообщением: отчётность, выгрузки, условия сделки. Контекст в миллион токенов позволяет не резать их на части.
- Сначала попросите не расчёт, а список допущений и структуру модели — по листам и блокам. Согласуйте их, прежде чем считать.
- Запросите расчёт с отдельным блоком формул: какая цифра откуда берётся. Это нужно, чтобы проверять не итог, а способ его получения.
- Пересчитайте вручную две-три ключевые цифры. Если сошлись — вероятность системной ошибки резко падает.
- Только после этого просите структуру презентации: заголовки-утверждения, опорные тезисы, какая цифра каждый из них подтверждает.
- Финальную сборку слайдов делайте у себя. Модель отвечает текстом — она даёт структуру, формулировки и разметку, а не готовый файл презентации.
Какой уровень усилий выбирать для аналитики?
Начинайте с низкого — по данным Rogo и Deloitte, именно на нём Opus 5.5 обходит Opus 5 в её самом дорогом режиме. Всего уровней пять: low, medium, high, xhigh, max; у Anthropic по умолчанию стоит medium, а в СуперИнтеллекте уровень выбирается прямо в чате.
- Низкий — разбор одного документа, сводка, черновик таблицы, перевод материалов в структуру. У Walleye Capital модель уже на этом уровне в основном справилась с их набором задач.
- Средний — обычная рабочая нагрузка: сравнение нескольких источников, расчёты, записка для руководства. Это уровень по умолчанию у самой Anthropic.
- Высокий и выше — длинные цепочки и сверка множества источников. Именно на высоких уровнях модель заметила ошибку в инструкциях в наборе задач Walleye Capital, так что для проверки чужих моделей и допущений смысл поднимать уровень есть.
Объём работы уровнем не ограничен: контекст — миллион токенов, ответ — до 128 тысяч. Годовой отчёт целиком, десяток выгрузок и переписка по сделке помещаются в один разговор. На вход идут текст, изображения и файлы; на выходе — только текст, поэтому графики модель не рисует, но даёт таблицу, разметку или код для построения.
Как проверять то, что модель выдала?
Проверка должна быть встроена в задание, а не пристроена после. Шесть приёмов, которые реально ловят ошибки.
- Требуйте источник у каждой цифры — страницу, раздел, имя файла. Утверждение без адреса в отчёте не живёт.
- Пересчитывайте вручную две-три ключевые цифры, от которых зависит вывод. Это дешевле полной перепроверки и почти так же надёжно.
- Просите отдельный список: что взято из документов, что посчитано самой моделью (с формулой), что является оценкой.
- Задавайте контрольный вопрос, ответа на который в материалах заведомо нет. Правильная реакция — «нет в документе», а не правдоподобное число.
- Сверяйте важное с первоисточником, а не с пересказом модели — особенно цитаты, даты и юридические формулировки.
- Для повторяющихся задач держите эталонный пример разбора и просите модель следовать его формату: так расхождения видно сразу.
И помните про честные границы: все приведённые цифры — замеры самой Anthropic и её клиентов, условия у каждого свои. Anthropic отдельно оговаривает, что модель часто подозревает, будто её тестируют, — это усложняет оценку её поведения в реальных условиях. Проверка на ваших собственных задачах ничем не заменяется: возьмите три архивных разбора, где ответ известен, и сравните.
Какие промпты работают для аналитической работы?
Ниже семь готовых промптов. Они написаны под одну логику: сначала структура и допущения, потом расчёт, и обязательное требование помечать всё, чего в источниках нет. Подставьте свои данные в квадратные скобки.
1. Разбор квартальной отчётности
Ты финансовый аналитик. К сообщению приложен отчёт компании за квартал.

Сделай четыре вещи:
1. Сводка на одну страницу: что произошло с выручкой, маржой, долгом и денежным потоком.
2. Таблица ключевых показателей: значение за квартал, за предыдущий квартал, за тот же квартал год назад, изменение.
3. Три факта из отчёта, которые меняют взгляд на компанию, и почему.
4. Чего в документе нет, но необходимо для вывода.

Правила:
- После каждой цифры в скобках укажи раздел или страницу документа, откуда она взята.
- Если значения в документе нет, пиши «нет в отчёте». Не оценивай и не достраивай.
- Отдельным списком в конце — всё, что ты посчитал сам, с формулой расчёта.
2. Проверка допущений в финансовой модели
К сообщению приложена финансовая модель. Не пересчитывай её целиком.

1. Выпиши все допущения, заложенные явно и неявно: темпы роста, отток клиентов, сроки оплаты, курс, налоги, сезонность.
2. Отметь допущения, которые противоречат друг другу или данным внутри самой модели.
3. Найди формулы с вписанными вручную числами там, где должна быть ссылка на блок допущений.
4. Покажи, что станет с итогом, если три самых чувствительных допущения ухудшить, — и назови величину ухудшения явно.
5. Если в моём задании есть ошибка или противоречие, скажи об этом первым делом и не подстраивайся под него.
3. Конкурентный анализ по открытым источникам
Собери сравнение компаний [А], [Б] и [В] на рынке [какой].

Структура по каждой: продукт и целевой клиент; как зарабатывает; публично заявленные цифры с датой и источником; сильные стороны; уязвимости; чем отличается от [наша компания].

Правила:
- Для каждого утверждения — ссылка на источник и дата публикации.
- Отделяй факты от предположений: предположения помечай словом «оценка».
- Если публичных данных по компании нет, так и напиши. Не заменяй их отраслевыми средними.
- В конце — три вопроса, на которые открытых данных не хватило, и где их можно искать.
4. Сводка для руководства
Преврати материал выше в записку для руководителя, который не читал исходные документы.

Формат:
- Первая строка — вывод или предлагаемое решение, без предисловий.
- Дальше три-пять пунктов по схеме: факт — что он означает — что делать.
- Риски и то, чего мы не знаем, — отдельным коротким блоком в конце.
- Не больше одной страницы. Короткие предложения, без вводных оборотов и штампов.
- Не добавляй ничего, чего не было в исходных материалах. Если для вывода не хватает данных, скажи прямо, каких именно.
5. Анализ таблицы или выгрузки
К сообщению приложена таблица: [что в ней]. Столбцы: [перечисли].

1. Опиши данные: период, число строк, пропуски, выбросы, подозрительные значения.
2. Посчитай [нужные показатели] в разрезе [измерение] и дай результат таблицей.
3. Назови три закономерности, которые видно в данных. Для каждой скажи, насколько она устойчива и чем может объясняться, кроме очевидной причины.
4. Дай код на Python, которым эти расчёты воспроизводятся у меня.
5. Отдельно перечисли вопросы, на которые эти данные ответить не позволяют.
6. Структура презентации
Собери структуру презентации по материалу выше. Аудитория — [кто], решение, которое нужно принять, — [какое], время выступления — [сколько минут].

Для каждого слайда укажи: заголовок-утверждение (вывод, а не тема), три опорных тезиса, какая цифра или график их подтверждают и откуда они взяты.

Первый слайд — вывод и что я прошу у аудитории. Дальше доказательства. В конце — риски и следующий шаг.

Слайды, для которых у нас нет данных, оставь в списке с пометкой «нужны данные». Содержимое не придумывай.
7. Самопроверка ответа
Проверь свой предыдущий ответ так, будто его писал другой человек, а тебе платят за найденные ошибки.

1. Выпиши каждое числовое утверждение и рядом — откуда оно: страница документа, собственный расчёт (приведи формулу) или оценка.
2. Отметь всё, что не подтверждается приложенными материалами.
3. Пересчитай заново три ключевые цифры и скажи, сошлись ли они.
4. Назови вывод, который сильнее всего зависит от одного допущения.
5. Исправленную версию дай отдельно, коротко перечислив, что изменилось и почему.
Сколько ресурсов уходит на задачу?
Меньше, чем у Opus 5, — примерно на 40% при настройках по умолчанию на типичных задачах. Складывается это из двух вещей: модель тратит меньше токенов на задачу, и сам токен стоит дешевле — базовая цена на 20% ниже, а чтение из кэша на 60% ниже, чем у Opus 5. Ответ она при этом выдаёт более чем на 30% быстрее.
В СуперИнтеллекте оплата идёт нейронами, и их расход зависит от числа токенов. То есть экономия по токенам напрямую превращается в меньший расход нейронов на тот же разбор отчёта. Отдельный вклад даёт краткость: по наблюдениям Box, ответы стали примерно на 40% короче без потери точности.
Как начать работать с Opus 5.5 в СуперИнтеллекте?
Модель доступна с тарифа Про и на старших — ULTRA и командных. Ни VPN, ни зарубежная карта не нужны, регистрация бесплатная.
- Зарегистрируйтесь на my.suin.ai — это бесплатно и занимает минуту.
- Подключите тариф Про или выше: с него открывается Claude Opus 5.5.
- В списке моделей выберите «Claude Opus 5.5». Если хотите, чтобы чат или агент всегда работал на самой свежей Opus, выберите псевдоним «Claude Opus Latest» — сейчас он ведёт на 5.5, а при выходе следующей версии перенастраивать ничего не придётся.
- Поставьте уровень усилий — для первой попытки низкий или средний.
- Приложите файлы: отчётность, выгрузки, изображения таблиц и графиков.
- Сравните на своей задаче: один клик переключает тот же чат на Claude Fable 5.1, Claude Opus 5, GPT-6 Astra или GPT-5.6 Sol — промпт переписывать не нужно.
Последний шаг стоит делать не для интереса, а всерьёз: возьмите три задачи, где вы знаете правильный ответ, прогоните их на двух-трёх моделях и сравните не только выводы, но и то, как каждая обходится с недостающими данными. Именно это отличие — а не разница в баллах — определит, сэкономит ли модель вам рабочий день.
Читать также: Обзор Claude Opus 5.5 — все возможности и тесты целиком. Как пользоваться Claude Opus 5.5 — настройки, уровни усилий, работа с файлами. Claude Opus 5.5 против Opus 5 — что изменилось по сравнению с предыдущей моделью. Claude Opus 5.5 вышла и доступна — новость о выходе.