
Обучения
GPT-6 Sol или Claude Opus 5.5: что выбрать — тесты, цена и сценарии
Прямого сравнения GPT-6 Sol и Claude Opus 5.5 нет, но есть два общих теста: в AutomationBench и FrontierCode впереди Opus 5.5, зато её токен вдвое дороже. Разбираем цифры, объясняем, почему OSWorld сравнивать нельзя, и даём промпты для своего теста.
Команда СуперИнтеллекта · · ~9 мин
Прямого сравнения GPT-6 Sol и Claude Opus 5.5 не публиковала ни OpenAI, ни Anthropic, но в анонсах обеих моделей от 22 сентября 2026 года есть два одинаковых теста — и в обоих впереди Opus 5.5: 40,0% против 33,2% в AutomationBench и 54,4% против 49,3% в FrontierCode. Зато токен Opus 5.5 в каталоге СуперИнтеллекта вдвое дороже, чем у Sol. Короткий ответ: Opus 5.5 — когда важен максимум качества на трудной задаче, GPT-6 Sol — когда задач много и важна цена. Обе модели доступны в СуперИнтеллекте с тарифа Про, и их можно сравнить в одном чате.
Есть ли прямое сравнение GPT-6 Sol и Claude Opus 5.5?
Нет. Модели вышли в один день, и каждая компания сравнила свою новинку с прошлыми моделями соперника: OpenAI — с Claude Opus 5 и Fable 5.1, Anthropic — с GPT-6 Astra и GPT-5.6 Sol. Почему так вышло и похоже ли это на тактику, мы разобрали в отдельном материале.
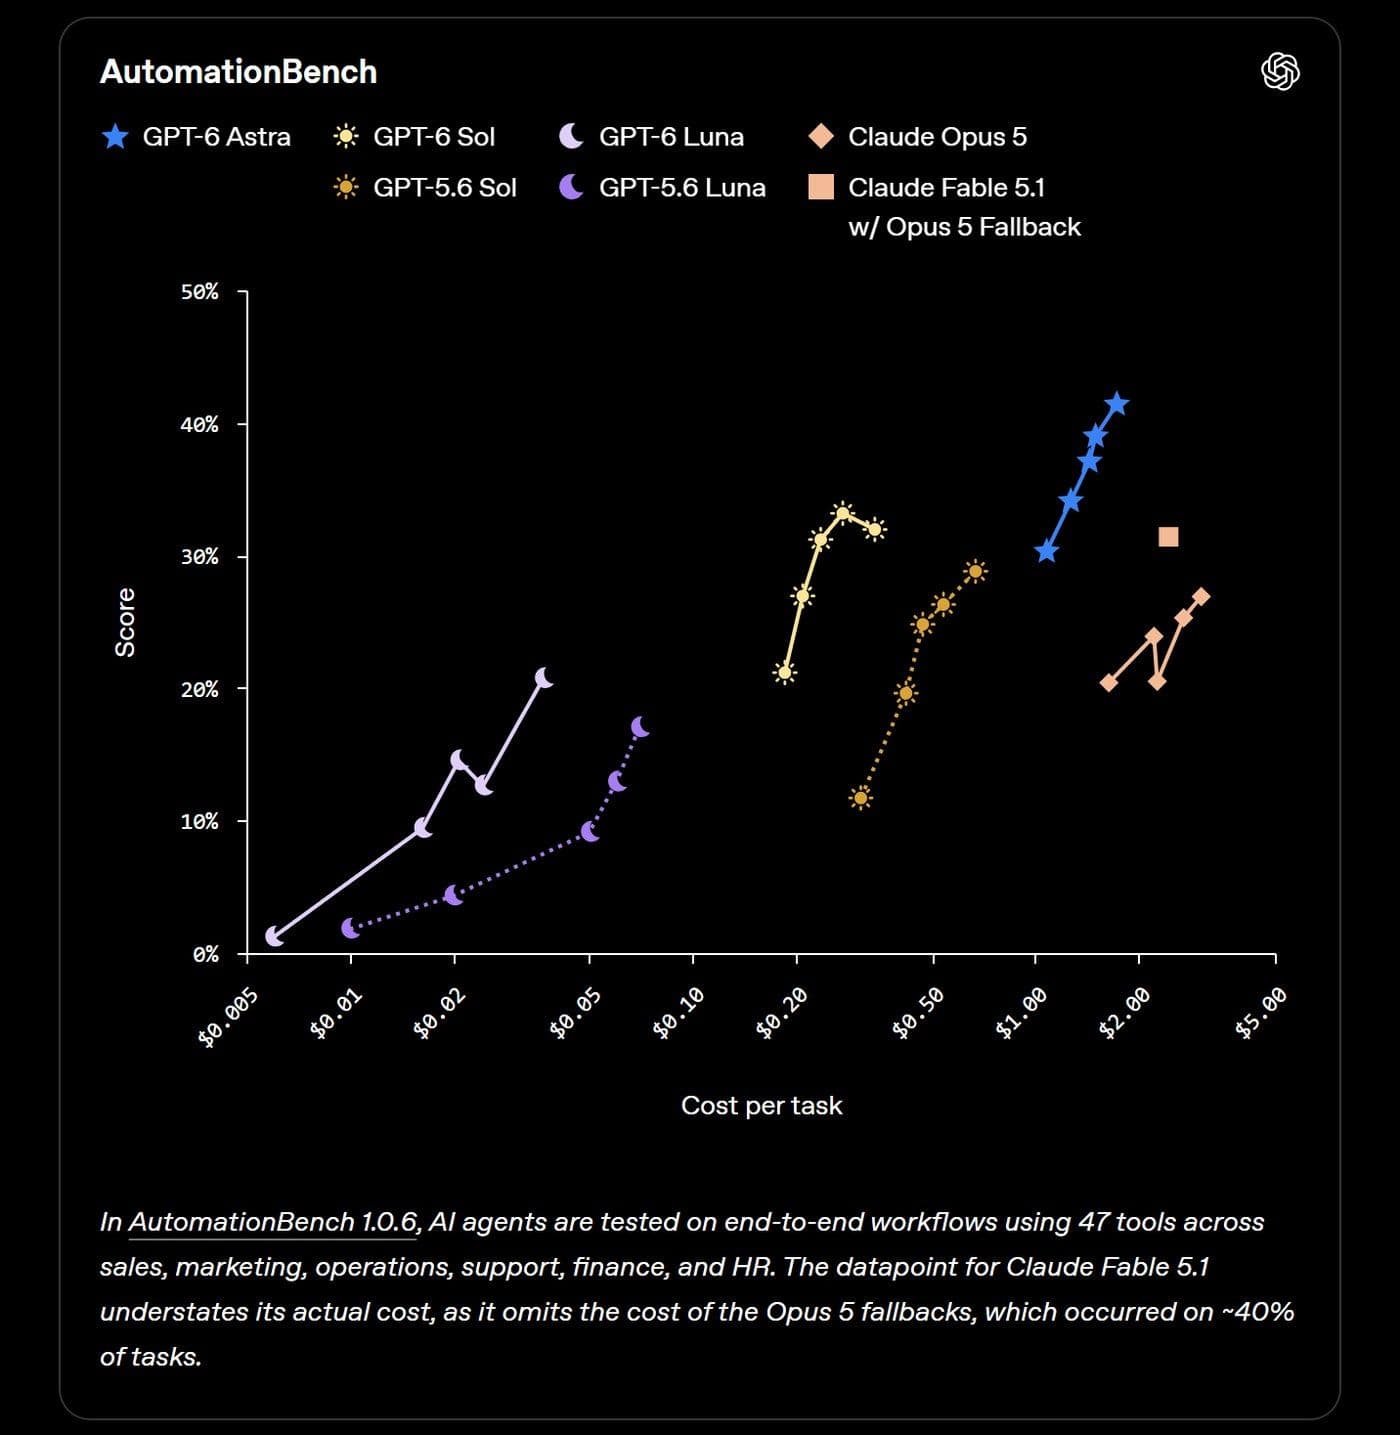
Выручают два теста, которые есть в обоих анонсах: AutomationBench и FrontierCode. Ставить их рядом позволяет то, что опорные значения совпадают: одни и те же модели получили в двух анонсах одинаковые результаты. Значит, тест один и тот же, и числа сопоставимы — с оговоркой, что это всё же данные двух разных компаний из разных анонсов.
| Модель | AutomationBench | FrontierCode |
|---|---|---|
| GPT-6 Astra (max) | 41,4% | 53,3% |
| GPT-5.6 Sol (max) | 28,8% | 47,5% |
| Claude Fable 5.1 | 31,4% | 50,3% |
| Claude Opus 5 (max) | 26,9% | 48,0% |
Как GPT-6 Sol и Claude Opus 5.5 выступают в общих тестах?
В обоих тестах Opus 5.5 выше: в AutomationBench на 6,8 процентного пункта, в FrontierCode — на 5,1 п. п., если брать лучший результат Sol.
| Тест | Что проверяет | Claude Opus 5.5 (Anthropic) | GPT-6 Sol (OpenAI) |
|---|---|---|---|
| AutomationBench | Сквозные бизнес-процессы с 47 инструментами: продажи, маркетинг, операции, поддержка, финансы, HR | 40,0% (max) | 33,2% (xhigh), 32,0% (max) |
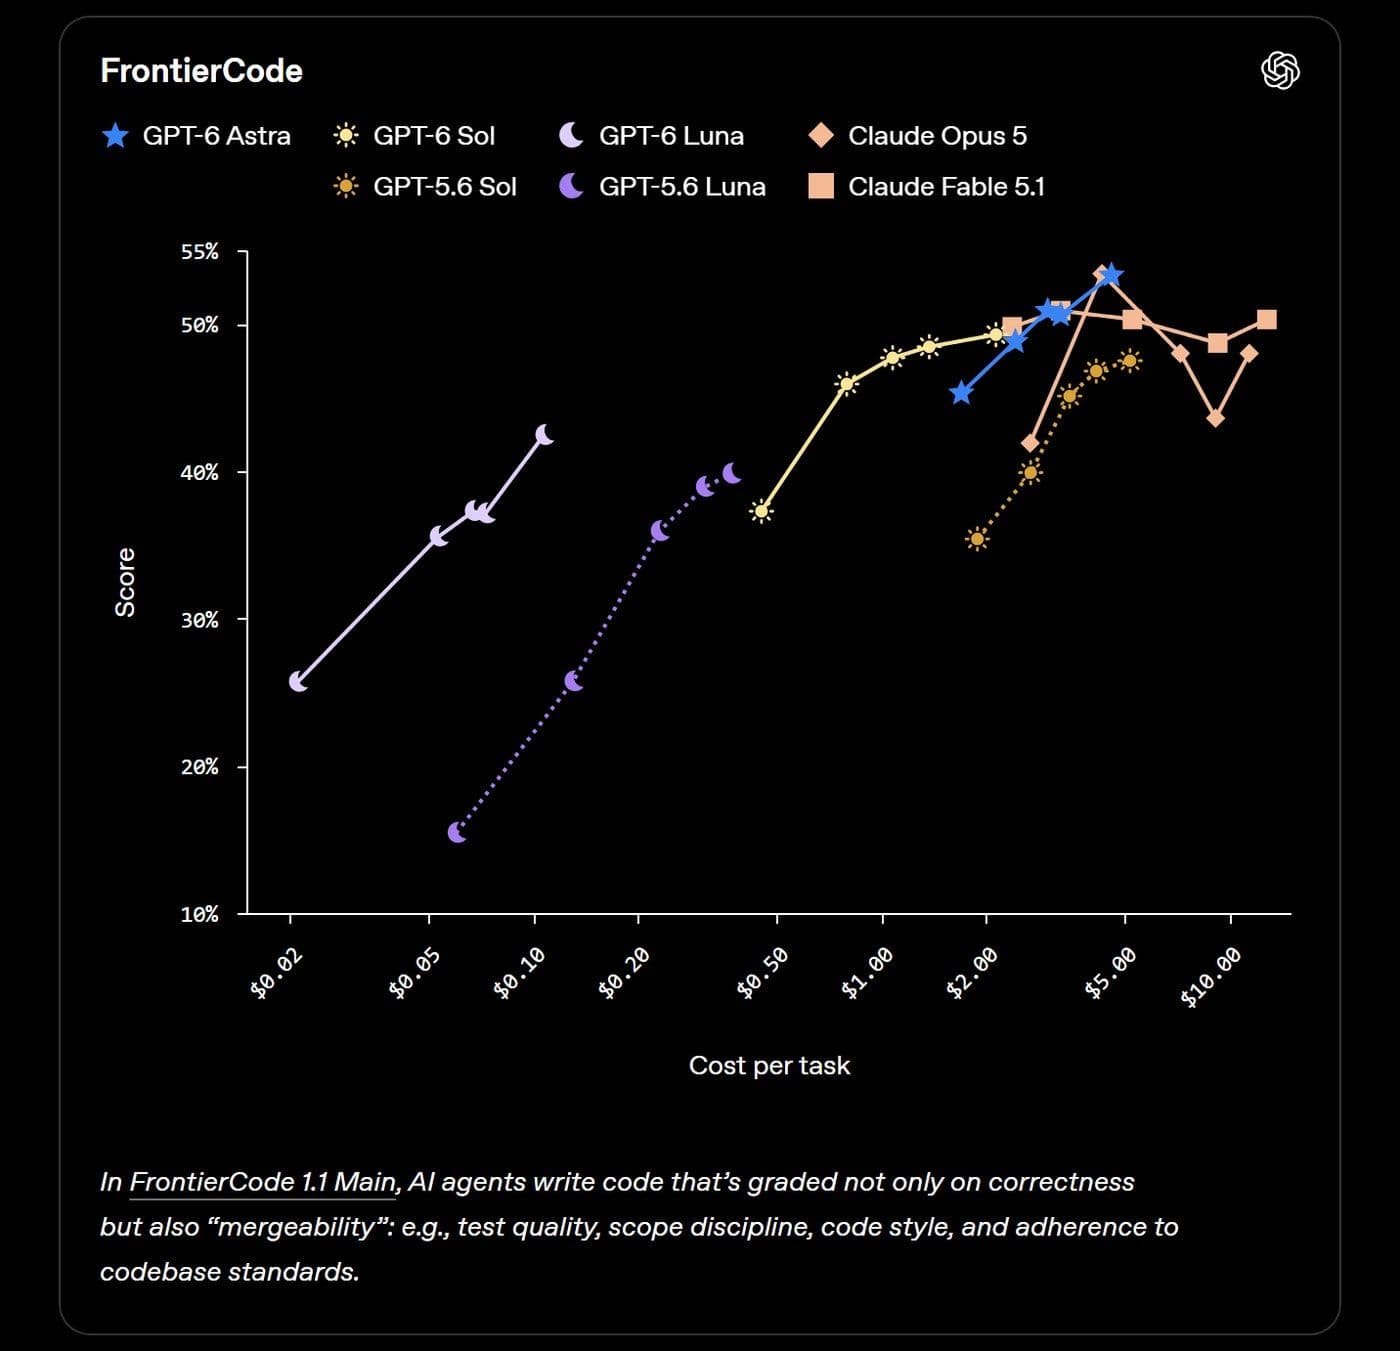
| FrontierCode 1.1 Main | Не только правильность кода, но и готовность к слиянию: тесты, объём правок, стиль, стандарты кодовой базы | 54,4% | 49,3% (max), 48,4% (xhigh) |
Для Sol это не провал. В AutomationBench она на уровне xhigh обходит Claude Opus 5 на max (26,9%) при 9% от стоимости задачи Opus 5 — и даже GPT-6 Astra на уровне low (30,3%), у которой задача в 3,9 раза дороже. Всё это — по данным OpenAI. Но новая модель Claude подняла планку: 40,0% у Opus 5.5 — почти вровень с флагманом OpenAI GPT-6 Astra на максимуме (41,4%).
Отставание Sol в коде видно и на графике самой OpenAI: в FrontierCode даже Claude Opus 5 на medium набирает 53,4% — больше лучшего результата Sol (49,3% на max). Sol заметно сильнее предшественницы GPT-5.6 Sol и догоняет Claude Fable 5.1 на xhigh (48,7%), но до 54,4% у Opus 5.5 не дотягивает.
Почему результаты OSWorld сравнивать нельзя?
Потому что компании измеряли разные варианты теста. OSWorld 2.0 проверяет работу с компьютером (computer use): модель выполняет задачи в операционной системе, как человек за экраном. Anthropic приводит для Opus 5.5 81,8%, для Opus 5 — 74,0%. OpenAI использует офлайн-набор с частичной оценкой (релиз v2026.08.08): у Sol там 60,5% на xhigh и 64,4% на max, а лучший результат Opus 5 — 70,2% на max. Одна и та же Opus 5 получает 74,0% у Anthropic и не больше 70,2% у OpenAI — опорные значения не сходятся, поэтому 81,8% у Opus 5.5 и результаты Sol ставить рядом нельзя.
С Terminal-Bench 4.0 (работа в командной строке) и GDPval-AA (профессиональные задачи, результат в рейтинге Эло) другая проблема: их приводит только Anthropic, GPT-6 Sol там не измеряли. Известно лишь, что в Terminal-Bench 4.0 Opus 5.5 обходит GPT-6 Astra — 66,4% против 57,9%. Подробнее — в сравнении Opus 5.5 и Astra.
Сколько стоят GPT-6 Sol и Claude Opus 5.5?
В каталоге СуперИнтеллекта токен Claude Opus 5.5 вдвое дороже, чем у GPT-6 Sol. Нейроны списываются по фактическому расходу токенов, поэтому итоговая цена ответа зависит ещё и от того, сколько токенов потратит модель, — а это определяют задача и ступень рассуждений.
Об экономии говорят обе компании, но каждая — относительно своего эталона. По данным OpenAI, задача AutomationBench у Sol на уровне xhigh стоит 9% от задачи Opus 5 на max. По данным Anthropic, Opus 5.5 при настройках по умолчанию примерно на 40% дешевле Opus 5 на типичных задачах и выдаёт ответ более чем на 30% быстрее. Свести эти цифры в одно соотношение нельзя: это разные замеры двух компаний, и ни один не сделан на нашем каталоге. Сколько нейронов уйдёт на вашу задачу, покажет пробный запрос.
Одна оговорка про длинные запросы: по правилам OpenAI запросы длиннее 272 000 токенов у Sol стоят дороже за токен.
Чем GPT-6 Sol и Claude Opus 5.5 отличаются по характеристикам?
Главные различия — в ступенях рассуждений и цене токена: у Sol есть режим без рассуждений, а токен Opus 5.5 вдвое дороже. Контекст и предельная длина ответа почти одинаковые.
| Параметр | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Разработчик и выход | OpenAI, 22 сентября 2026 | Anthropic, 22 сентября 2026 |
| Место в линейке | Средняя модель под флагманом GPT-6 Astra, преемница GPT-5.6 Sol | Первая модель Claude 5.5, преемница Opus 5; по оценке Anthropic, на уровне Fable 5.1 в большинстве задач |
| Контекст | 1 050 000 токенов | 1 000 000 токенов |
| Максимальный ответ | До 128 000 токенов | До 128 000 токенов |
| Ступени рассуждений | Шесть: от «Без раздумий» до «Максимум» | Пять: от «Быстрее» до «Максимум», режима без рассуждений нет |
| Цена токена в СуперИнтеллекте | Как у GPT-5.6 Sol; вдвое ниже, чем у Opus 5.5 | Вдвое выше, чем у Sol |
| Тариф в СуперИнтеллекте | С тарифа Про | С тарифа Про |
| Псевдоним Latest | GPT Sol Latest | Claude Opus Latest |
| Сильные стороны по анонсам | Фактическая точность, агентные сценарии при низкой стоимости задачи, код, работа с компьютером | Выше Sol в обоих общих тестах, работа в командной строке (Terminal-Bench 4.0), ответ более чем на 30% быстрее Opus 5 |
Какие задачи отдать GPT-6 Sol, а какие Claude Opus 5.5?
Правило простое: Opus 5.5 — туда, где ошибка стоит дороже токенов, Sol — туда, где задач много и расход складывается.
Когда выбирать Claude Opus 5.5
- Сложная автоматизация. Многошаговые процессы с десятками инструментов — ровно то, что проверяет AutomationBench, где у Opus 5.5 отрыв 6,8 п. п. Ступень — «Ещё глубже» или «Максимум».
- Код, который пойдёт в основную ветку. FrontierCode оценивает готовность к слиянию, и здесь Opus 5.5 впереди на 5,1 п. п. Сценарии — в гайде по Opus 5.5 для программирования.
- Работа в командной строке. В Terminal-Bench 4.0 Opus 5.5 обходит даже GPT-6 Astra; Sol там не измеряли.
- Разовые трудные задачи, где объём небольшой, а цена ошибки высокая: разбор сложного договора, архитектурное решение, стратегия.
Когда выбирать GPT-6 Sol
- Много однотипных задач и итераций. Агент с десятками вызовов инструментов, серия правок текста, обработка пачки документов: у Opus 5.5 токен вдвое дороже, и на объёме это заметно.
- Аналитика, где важны факты. Во внутреннем тесте OpenAI на трудных запросах Sol ошибается примерно вдвое реже GPT-5.6 Sol: 6,9% ответов с фактической ошибкой против 15,0% на medium. С Opus 5.5 этот тест не сравнивали.
- Быстрые ответы. Из этой пары ступень «Без раздумий» есть только у Sol — для простого письма или перевода рассуждения не нужны. Совсем простые вопросы ещё дешевле отдать GPT-6 Luna.
Когда нужны обе
Связка часто лучше выбора одной модели: черновик и итерации — на Sol, финальная проверка — на Opus 5.5. Модель переключается в том же чате, история сохраняется, переписывать промпт не нужно.
Так что выбрать: GPT-6 Sol или Claude Opus 5.5?
Claude Opus 5.5 сильнее в обоих общих тестах, но её токен вдвое дороже, чем у GPT-6 Sol. По заявлению OpenAI, модели GPT-6 лидируют на всей кривой «цена — интеллект», и Sol в этой линейке отвечает за середину: сложная аналитика, код и агенты без цены флагмана. Opus 5.5 — выбор, когда качество на трудной задаче важнее расхода. Разрыв в 5–7 п. п. на вашей задаче может оказаться и больше, и меньше, поэтому последнее слово — за собственной проверкой.
Как сравнить GPT-6 Sol и Claude Opus 5.5 на своей задаче?
Отправьте один и тот же промпт обеим моделям. Это займёт несколько минут и скажет о вашей задаче больше, чем любой бенчмарк.
- Откройте новый чат и выберите GPT-6 Sol.
- Нажмите чип «Модель · Ступень» рядом с кнопкой модели и в попапе «Усилие» поставьте «Ещё глубже» (xhigh): эта ступень есть у обеих моделей, так сравнение будет честным.
- Отправьте промпт ниже, подставив свою задачу.
- Переключите модель на Claude Opus 5.5, проверьте, что ступень та же, и отправьте тот же промпт.
- Сравните ответы: что точнее, чего не хватает, что лишнее и сколько правок нужно, чтобы результатом можно было пользоваться.
Промпт для сравнения двух моделей на рабочей задаче
Реши задачу с нуля. Не опирайся на ответы других моделей выше в этом чате.

Задача: [опишите реальную задачу из своей работы — например: «Составь план автоматизации обработки заявок с сайта: от формы до счёта клиенту. Инструменты: CRM, почта, таблица учёта»]

Контекст: [кто вы, для кого результат, ограничения по срокам, бюджету и инструментам]

Формат ответа:
1. Решение по шагам — конкретно, без общих слов.
2. Допущения, которые ты сделал, — отдельным списком.
3. Риски и места, где ты не уверен: что стоит проверить человеку.

Не пересказывай условие и не добавляй вступлений.
Промпт для сравнения на задаче по коду
Реши задачу с нуля, не опираясь на предыдущие ответы в этом чате.

Код и описание изменения: [вставьте фрагмент кода или приложите файл и опишите, что нужно изменить]

Требования:
— изменение должно быть готово к слиянию: сохрани стиль и соглашения существующего кода;
— не трогай то, что не относится к задаче;
— добавь или обнови тесты;
— в конце кратко перечисли, что изменено и почему.

Если для решения чего-то не хватает, сначала задай вопросы.
Что выбрать, если GPT-6 Sol и Opus 5.5 — это слишком?
Для повседневных задач хватит GPT-6 Luna: она доступна на бесплатном тарифе и с 23 сентября отвечает по умолчанию всем, кто не выбирал модель сам. Как выбрать между Astra, Sol, Luna и режимом Pro, мы разобрали в отдельном гайде. Всё работает в России без VPN и зарубежной карты, регистрация бесплатная: my.suin.ai/auth/register.