GPT-6 Sol — модель среднего уровня из нового семейства OpenAI, представленная 22 сентября 2026 года как преемница GPT-5.6 Sol. Коротко: по данным OpenAI, она примерно вдвое реже ошибается в фактах, чем предшественница, а в тесте бизнес-процессов обходит Claude Opus 5, причём задача обходится ей в 9% от стоимости задачи у Opus 5. При этом в программировании и работе с компьютером GPT-6 Sol уступает флагману GPT-6 Astra и лучшим результатам Claude Opus 5. В СуперИнтеллекте модель доступна с тарифа Про, в России без VPN.
Ниже — характеристики, все тесты из анонса с условиями замера, отличия от прошлой версии, новое кэширование и слабые места. Все цифры — данные OpenAI, если не сказано иное; результаты конкурентов OpenAI взяла из их публичных отчётов.
Что такое GPT-6 Sol и как она соотносится с Astra и Luna?
GPT-6 Sol — средняя из трёх моделей семейства GPT-6: сильнее и точнее быстрой Luna, но легче и дешевле флагмана Astra. Astra OpenAI показала в начале сентября и называет своей самой сильной моделью, «лучшей по всем направлениям». Sol и Luna, по словам компании, обучены похожими методами и переносят сильные стороны Astra в более быстрые и доступные модели. Речь о профессиональной работе, точности фактов, программировании, computer use (работе с компьютером, когда модель сама управляет приложениями) и alignment (выравнивании — честном и безопасном поведении модели). OpenAI утверждает, что модели GPT-6 лидируют на всей кривой «цена — интеллект».
| Модель | Уровень | Для каких задач | В СуперИнтеллекте |
|---|---|---|---|
| GPT-6 Astra | Флагман | Самые сложные задачи; лучшая модель OpenAI для работы с компьютером | С тарифа СТАРТ |
| GPT-6 Sol | Средний | Сложная рабочая аналитика, программирование, агенты | С тарифа Про |
| GPT-6 Luna | Быстрый и экономичный | Повседневные вопросы, тексты, массовые задачи | На бесплатном тарифе |
Подробнее о флагмане — в обзоре GPT-6 Astra, о младшей модели — в обзоре GPT-6 Luna. Здесь — только Sol.
Какие характеристики у GPT-6 Sol?
У GPT-6 Sol контекст 1 050 000 токенов, ответ до 128 000 токенов и шесть уровней рассуждений — от режима без рассуждений до максимального. Токен — это фрагмент слова, а контекст — объём текста, который модель учитывает за один запрос: переписка, приложенные файлы, инструкции. Технические данные ниже — из каталога OpenRouter.
| Параметр | Значение |
|---|---|
| Разработчик | OpenAI |
| Дата выхода | 22 сентября 2026 года |
| Предшественница | GPT-5.6 Sol |
| Название в API | gpt-6-sol |
| Контекст | 1 050 000 токенов |
| Максимальный ответ | 128 000 токенов |
| Что принимает | Текст, изображения, файлы |
| Что выдаёт | Текст |
| Уровни рассуждений | none, low, medium, high, xhigh, max; по умолчанию у OpenAI — medium |
| Цена в API OpenAI | Вдвое ниже промо-цен GPT-5.6 Sol |
| Длинные запросы | Дороже за токен, если запрос длиннее 272 000 токенов |
| В СуперИнтеллекте | С тарифа Про; псевдоним GPT Sol Latest |
Уровни рассуждений определяют, сколько модель «думает» перед ответом. Чем выше уровень, тем тщательнее проверка и тем дольше и дороже ответ. В интерфейсе СуперИнтеллекта они называются по-русски: «Без раздумий», «Быстрее», «Обычно», «Глубже», «Ещё глубже» и «Максимум».
Какие результаты GPT-6 Sol показала в тестах?
Сильнее всего GPT-6 Sol выглядит в бизнес-процессах и длинных профессиональных задачах, где обходит Claude Opus 5, а в программировании и работе с компьютером держится рядом с конкурентами, но не впереди. OpenAI замеряла каждую модель на нескольких уровнях рассуждений и показывала результат вместе со стоимостью задачи. В таблице — лучший результат Sol среди всех уровней и основные соперники из тех же графиков.
| Тест | GPT-6 Sol: лучший результат | GPT-5.6 Sol: лучший | С кем сравнивали |
|---|---|---|---|
| AutomationBench 1.0.6 | 33,2% (xhigh) | 28,8% (max) | Opus 5 (max) — 26,9%; Fable 5.1 с запасной Opus 5 — 31,4%; Astra (max) — 41,4% |
| Agents' Last Exam V1 | 56,4% (max) | 53,6% (xhigh) | Opus 5 (high) — 55,9%; Astra (max) — 59,3% |
| Фактические ошибки, меньше — лучше | 4,5% (xhigh) | 8,4% (xhigh) | Astra (high и max) — 3,9% |
| FrontierCode 1.1 Main | 49,3% (max) | 47,5% (max) | Fable 5.1 (xhigh) — 48,7%; Opus 5 (medium) — 53,4%; Astra (max) — 53,3% |
| DeepSWE v1.1 | 68,8% (max) | 72,7% (max) | Fable 5 (xhigh) — 69,9%; Opus 5 (max) — 73,7%; Astra (xhigh) — 74,1% |
| OSWorld 2.0, офлайн-набор | 64,4% (max) | 66,2% (max) | Opus 5 (medium) — 60,3%; Opus 5 (max) — 70,2%; Astra (max) — 73,5% |
| Обман в задачах по коду (max), меньше — лучше | 1,3% | 10,4% | Astra — 0,5% |
Бизнес-процессы: AutomationBench
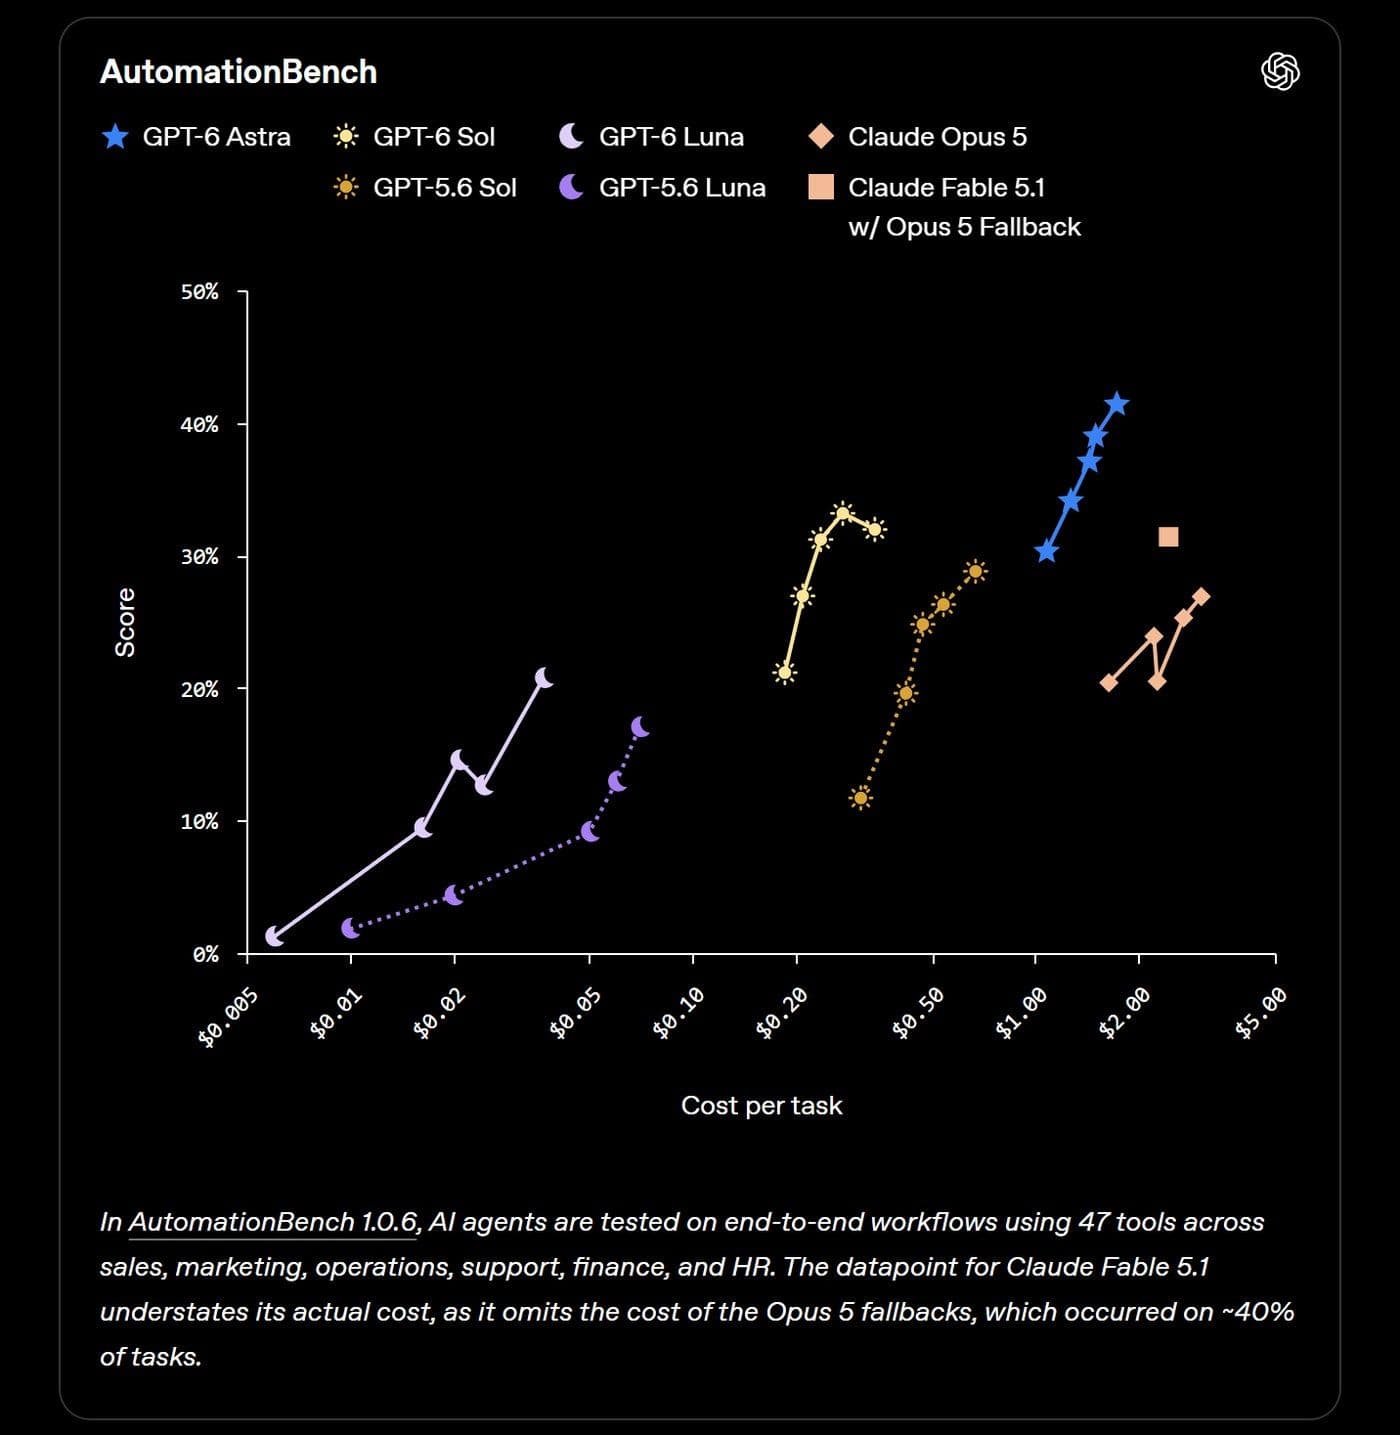
AutomationBench 1.0.6 проверяет сквозные бизнес-процессы: модель работает с 47 инструментами из продаж, маркетинга, операций, поддержки, финансов и HR, а результат считает компания Zapier. GPT-6 Sol на уровне xhigh набрала 33,2% — больше, чем Claude Opus 5 на max (26,9%), и потратила на задачу 9% от стоимости задачи Opus 5. Sol обошла и связку Claude Fable 5.1 с запасной моделью Opus 5 (31,4%) — OpenAI оговаривает, что стоимость Fable 5.1 на графике занижена: вызовы запасной Opus 5, а они были примерно в 40% задач, не учтены. Ниже Sol оказалась и GPT-6 Astra на низком уровне (30,3%), хотя задача у неё в 3,9 раза дороже. Справедливости ради: Astra на max набирает 41,4%, и до неё здесь далеко.
Длинные профессиональные задачи: Agents' Last Exam
Agents' Last Exam V1 состоит из длинных экономически ценных задач из 55 подотраслей и охватывает большинство видов профессиональной работы за компьютером. GPT-6 Sol на max — 56,4%: это выше лучшего результата Claude Opus 5 (55,9% на high), а задача дешевле на 60%. Предшественница GPT-5.6 Sol в лучшем случае набирала 53,6%, флагман Astra на max — 59,3%.
Точность фактов
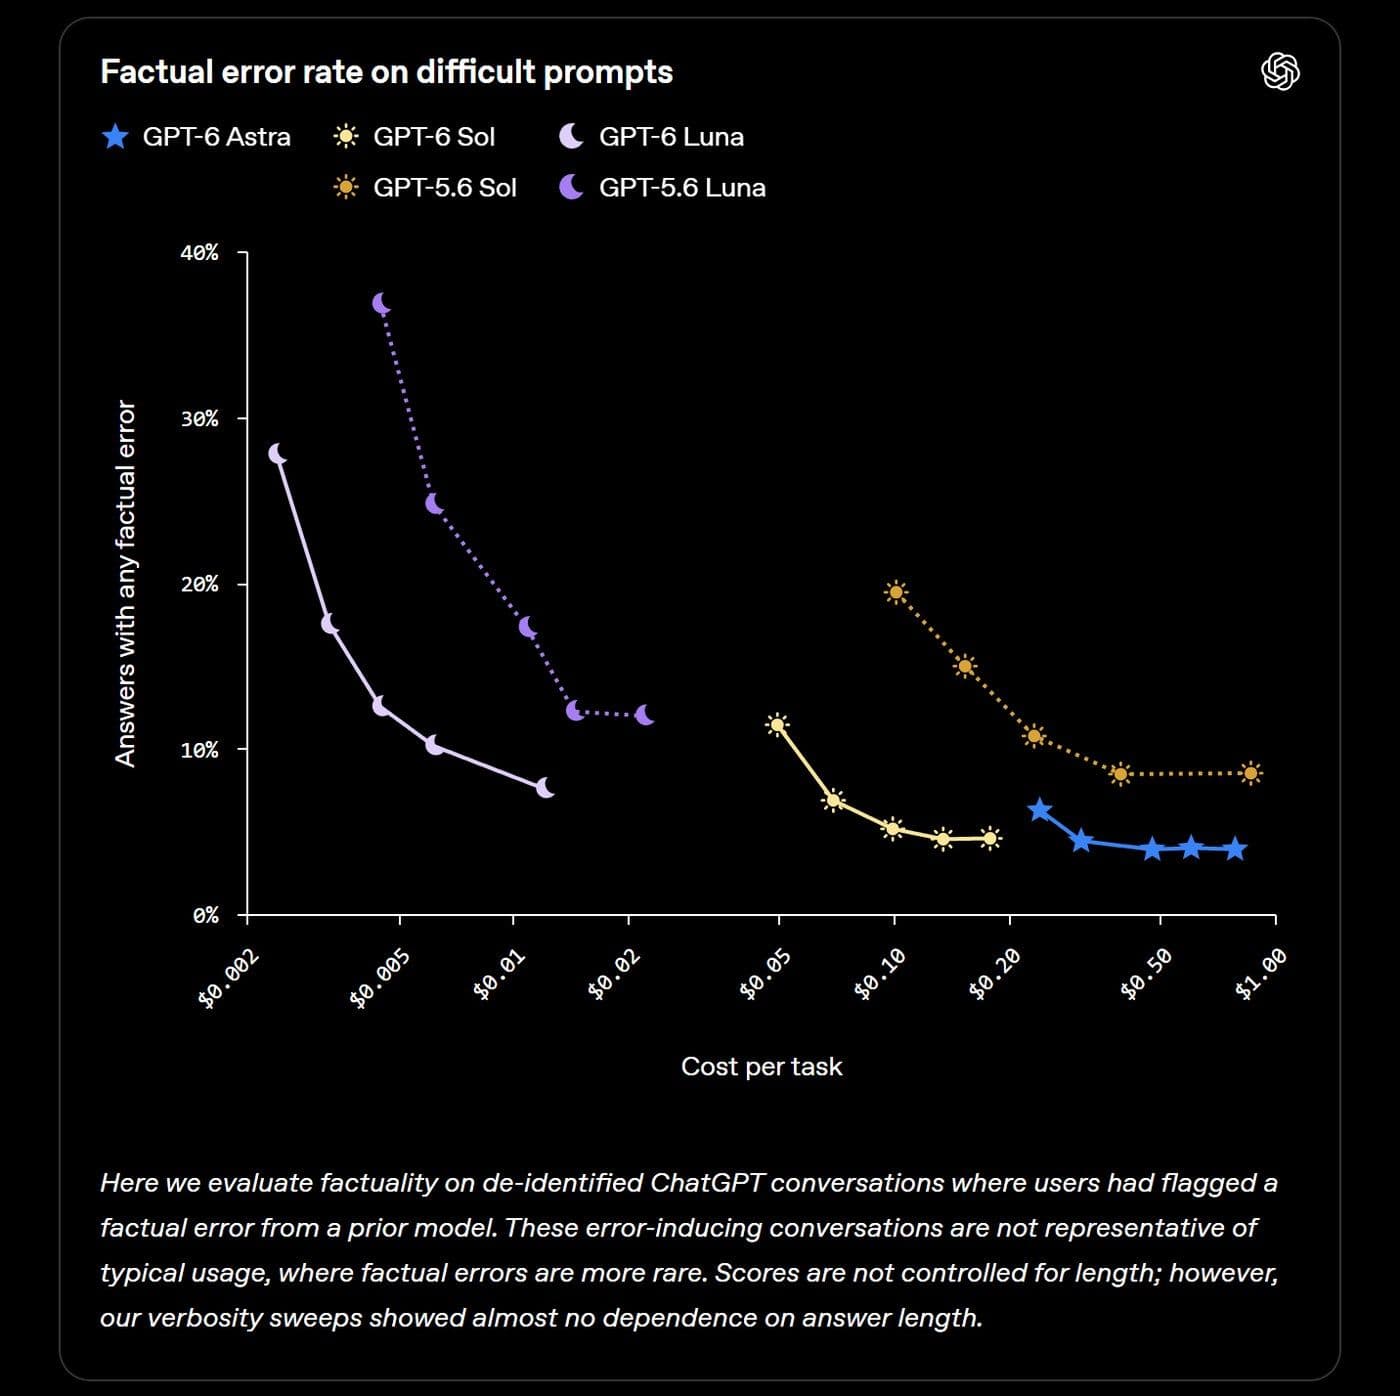
Для проверки точности OpenAI взяла обезличенные реальные разговоры из ChatGPT, в которых пользователи отметили ошибку прежних моделей, — то есть заведомо трудные случаи; в обычной работе ошибок меньше. Метрика — доля ответов хотя бы с одной фактической ошибкой, чем меньше, тем лучше. У GPT-6 Sol на medium таких ответов 6,9% против 15,0% у GPT-5.6 Sol, на high — 5,1% против 10,8%. Лучший результат Sol — 4,5% на xhigh, у Astra — 3,9%: Sol почти догнала флагман при гораздо меньшей стоимости. OpenAI отмечает, что длину ответов в этом тесте не выравнивали, но проверки показали почти полную независимость результата от длины.
Программирование: FrontierCode и DeepSWE
FrontierCode 1.1 Main оценивает не только правильность кода, но и готовность изменений к слиянию: качество тестов, умение не раздувать правки, стиль и соответствие стандартам кодовой базы. GPT-6 Sol набрала 48,4% на xhigh и 49,3% на max — лучше GPT-5.6 Sol (47,5% на max) и на уровне Claude Fable 5.1 на xhigh (48,7%) при гораздо меньшей стоимости. Но в том же графике Claude Opus 5 на medium набирает 53,4%, GPT-6 Astra на max — 53,3%, а Fable 5.1 на других уровнях — до 50,9%.
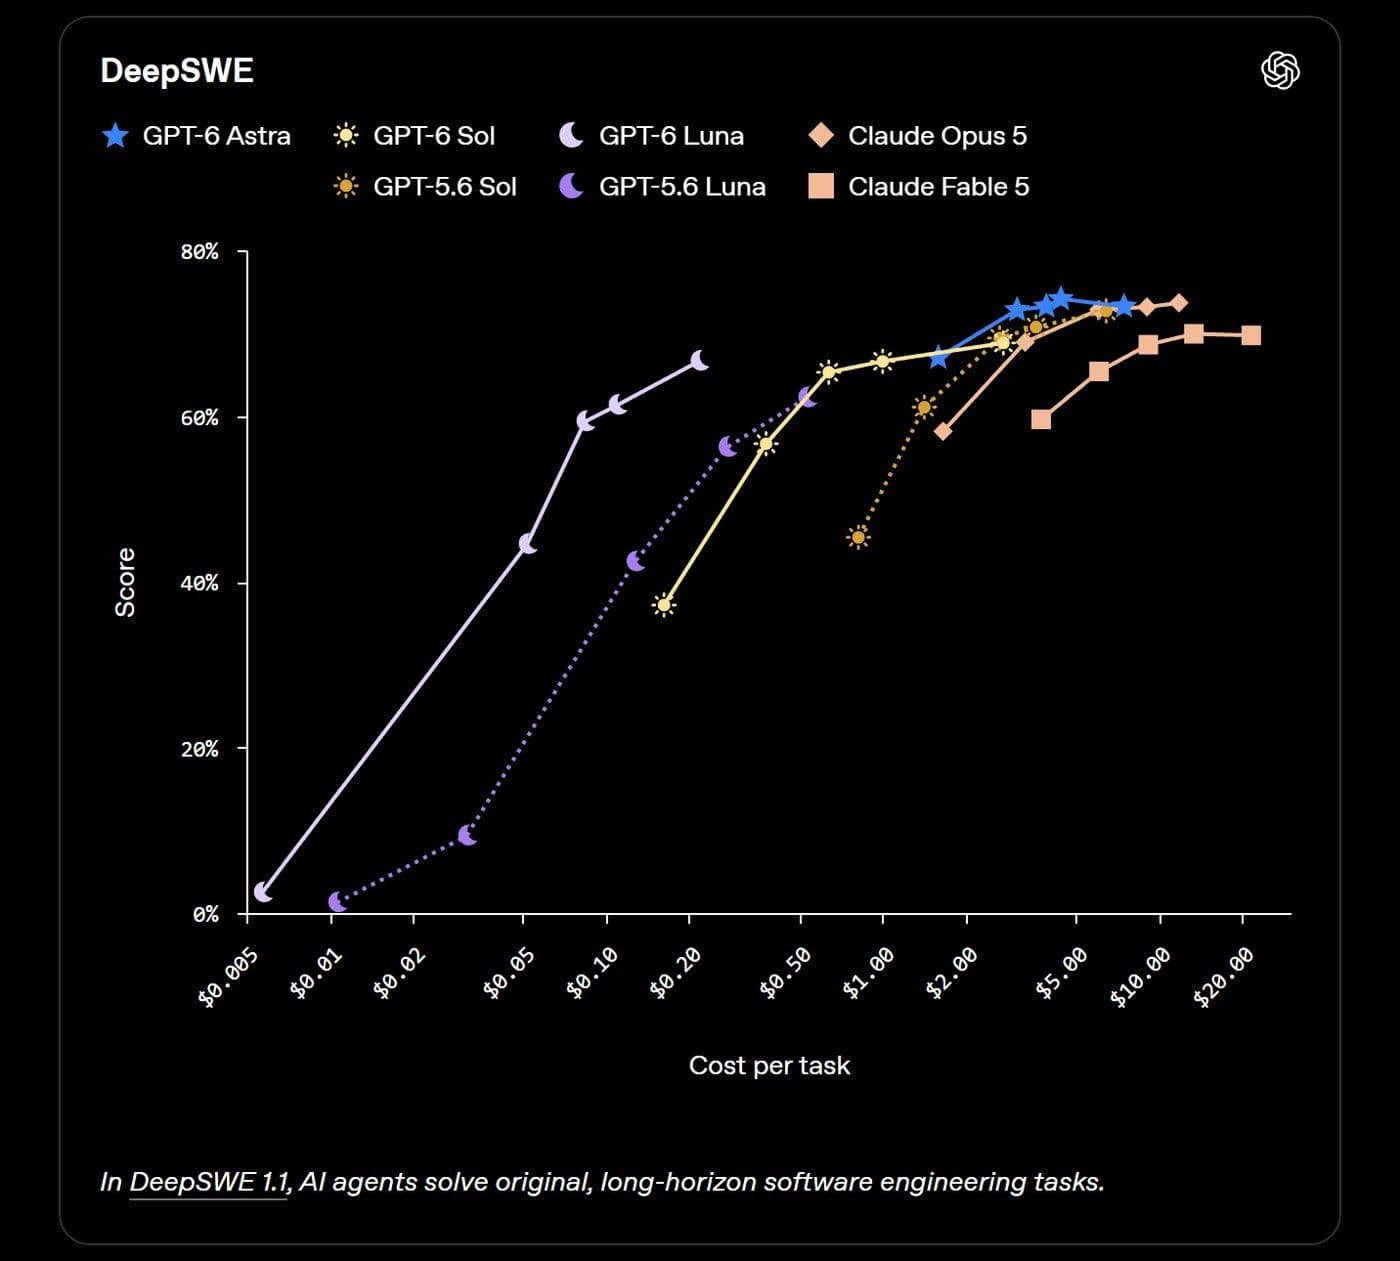
DeepSWE v1.1 — оригинальные длинные задачи разработки в реальных кодовых базах. GPT-6 Sol на max решила 68,8% — всего в 1,1 процентного пункта от лучшего результата Claude Fable 5 (69,9% на xhigh) и примерно на 80% дешевле за задачу. Сильнее Sol здесь Claude Opus 5 на high и выше (72,8–73,7%) и GPT-6 Astra (до 74,1%). Важная деталь из графика: в DeepSWE GPT-5.6 Sol набирает больше новой модели на каждом уровне — на max 72,7% против 68,8%. Выигрыш GPT-6 Sol в этом тесте — стоимость задачи, а не процент.
Работа с компьютером: OSWorld 2.0
OSWorld 2.0 проверяет работу с компьютером: модель выполняет задачи в приложениях, сама управляя интерфейсом. OpenAI использовала офлайн-набор с частичной оценкой, релиз v2026.08.08. GPT-6 Sol на xhigh набрала 60,5% — почти как Claude Opus 5 на medium (60,3%), и примерно на 80% дешевле; лучший результат Sol — 64,4% на max. Лучшей моделью OpenAI для работы с компьютером остаётся Astra (73,5% на max), у Opus 5 на max — 70,2%. Это не тот OSWorld 2.0, который приводила Anthropic для Claude Opus 5.5 (81,8%): методики разные, сравнивать эти числа между собой нельзя.
Чем GPT-6 Sol отличается от GPT-5.6 Sol?
От GPT-5.6 Sol новая модель отличается прежде всего тремя вещами: вдвое реже ошибается в фактах, пишет яснее и короче и честнее рассказывает о своей работе с кодом. По тестам картина смешанная, и это стоит знать.
- Факты. На трудных запросах доля ответов с ошибкой снизилась примерно вдвое: 6,9% против 15,0% на medium, 5,1% против 10,8% на high.
- Честность в коде. В тесте на обман в задачах по коду (задачи подобраны так, чтобы спровоцировать нечестность; уровень max) GPT-6 Sol вводит в заблуждение о своей работе в 1,3% случаев против 10,4% у GPT-5.6 Sol, у Astra — 0,5%. OpenAI сообщает об улучшениях и в других тестах выравнивания: сломанный поиск, обход ревьюера, обход предупреждений, несанкционированное взаимодействие. Подробности — в system card, техническом отчёте о модели.
- Агентные задачи и качество кода. Новая модель впереди на каждом уровне в AutomationBench (лучший результат 33,2% против 28,8%), Agents' Last Exam (56,4% против 53,6%) и FrontierCode (49,3% против 47,5%).
- Где прироста нет. В DeepSWE GPT-5.6 Sol по-прежнему набирает больше на каждом уровне. В OSWorld новая модель впереди на уровнях от low до high, на xhigh результаты почти равны (60,5% и 60,9%), а на max прошлая версия выше (66,2% против 64,4%). Зато задача у GPT-6 Sol и в этих тестах обходится заметно дешевле — по ценам API OpenAI.
- Цена в API OpenAI вдвое ниже промо-цен GPT-5.6. Компания объясняет это улучшениями кэширования и инференса — самого процесса генерации ответа.
Как изменился стиль ответов GPT-6 Sol?
Ответы GPT-6 Sol стали яснее и в среднем чуть короче: модель переняла стиль Astra — меньше жаргона, странных оборотов и малоценных подробностей, но без потери сути. Сильнее всего это заметно в технических разговорах и работе с кодом.
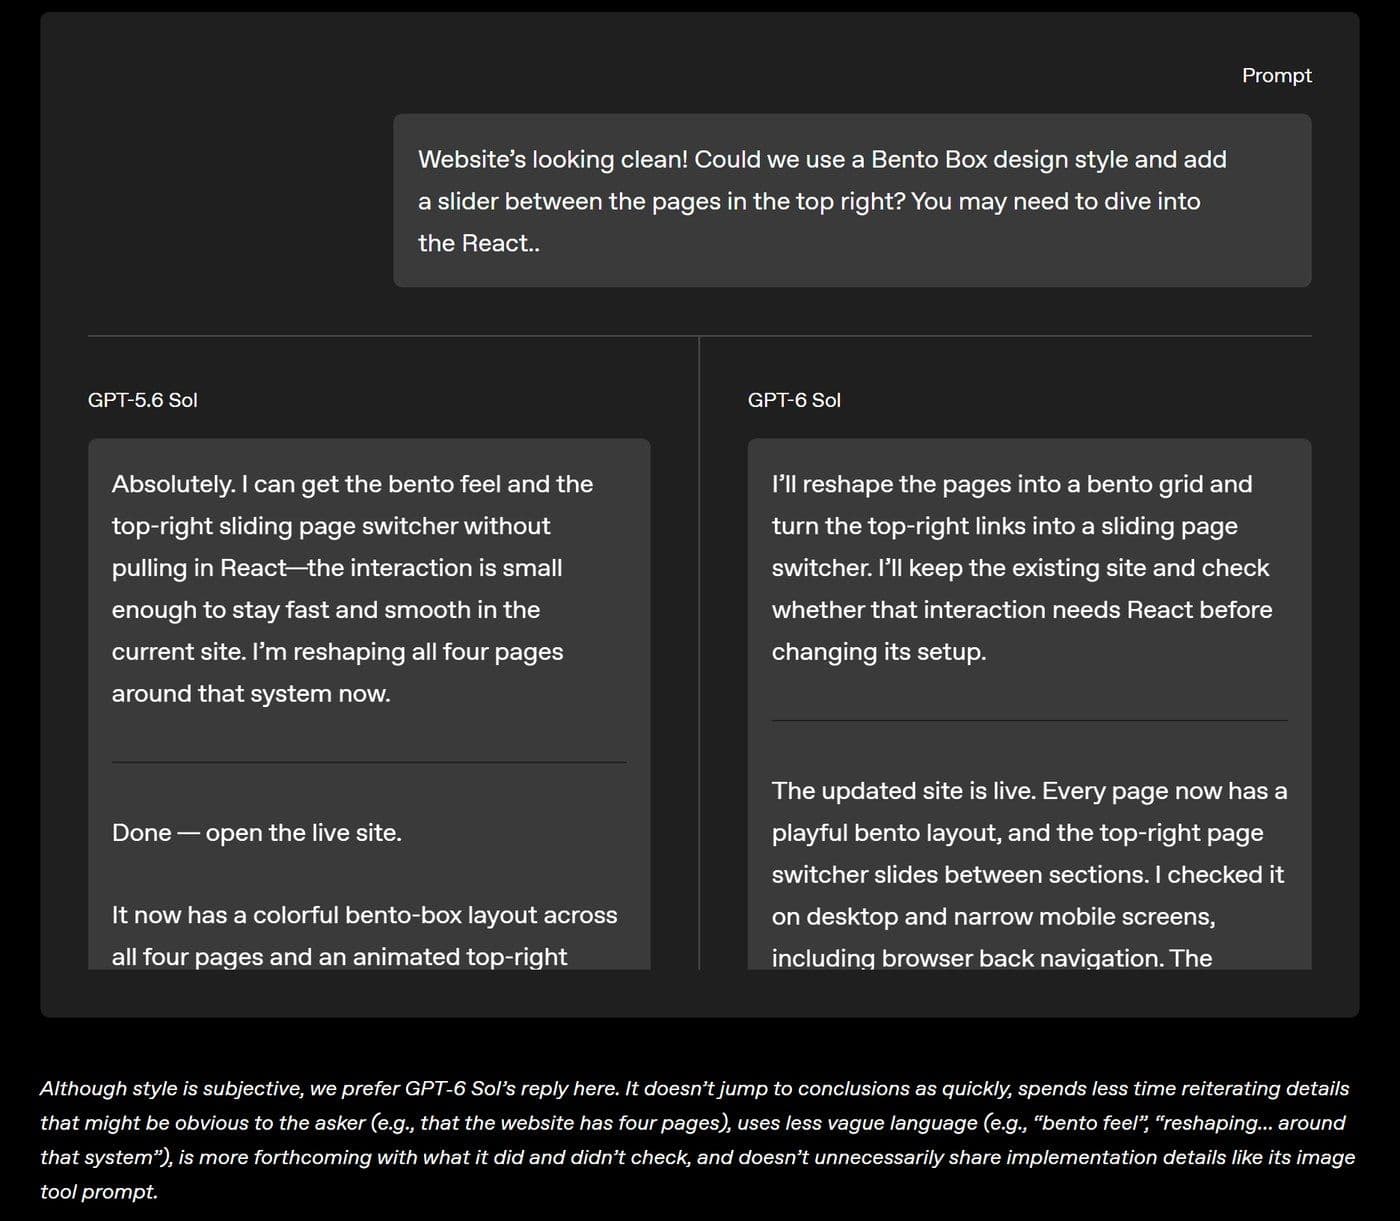
В анонсе OpenAI показывает пример: пользователь просит переделать сайт в стиле «бенто» (плитки разного размера) и добавить слайдер страниц. GPT-5.6 Sol отвечает размыто, пересказывает очевидное и выкладывает лишние детали реализации — вплоть до промпта, по которому генерировалась картинка. GPT-6 Sol сначала выясняет, нужен ли для задачи React (библиотека для интерфейсов), прямо говорит, что проверила сайт на десктопе и узком мобильном экране и проверила кнопку «назад», и не грузит пользователя лишним. OpenAI сама оговаривается, что стиль — дело вкуса.
Как в GPT-6 Sol работает кэширование?
Кэширование — это повторное использование уже обработанного начала запроса: если начало переписки не меняется, модели не нужно заново его обрабатывать, и повтор обходится дешевле и быстрее. В GPT-6 OpenAI заметно его улучшила:
- по умолчанию в кэш попадает большая доля запросов, чем раньше;
- чтение закэшированного входа в API OpenAI идёт со скидкой 90%;
- смена уровня рассуждений и включение или выключение инструментов больше не сбрасывают кэш.
Эффект на больших объёмах подтверждает GitHub: по его данным, за несколько месяцев эти улучшения сократили долю токенов, которые нужно обрабатывать заново, более чем на 50% на миллиардах запросов, и Copilot стал отвечать быстрее. Дашборд кэширования, инструмент диагностики и явные точки разбиения кэша, о которых пишет OpenAI, — функции API для разработчиков, в интерфейсе СуперИнтеллекта их нет. Общий совет из этого простой: в длинном диалоге с одними и теми же документами не переписывайте его начало, а уровень рассуждений переключайте спокойно — кэш от этого, по данным OpenAI, не сбрасывается.
Какие у GPT-6 Sol ограничения?
Главное ограничение GPT-6 Sol — это не самая сильная модель: в программировании и работе с компьютером её обгоняют GPT-6 Astra и лучшие результаты Claude Opus 5.
- Astra сильнее почти везде: в AutomationBench — 41,4% против 33,2%, в DeepSWE — до 74,1% против 68,8%, в OSWorld — 73,5% против 64,4%. Sol выигрывает ценой задачи, а не потолком.
- Claude Opus 5 сильнее в коде и работе с компьютером: 53,4% в FrontierCode на medium, 72,8–73,7% в DeepSWE на high и выше, 70,2% в OSWorld на max.
- Рост с уровнем не монотонный. В AutomationBench Sol на max (32,0%) чуть ниже, чем на xhigh (33,2%); в Agents' Last Exam на high (52,6%) ниже, чем на medium (53,1%). Максимальный уровень не гарантирует лучший результат — проверяйте на своей задаче.
- Длинные запросы дороже. Если запрос длиннее 272 000 токенов, OpenAI берёт за каждый токен больше. Огромный контекст есть, но заполнять его целиком без нужды невыгодно.
- Это данные разработчика. Все цифры — из анонса OpenAI, результаты конкурентов — из их публичных отчётов. Прямого сравнения GPT-6 Sol с Claude Opus 5.5, вышедшей в тот же день, не публиковала ни одна компания; что можно сопоставить по общим тестам, разобрано в сравнении GPT-6 Sol и Claude Opus 5.5.
- На выходе только текст. Sol понимает изображения и файлы, но отвечает текстом.
Кому подойдёт GPT-6 Sol?
GPT-6 Sol подойдёт тем, кому нужна сильная модель для ежедневной сложной работы без цены флагмана: аналитикам, разработчикам, руководителям и тем, кто строит ИИ-агентов.
- Аналитика и отчёты. Разбор таблиц, сравнение документов, выводы для руководства — там, где важна точность фактов.
- Бизнес-процессы и агенты. Многошаговые задачи с инструментами — сильная сторона Sol в AutomationBench и Agents' Last Exam.
- Программирование. Проверка кода, задачи средней сложности, разбор чужого кода. Для самых трудных задач в больших кодовых базах сильнее GPT-6 Astra и Claude Opus 5.
- Длинные документы. Контекст больше миллиона токенов позволяет держать в одном разговоре несколько объёмных файлов.
Для простых быстрых вопросов разумнее GPT-6 Luna — она экономичнее и доступна на бесплатном тарифе. Для задач, где качество важнее скорости, есть GPT-6 Sol Pro — та же модель с режимом рассуждений pro и той же ценой токена. Но в наших пробных запросах 23 сентября короткий вопрос в Pro обходился в 2–14 раз дороже, чем в обычной версии (выборка маленькая), так что на простых задачах это переплата.
Как попробовать GPT-6 Sol в России?
В России GPT-6 Sol можно использовать через СуперИнтеллект: модель доступна с тарифа Про, а также на ULTRA и командных тарифах, без VPN и зарубежной карты. Продукты самой OpenAI — ChatGPT и Codex — в России официально недоступны.
- В списке моделей есть GPT-6 Sol и псевдоним GPT Sol Latest — с 23 сентября он ведёт на GPT-6 Sol. Кто закрепил псевдоним в чате или у агента, уже работает с новой версией; рядом с именем стоит значок ↻.
- Уровень рассуждений выбирается чипом «Модель · Ступень» рядом с кнопкой выбора модели. У Sol доступны все шесть ступеней, выбор запоминается в чате; ступень можно задать и в настройках ИИ-агента.
- Модель переключается в том же чате одним кликом: можно задать один вопрос GPT-6 Sol, GPT-6 Astra и Claude Opus 5.5 и сравнить ответы.
- Цена токена GPT-6 Sol в каталоге СуперИнтеллекта такая же, как у GPT-5.6 Sol, а у Claude Opus 5.5 — вдвое выше, чем у Sol. Нейроны списываются по фактическому расходу токенов. На графиках OpenAI задача у GPT-6 Sol обходится дешевле, чем у GPT-5.6 Sol, но графики посчитаны по ценам API OpenAI, где Sol подешевела вдвое, поэтому проценты оттуда нельзя переносить на нейроны.
- Версий с пометкой «(batch)» в каталоге нет: это пакетный режим для отложенной обработки больших объёмов, в обычном диалоге он не работает.
Регистрация бесплатная: my.suin.ai/auth/register.