Для большинства задач начинайте с GPT-6 Luna на ступени «Глубже», сложную аналитику, серьёзный код и многошаговых агентов отдавайте GPT-6 Sol, а GPT-6 Astra оставьте для самых трудных задач. С 23 сентября 2026 года в СуперИнтеллекте шесть моделей GPT-6: Astra, Sol, Luna и Pro-версия каждой из них. Luna есть уже на бесплатном тарифе и, по графикам OpenAI, обходится за задачу дешевле всех; Astra — самая сильная и самая дорогая. Pro-версии нужны точечно: на трудных задачах, где качество важнее скорости.
Luna к тому же уже работает по умолчанию. Модель платформы — GPT Luna Latest на ступени «Глубже», и с 23 сентября она ведёт на GPT-6 Luna. Если вы не выбирали модель сами, то уже пользуетесь GPT-6 Luna — подробнее в новости Luna стала моделью по умолчанию.
Какие модели GPT-6 есть в СуперИнтеллекте?
Шесть: три модели и три Pro-версии. Флагман Astra OpenAI представила в начале сентября, Sol и Luna — 22 сентября 2026 года. OpenAI обучила Sol и Luna похожими на Astra методами, чтобы перенести её сильные стороны — профессиональную работу, точность фактов, программирование — в более быстрые и дешёвые модели. Sol — преемница GPT-5.6 Sol, Luna — преемница GPT-5.6 Luna.
| Модель | Что это | С какого тарифа | Для чего |
|---|---|---|---|
| GPT-6 Luna | быстрая и экономичная | бесплатный | повседневные задачи, тексты, документы, простые агенты |
| GPT-6 Luna Pro | Luna в режиме рассуждений pro | СТАРТ | трудные задачи при скромном бюджете |
| GPT-6 Sol | средний уровень | Про | сложная аналитика, код, агенты |
| GPT-6 Sol Pro | Sol в режиме рассуждений pro | Про | разовые трудные задачи с высокой ценой ошибки |
| GPT-6 Astra | флагман | СТАРТ | самые сложные задачи |
| GPT-6 Astra Pro | Pro-версия флагмана | Про | самые сложные задачи, где важна каждая деталь |
Дешевле всех обходится Luna: по графикам OpenAI, на ступени high задача у неё стоит в 8–22 раза меньше, чем у Sol, в зависимости от теста. Astra на любой ступени дороже Sol во всех графиках анонса, где указана стоимость задачи. У Luna Pro и Sol Pro цена токена та же, что у обычных версий. Нейроны списываются по фактическому расходу токенов, поэтому итог зависит ещё и от того, сколько модель думает и пишет. У Sol и Luna контекст 1 050 000 токенов, ответ до 128 000 токенов, на вход — текст, изображения и файлы.
Как GPT-6 Astra, Sol и Luna выглядят в бенчмарках?
Ниже результаты всех трёх на максимальной ступени (max) по графикам анонса OpenAI. Это данные вендора; Pro-версии в тестах не участвовали.
| Тест (что проверяет) | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|
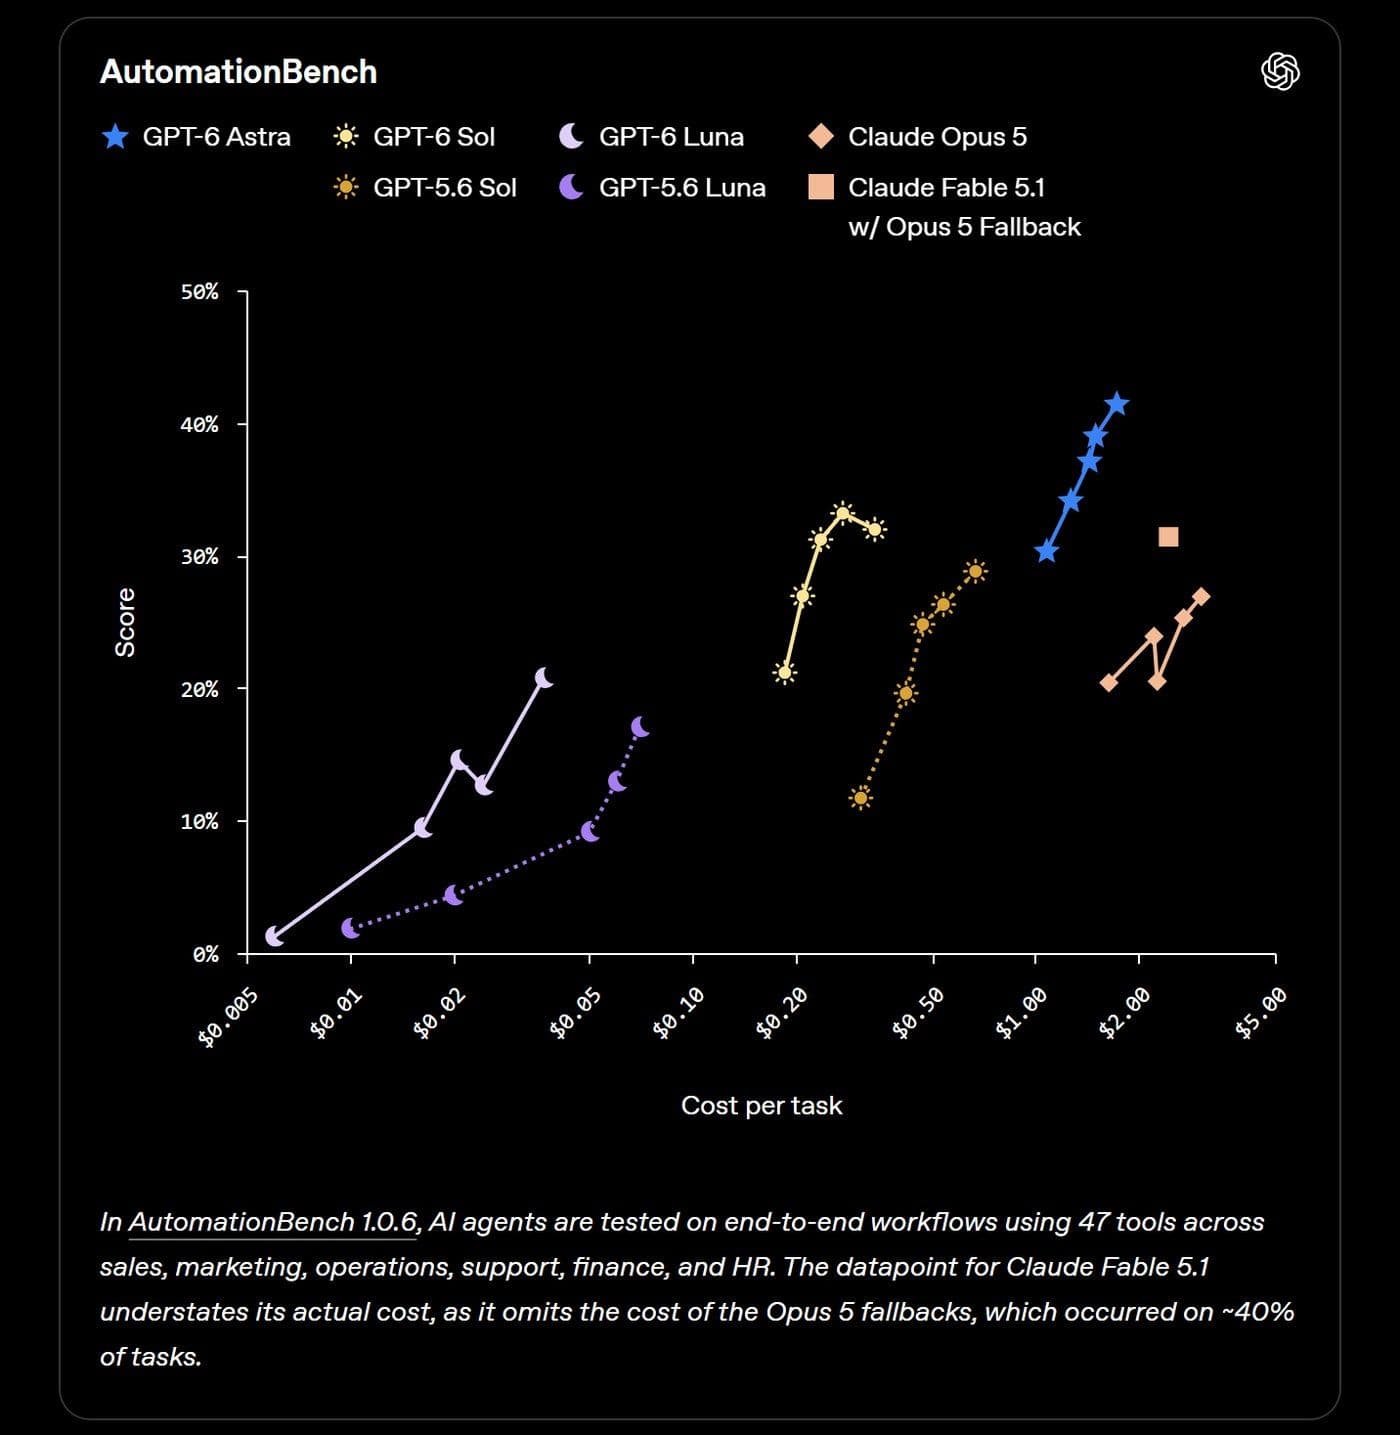
| AutomationBench — бизнес-процессы с 47 инструментами | 41,4% | 32,0% | 20,7% |
| Agents' Last Exam — длинные профессиональные задачи | 59,3% | 56,4% | 50,9% |
| FrontierCode — код, готовый к слиянию | 53,3% | 49,3% | 42,4% |
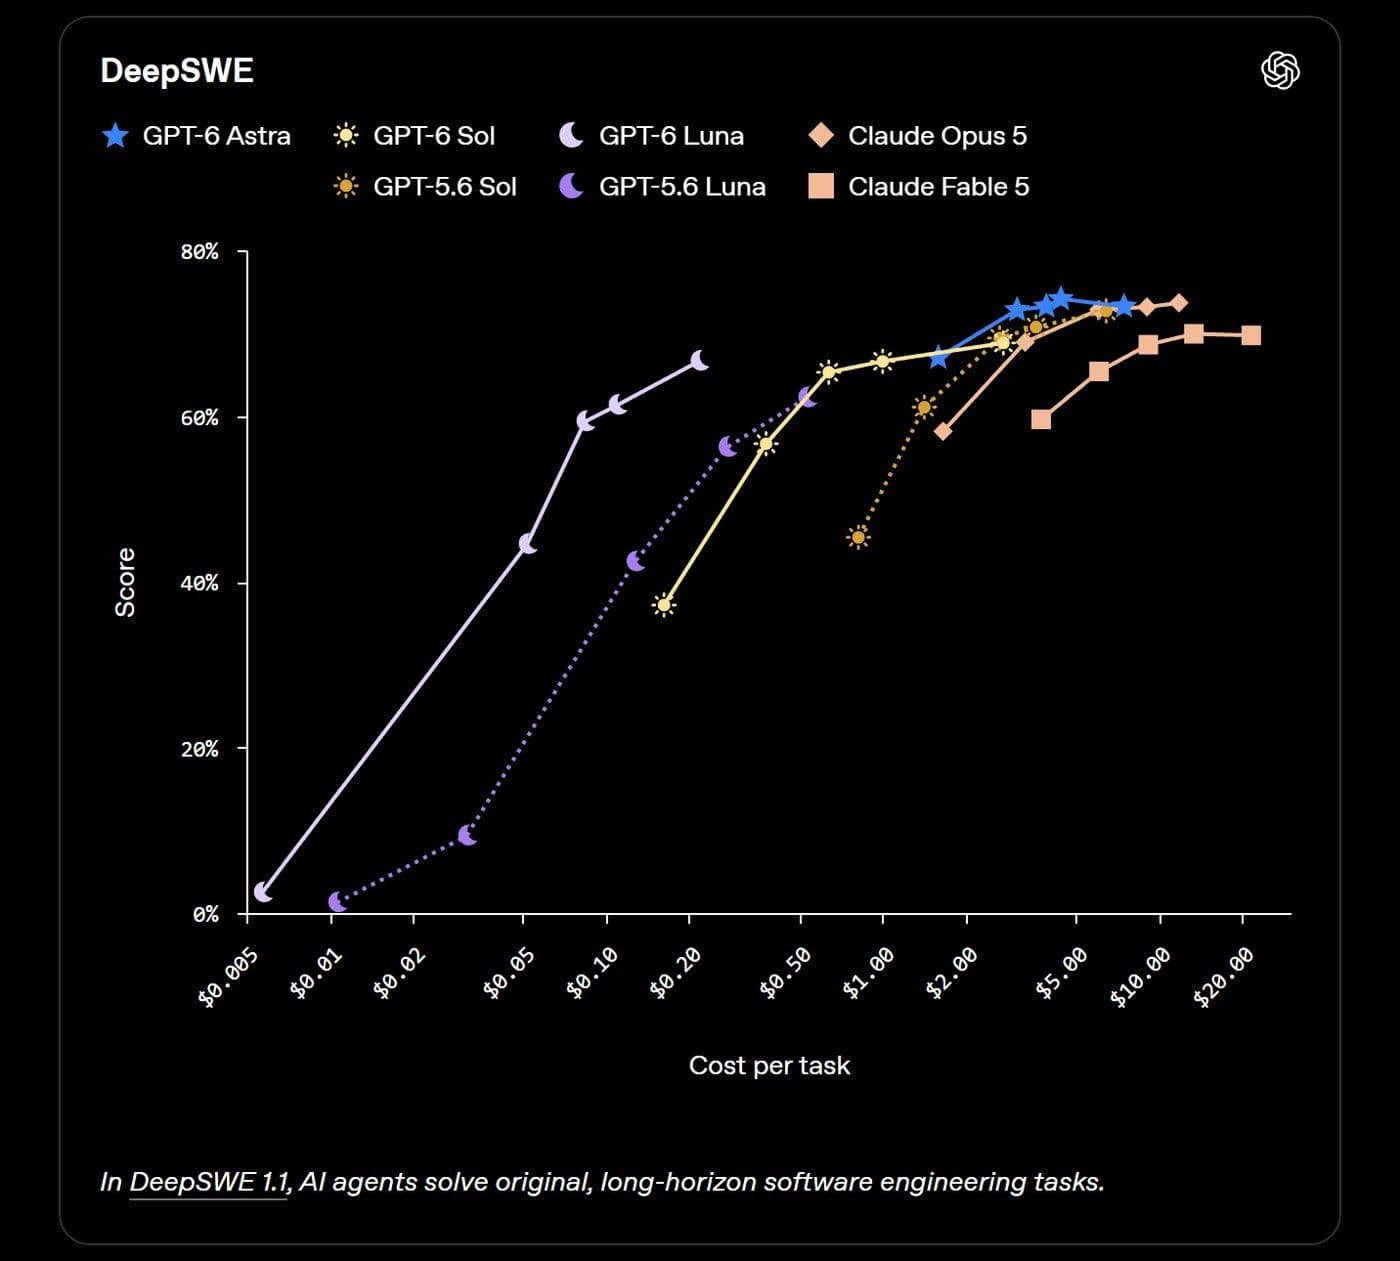
| DeepSWE — длинные задачи в реальных кодовых базах | 73,2% | 68,8% | 66,6% |
| OSWorld 2.0, офлайн — работа с компьютером | 73,5% | 64,4% | 52,7% |
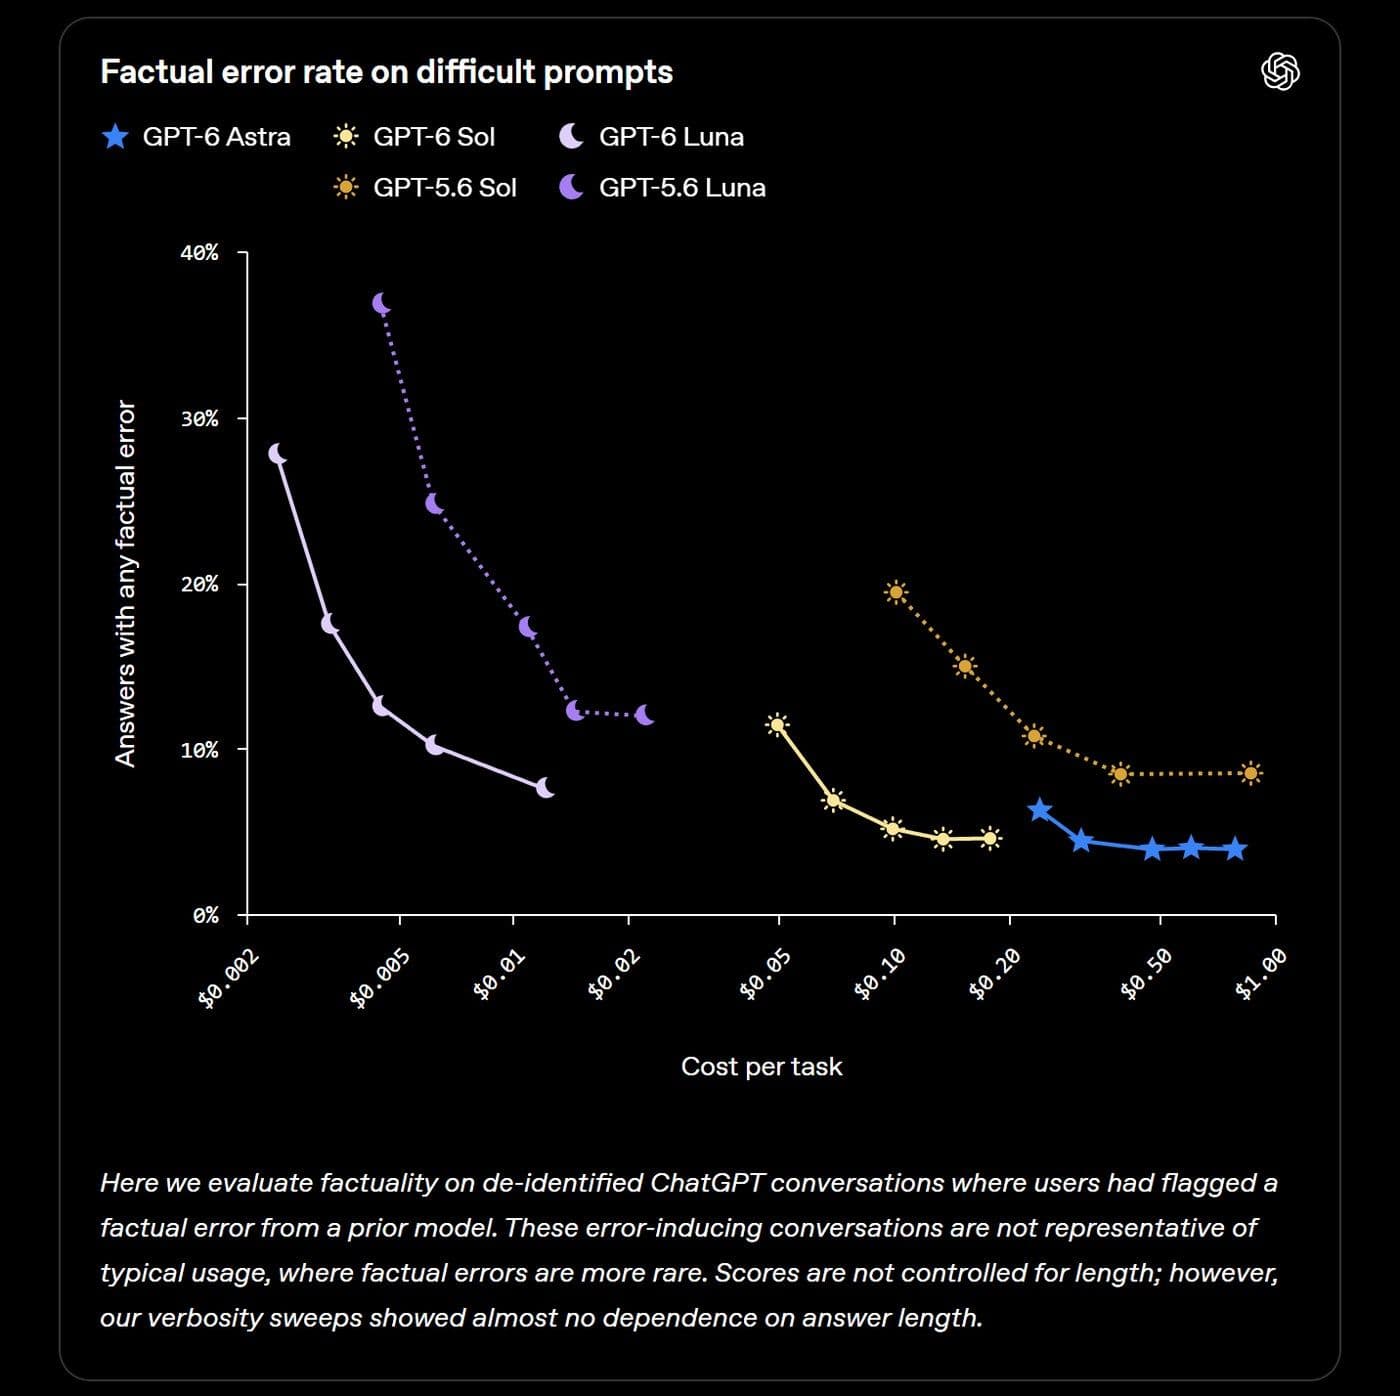
| Ответы с фактической ошибкой на трудных вопросах (меньше — лучше) | 3,9% | 4,6% | 7,6% |
| Обман в задачах по коду (меньше — лучше) | 0,5% | 1,3% | 2,8% |
Что из этого следует:
- На max Astra впереди во всех тестах, но отрыв разный. В работе с компьютером (computer use) и в автоматизации бизнес-процессов он большой, а в DeepSWE Luna отстаёт от Astra всего на 6,6 п. п.
- В длинных задачах по коду Luna на максимуме близка к Sol. В DeepSWE разница 2,2 п. п., а задача у Luna на max, по оценке OpenAI, обходится примерно в 12 раз дешевле, чем у Sol на max.
- Sol почти догоняет Astra по фактам: 4,6% ответов с ошибкой против 3,9%, а на ступени xhigh у Sol даже 4,5%.
- Максимум — не всегда лучший результат. У Sol в AutomationBench ступень xhigh дала 33,2%, больше, чем max; у Astra в DeepSWE лучший результат тоже на xhigh — 74,1%.
Оговорка про OSWorld: здесь это офлайн-набор OpenAI с частичной оценкой. С цифрами OSWorld 2.0 из анонса Anthropic их сравнивать нельзя — методика другая.
С чего начинать: с Luna, Sol или Astra?
С Luna на ступени «Глубже». Потом поднимать ступень, и только потом менять модель. Такой порядок дешевле всего: по графикам OpenAI, даже на «Максимуме» задача у Luna почти во всех тестах обходится дешевле, чем у Sol на самой низкой ступени.
Почему «Глубже», а не «Обычно» или «Быстрее»: на низких ступенях Luna плохо справляется с многошаговыми задачами. По данным OpenAI, на ступени low она набирает в AutomationBench 1,2%, в DeepSWE — 2,4%, а на high — уже 14,5% и 59,3%. Для вопроса в одно действие хватит и «Обычно», для задач в несколько шагов ставьте не ниже «Глубже».
Дальше — «Ещё глубже» и «Максимум». Прирост они не гарантируют: у Luna в AutomationBench ступень xhigh дала 12,6% против 14,5% на high. Поднимайте ступень, когда ответ выходит поверхностным, и проверяйте результат на своей задаче.
Ступень иногда даёт больше, чем смена модели. В DeepSWE Luna на max (66,6%) обходит Sol на medium (56,6%) и при этом, по оценке OpenAI, дешевле за задачу. А вот в AutomationBench даже Luna на max (20,7%) не дотягивает до Sol на low (21,2%): бизнес-процессы с десятками инструментов лучше сразу отдавать Sol.
Как понять, что пора переходить на модель старше?
Когда ступень подняли, а результат не изменился. Вот признаки, по которым видно, что Luna упёрлась в потолок и задачу пора отдать Sol, а Sol — Astra:
- На «Максимуме» ответ всё ещё поверхностный: модель пересказывает задачу вместо решения или теряет часть условий.
- Модель путает факты, а проверять их самому долго. По данным OpenAI, у Sol ошибок в фактах заметно меньше, чем у Luna на тех же ступенях: на medium 6,9% ответов с ошибкой против 17,5%.
- Агент сбивается на длинной цепочке инструментов: теряет шаги, повторяет вызовы, не доводит процесс до конца. Это профиль AutomationBench, где Sol сильно впереди Luna.
- Код работает, но принимать его в проект не хочется: нет тестов, лишние правки, чужой стиль. Именно это проверяет FrontierCode.
- Задача разовая и дорогая. Тогда не экономьте на попытках: сразу Sol, при необходимости Sol Pro или Astra.
Работает и обратное правило. Если Sol или Astra стабильно справляется с задачей на «Обычно», попробуйте ту же задачу на Luna с «Глубже» — вполне возможно, вы переплачиваете.
Как выбрать модель GPT-6 под конкретную задачу?
Пройдите по вопросам сверху вниз и остановитесь на первом, который подходит.
- Короткий вопрос, письмо, перевод, пересказ? → GPT-6 Luna, ступень «Обычно» или «Глубже».
- Документ, таблица, задача в несколько шагов? → GPT-6 Luna на «Глубже». Ответ поверхностный — «Ещё глубже» или «Максимум».
- Бизнес-процесс с инструментами, сложная аналитика, агент? → GPT-6 Sol на «Глубже» или «Ещё глубже». По данным OpenAI, в AutomationBench Sol на xhigh (33,2%) обходит даже Astra на low (30,3%), а задача у такой Astra в 3,9 раза дороже.
- Код? → начните с Luna на «Глубже» или «Максимум». Если нужен код, готовый к слиянию, — с тестами и по стандартам проекта, — берите Sol: в FrontierCode она набирает 49,3% против 42,4% у Luna (обе на max).
- Важна точность фактов? → Sol: по данным OpenAI, ошибок в фактах у неё меньше, чем у Luna, на любой ступени.
- Задача разовая и трудная, ошибка дорогая, подождать не страшно? → Pro-версия модели, выбранной выше: Luna Pro или Sol Pro.
- Тариф СТАРТ, и Luna не хватает? → Luna Pro или Astra: Sol на СТАРТ недоступна.
- Ничего не справилось или задача на пределе возможного? → GPT-6 Astra, а на тарифе Про — и Astra Pro.
Когда нужны Pro-версии?
Когда задача трудная и качество важнее скорости и расхода. Pro — та же модель в режиме рассуждений pro. Цена токена у Sol Pro и Luna Pro как у обычных версий, но в наших пробных запросах 23 сентября короткий вопрос в Pro обходился в 2–14 раз дороже, а ответ приходил целиком после паузы в 3–8 секунд. Выборка маленькая — по одному вопросу на модель, — а бенчмарков Pro в анонсе OpenAI нет. Поэтому Pro — не режим «на всякий случай». Подробный разбор — GPT-6 Sol Pro и Luna Pro.
Что такое GPT Luna Latest и GPT Sol Latest?
Это псевдонимы, которые всегда ведут на свежую версию семейства. С 23 сентября GPT Luna Latest ведёт на GPT-6 Luna, а GPT Sol Latest — на GPT-6 Sol. В интерфейсе у такой модели значок ↻, а показывается имя модели, на которую псевдоним ведёт сейчас.
Псевдоним удобно закреплять у ИИ-агентов и в рабочих чатах: выходит новая версия — агент переезжает на неё сам, перенастраивать ничего не нужно. Кто закрепил GPT Luna Latest или GPT Sol Latest, уже работает с GPT-6. Если агенту важно неизменное поведение — например, он отвечает клиентам по выверенному сценарию, — закрепите конкретную версию, а новую проверьте отдельно. Подробнее — модели Latest: свежая версия автоматически.
Почему в каталоге нет версий GPT-6 с пометкой «(batch)»?
Потому что в чате они не работают. У OpenRouter версии «(batch)» — это пакетный режим для отложенной обработки больших объёмов запросов. Мы проверили: провайдер отвечает, что для диалога эти версии использовать нельзя. Это инструмент разработчиков для массовой обработки, а не модель для живой переписки, поэтому в каталоге СуперИнтеллекта их нет.
Как переключаться между моделями GPT-6 в чате?
Одним кликом, в том же чате: история и промпты сохраняются. Удобно задать один вопрос Luna и Sol и сравнить ответы на своей задаче — это надёжнее любой таблицы.
- Нажмите кнопку выбора модели в поле ввода и выберите GPT-6 Luna, Sol или Astra.
- Рядом — чип «Модель · Ступень»: откроется попап «Усилие» со шкалой «Быстрее ↔ Умнее». У Sol и Luna шесть ступеней — от «Без раздумий» до «Максимум».
- Выбор ступени запоминается в чате. Для ИИ-агента ступень задаётся в его настройках.
- Прикладывайте файлы, изображения, PDF и таблицы. Модели умеют вызывать инструменты платформы: поиск в интернете, выполнение кода, базы знаний.
Работает в России без VPN и зарубежной карты, регистрация бесплатная: my.suin.ai.
Читать также: обзор GPT-6 Sol, обзор GPT-6 Luna, GPT-6 Sol Pro и Luna Pro, обзор GPT-6 Astra.