
Обучения
Claude Sonnet 5.5 или GPT-6 Sol: что выбрать — тесты, цена и сценарии
По таблице Anthropic Claude Sonnet 5.5 обходит GPT-6 Sol во всех четырёх общих тестах (в коде — немного и только на Xhigh), а цена токена у моделей одинаковая. Разбираем цифры и оговорки к ним, объясняем прочерки, подсказываем, кому какая модель подойдёт, и как сравнить их в одном чате.
Команда СуперИнтеллекта · · ~7 мин
Claude Sonnet 5.5 или GPT-6 Sol — на 29 сентября 2026 года, по данным Anthropic, сильнее Sonnet 5.5: она впереди во всех четырёх тестах, где есть цифры обеих моделей, а цена токена в обычных запросах у них одинаковая. Отрыв большой в работе с документами и задачах разных профессий и небольшой в программировании, где Sonnet 5.5 обходит GPT-6 Sol только на ступени Xhigh. Важная оговорка: сравнение опубликовала Anthropic в анонсе своей модели, а OpenAI сравнения с Sonnet 5.5 не публиковала. В СуперИнтеллекте обе модели работают в России без VPN: Claude Sonnet 5.5 — с тарифа СТАРТ, GPT-6 Sol — с тарифа Про.
Что общего у Claude Sonnet 5.5 и GPT-6 Sol?
Обе — модели среднего уровня в своих семействах, с одинаковой ценой токена и окном контекста около миллиона токенов, поэтому их и ставят рядом. Токены — кусочки текста, по которым считаются объём и оплата. Claude Sonnet 5.5 вышла 28 сентября 2026 года и стоит в семействе Claude 5.5 между старшей Opus 5.5 и обещанной младшей Haiku 5.5. GPT-6 Sol вышла 22 сентября и стоит в семействе GPT-6 между флагманом Astra и экономичной Luna — о запуске мы писали в новости о GPT-6 Sol и Luna.
Кто сравнивал Claude Sonnet 5.5 и GPT-6 Sol?
Сравнение сделала Anthropic: GPT-6 Sol стоит отдельным столбцом в таблице результатов в анонсе Sonnet 5.5. OpenAI своего сравнения с новой Claude не публиковала — GPT-6 Sol вышла на шесть дней раньше, и в её анонсе Sonnet 5.5 быть не могло. Поэтому всё ниже — взгляд одной из сторон, а не независимый рейтинг.
Часть цифр для GPT-6 Sol при этом получена не Anthropic: оценки GDPval-AA и AA-Briefcase — официальные результаты независимой Artificial Analysis, а Chartography — оценки Surge AI. Прочерк в таблице означает, что данных нет, а не что модель провалила тест. Для Terminal-Bench Anthropic прямо пишет, что ни авторы теста, ни OpenAI не публиковали результат GPT-6 Sol, поэтому на графике этого теста вместо неё показана прошлая GPT-5.6 Sol.
Как Sonnet 5.5 и GPT-6 Sol выступают в тестах?
В четырёх тестах, где есть цифры обеих моделей, Sonnet 5.5 выше: сильнее всего — в работе с документами и задачах профессий, меньше всего — в программировании.
| Тест (что проверяет) | Claude Sonnet 5.5 | GPT-6 Sol | Разница |
|---|---|---|---|
| FrontierCode 1.1 Main (код, готовый к слиянию) | 52,1% (Xhigh); 46,2% (Max) | 49,3% | +2,8 у Sonnet на Xhigh; −3,1 на Max |
| GDPval-AA v2.1 (реальная работа 44 профессий, Эло) | 1844 | 1487 | +357 у Sonnet |
| AA-Briefcase v1.1 (долгая работа с документами, Эло) | 1811 | 1483 | +328 у Sonnet |
| Chartography (распознавание графиков, без инструментов) | 61,6% | 53,6% | +8,0 у Sonnet |
| Terminal-Bench 4.0 (программирование в терминале) | 70,6% (Max) | — | нет данных |
| CursorBench 4.0 (задачи из сессий Cursor) | 55,5% | — | нет данных |
| Humanity's Last Exam (с инструментами) | 64,5% | — | нет данных |
| OSWorld 2.1 (работа с компьютером) | 80,1% | — | нет данных |
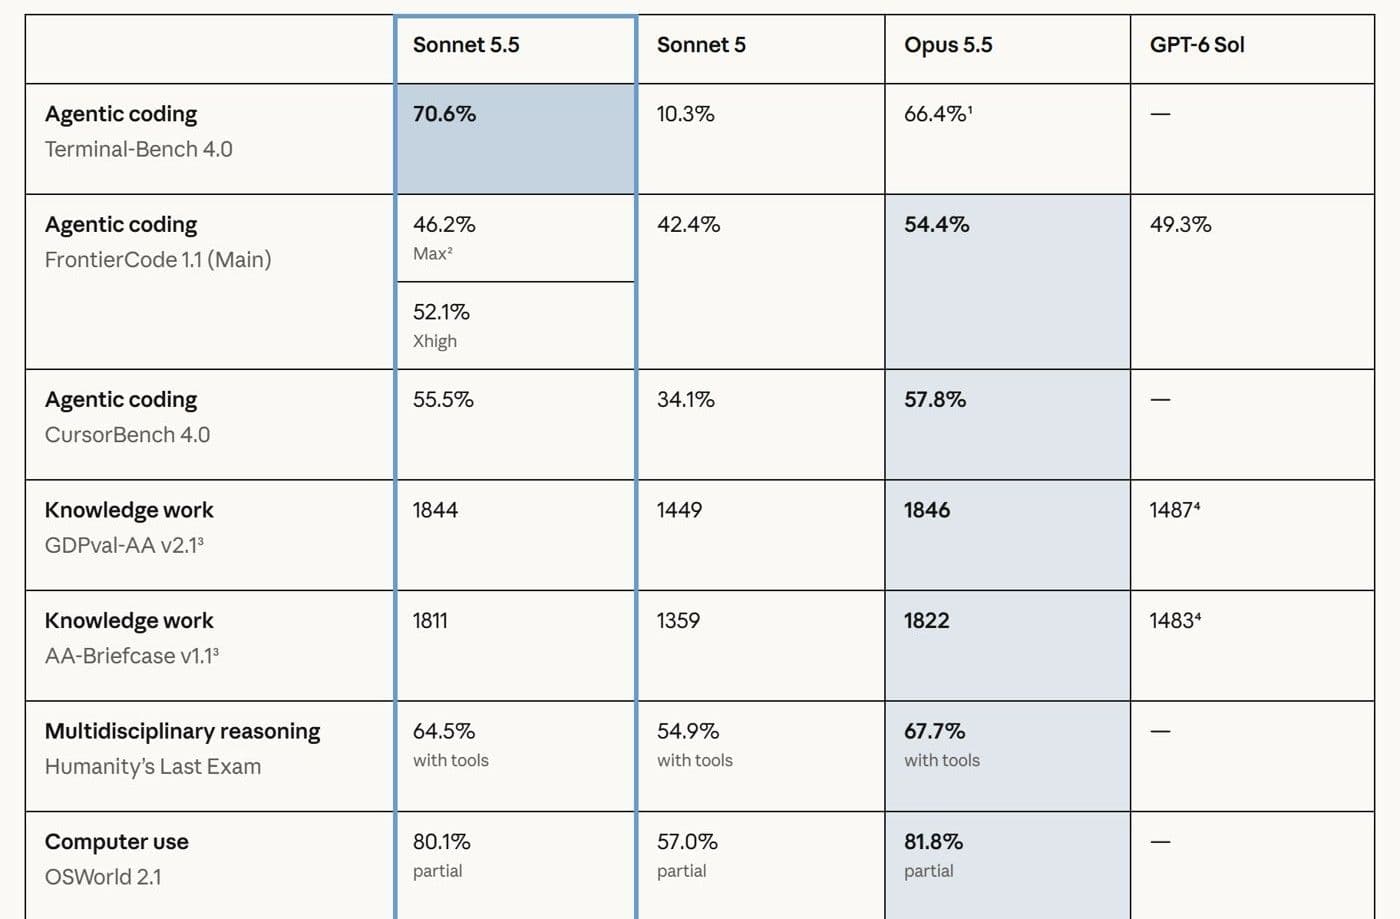
Эло — рейтинговая шкала, как в шахматах: модели сравнивают между собой, и разница в три с лишним сотни очков — это уверенный перевес, а не погрешность. Anthropic и сама подчёркивает, что в долгой интеллектуальной работе Sonnet 5.5 явно обходит и Sonnet 5, и GPT-6 Sol.
Чтение графиков — отдельная сильная сторона Sonnet 5.5: по сравнению с Sonnet 5 результат в Chartography вырос почти вчетверо, с 15,6% до 61,6%. Работу с изображениями вынесла в заголовок и российская пресса, например iPhones.ru.
Какие оговорки есть у этих цифр?
Оговорок три, и все касаются как раз общих тестов.
- Исправленный баг у GPT-6 Sol. OpenAI недавно исправила ошибку, которая ухудшала понимание изображений у GPT-6 Sol, и официальные оценки GDPval-AA, AA-Briefcase и Chartography могли ещё не учесть исправление. Artificial Analysis не ждёт заметного влияния на свои два теста, а внутренняя проверка Chartography, по словам Anthropic, изменений не показала.
- Баг у Sonnet 5.5. GDPval-AA и AA-Briefcase прогоняли на предрелизной версии Sonnet 5.5 с ошибкой в структурированных ответах. По оценке Anthropic, она могла разве что немного занизить результат, и её уже исправили.
- FrontierCode на Max. На максимальной ступени Sonnet 5.5 набрала меньше, чем на Xhigh: тест штрафует за правки за рамками задачи, а на Max модель чаще запускала ревью кода множеством субагентов — вспомогательных агентов, — и в разобранных случаях это кончалось таймаутом или лишними правками. Если держать Sonnet 5.5 на «Максимуме», в этом тесте она уступает GPT-6 Sol.
И общее правило: все цифры в этом материале взяты из анонса одного из участников сравнения. Самая надёжная проверка — ваша собственная задача.
Какая модель дешевле: Sonnet 5.5 или GPT-6 Sol?
В обычных запросах цена токена у моделей одинаковая: по каталогу OpenRouter у Claude Sonnet 5.5 и GPT-6 Sol совпадают ставки на входе, на выходе и за чтение из кэша. Разница одна: запросы длиннее 272 тыс. токенов у GPT-6 Sol оплачиваются по повышенной ставке. Итоговая стоимость задачи зависит от того, сколько токенов модель потратит на рассуждения и ответ.
Про Sonnet 5.5 известно, что она экономнее предшественницы: в тестах Anthropic задача обходится до 30% дешевле, чем у Sonnet 5, при той же цене токена. В Balyasny Asset Management на 2 441 финансовой задаче модель тратила около 121 тыс. токенов на ответ против 497 тыс. у Sonnet 5. Прямого сравнения расхода токенов с GPT-6 Sol в анонсе нет. В СуперИнтеллекте нейроны списываются по фактическому расходу токенов, поэтому экономная модель тратит меньше.
Кому подойдёт Claude Sonnet 5.5, а кому GPT-6 Sol?
По данным Anthropic, Sonnet 5.5 заметно сильнее в работе с документами и графиками, а в коде модели близки. GPT-6 Sol стоит держать под рукой как модель другого разработчика — для второго мнения и там, где под неё уже настроена ваша работа.
- Документы, отчёты, долгая работа с файлами → Claude Sonnet 5.5: отрыв в AA-Briefcase и GDPval-AA больше 300 очков Эло.
- Графики и диаграммы → Claude Sonnet 5.5: 61,6% против 53,6% в Chartography.
- Презентации и таблицы → Claude Sonnet 5.5: тестировщики отмечают у неё чутьё на дизайн и умение следовать шаблону слайдов, хотя прямого сравнения с GPT-6 Sol здесь нет.
- Код → разница небольшая, 52,1% против 49,3% во FrontierCode на Xhigh; сравните обе модели на своём проекте.
- Промпты и процессы уже отлажены на GPT-6 Sol → оставайтесь на ней и проверьте Sonnet 5.5 на паре типовых задач, прежде чем переезжать.
- Нужно второе мнение → спросите вторую модель: модели разных разработчиков могут ошибаться по-разному.
- У вас тариф СТАРТ → Claude Sonnet 5.5: GPT-6 Sol открывается с тарифа Про.
Чем GPT-6 Sol сильна по собственным данным OpenAI — ступени рассуждений, кэширование, результаты из её анонса, — мы разбирали в обзоре GPT-6 Sol, а как она соотносится с Astra и Luna — в шпаргалке по выбору GPT-6.
Как сравнить Claude Sonnet 5.5 и GPT-6 Sol в одном чате?
Дайте обеим моделям одну задачу в одном чате СуперИнтеллекта: модель переключается одним кликом, историю и промпты переписывать не нужно.
- Зарегистрируйтесь бесплатно и подключите тариф Про — на нём доступны обе модели.
- Выберите Claude Sonnet 5.5, отправьте задачу из своей работы и приложите файлы, если они нужны.
- Переключите модель на GPT-6 Sol и попросите решить ту же задачу с нуля, не опираясь на предыдущий ответ.
- Сравните точность, оформление, время ответа и сколько нейронов ушло на каждый ответ.
Кэш — сохранённое начало запроса — у каждой модели свой, поэтому первый ответ после переключения обходится дороже. В нашем замере с Sonnet 5.5 следующие ходы в том же чате выходили примерно в 10 раз дешевле первого, так что сравнивайте расход не по первому сообщению. О ступенях рассуждений, файлах и инструментах — в гайде как пользоваться Claude Sonnet 5.5.
Частые вопросы
Что лучше: Claude Sonnet 5.5 или GPT-6 Sol?
По таблице Anthropic — Sonnet 5.5: она впереди во всех четырёх общих тестах, хотя во FrontierCode только на ступени Xhigh. Собственного сравнения с Sonnet 5.5 у OpenAI нет.
Почему у GPT-6 Sol в таблице прочерки?
Для этих тестов нет опубликованных результатов GPT-6 Sol. Прочерк означает отсутствие данных, а не проигрыш.
Какая модель дешевле?
Цена токена в обычных запросах одинаковая. Стоимость задачи зависит от того, сколько токенов потратит модель; прямого сравнения расхода в анонсе нет.
Какая модель лучше для кода?
Разница невелика: во FrontierCode Sonnet 5.5 на Xhigh набрала 52,1% против 49,3% у GPT-6 Sol, а на Max — 46,2%. Проверьте обе модели на своём коде.
На каком тарифе доступны модели в СуперИнтеллекте?
Claude Sonnet 5.5 — с тарифа СТАРТ, GPT-6 Sol — с тарифа Про. На бесплатном тарифе работают GPT-6 Luna и Gemini 3.8 Flash.
Нужен ли VPN, чтобы пользоваться ими в России?
Нет. В СуперИнтеллекте обе модели работают из России без VPN и зарубежной карты, оплата в рублях.
Читать также: Обзор Claude Sonnet 5.5 · Sonnet 5.5 или Opus 5.5: что выбрать · Обзор GPT-6 Sol