Claude Sonnet 5.5 — модель Anthropic среднего класса, вышедшая 28 сентября 2026 года: она на 30% с лишним быстрее Sonnet 5, до 30% дешевле за задачу и во многих тестах почти догоняет флагман Claude Opus 5.5. Это вторая модель семейства Claude 5.5 после Opus 5.5 и прямой преемник Sonnet 5. Сильнее всего она на понятных повседневных задачах, в исправлении ошибок в коде и в создании документов, презентаций и таблиц.
Ниже — характеристики, все тесты из анонса со сносками, экономичность, отзывы ранних клиентов, безопасность и ограничения. В СуперИнтеллекте модель доступна с 29 сентября на тарифе СТАРТ и выше — без VPN и зарубежной карты.
Что такое Claude Sonnet 5.5 и где она в линейке Anthropic?
Claude Sonnet 5.5 — средняя модель семейства Claude 5.5, между флагманом Opus 5.5 и будущей Haiku 5.5. Anthropic делит работу так: Opus 5.5 — для сложной открытой работы, где нужно долго держать суждение, Sonnet 5.5 — для чётко поставленных повседневных задач, где важны скорость и цена. Haiku 5.5 для больших объёмов компания обещает в ближайшие недели.
| Модель | Для каких задач | Цена токена | В СуперИнтеллекте |
|---|---|---|---|
| Claude Opus 5.5 | Сложная открытая работа, долгое суждение, архитектура | Вдвое выше, чем у Sonnet 5.5; чтение из кэша — так же | С тарифа Про |
| Claude Sonnet 5.5 | Повседневные задачи, ошибки в коде, документы, презентации, таблицы | Как у Sonnet 5 | С тарифа СТАРТ |
| Claude Haiku 5.5 | Большие объёмы, экономные сценарии | — | Ещё не вышла |
От Sonnet 5 новая модель отличается скоростью, экономией и стилем: пишет яснее, как Opus 5.5, и, по словам тестировщиков, лучше подходит для совместной работы. Она хорошо чувствует дизайн, а ещё это первая Sonnet, прошедшая Pokémon Red только по скриншотам, — проверка на длинные задачи и понимание изображений. Подробно — в разборе Sonnet 5.5 против Sonnet 5.
Какие характеристики у Claude Sonnet 5.5?
У Claude Sonnet 5.5 контекст 1 000 000 токенов, ответ до 128 000 токенов и пять ступеней рассуждений. Токены — кусочки текста, по которым модели считают объём и стоимость.
| Параметр | Значение |
|---|---|
| Дата выхода | 28 сентября 2026 года |
| Контекст | 1 000 000 токенов |
| Максимальный ответ | 128 000 токенов |
| Вход | Текст, изображения, файлы |
| Ступени рассуждений | Low, Medium, High, Xhigh, Max; режима без рассуждений нет |
| Скорость | На 30% с лишним быстрее Sonnet 5, самая быстрая Sonnet на сегодня |
| Цена токена | Как у Sonnet 5; у Opus 5.5 вдвое выше, кроме чтения из кэша |
| Цена задачи | До 30% ниже, чем у Sonnet 5, по тестам Anthropic |
| В СуперИнтеллекте | С 29 сентября 2026 года, с тарифа СТАРТ |
Ступень рассуждений — это сколько модель думает перед ответом: на низких она быстрее и экономнее, на высоких дольше рассуждает и тщательнее проверяет себя. В приложениях Anthropic по умолчанию стоит Medium, на платформе для разработчиков — High. Как ступени устроены в нашем чате — в материале о слайдере глубины размышлений.
Как Claude Sonnet 5.5 выступает в тестах?
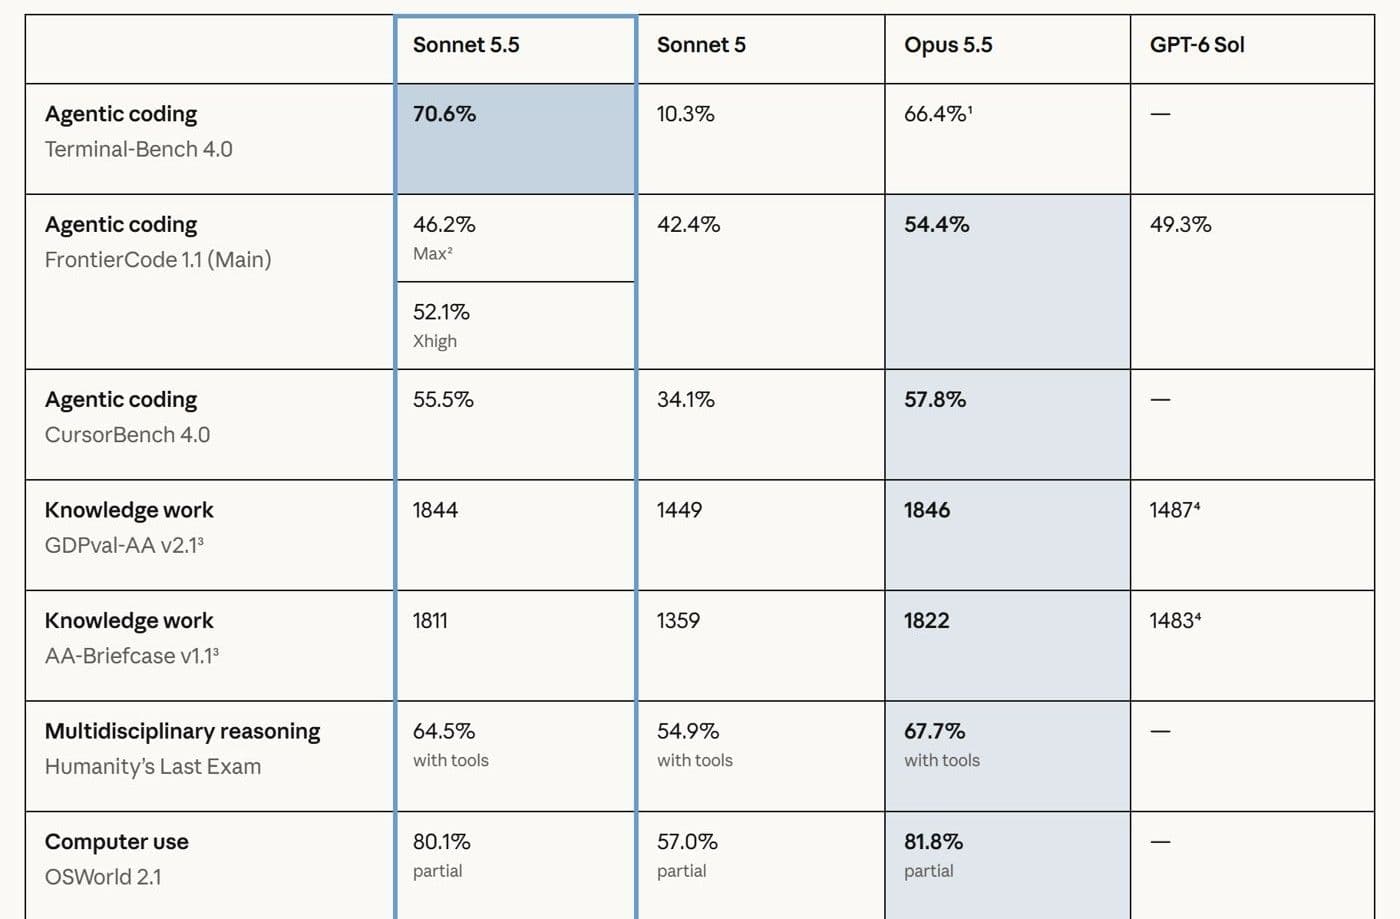
По тестам Anthropic Sonnet 5.5 резко обгоняет Sonnet 5, почти везде подходит вплотную к Opus 5.5, а в агентном программировании в терминале даже опережает его: 70,6% против 66,4% у Opus на ступени Xhigh. Агентный режим — когда модель сама выполняет шаги: запускает команды, правит файлы, проверяет результат. Но в анонсе Anthropic оговаривает: тесты — лишь одна грань, а в сложной открытой работе с долгим суждением Opus 5.5 заметно сильнее.
| Тест (что проверяет) | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (агентное программирование в терминале) | 70,6% | 10,3% | 66,4% (Xhigh)¹ | — |
| FrontierCode 1.1 Main (готов ли код к слиянию без правок) | 46,2% (Max)²; 52,1% (Xhigh) | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 (задачи из реальных сессий Cursor) | 55,5% | 34,1% | 57,8% | — |
| GDPval-AA v2.1³ (реальная работа 44 профессий, рейтинг Эло) | 1844 | 1449 | 1846 | 1487⁴ |
| AA-Briefcase v1.1³ (долгая работа с документами, рейтинг Эло) | 1811 | 1359 | 1822 | 1483⁴ |
| Humanity's Last Exam (трудные вопросы из многих наук, с инструментами) | 64,5% | 54,9% | 67,7% | — |
| OSWorld 2.1 (работа с компьютером, частичная оценка) | 80,1% | 57,0% | 81,8% | — |
| Chartography (распознавание графиков, без инструментов) | 61,6% | 15,6% | 64,4% | 53,6%⁴ |
- ¹ У Opus 5.5 — результат на ступени Xhigh, его лучший в этом тесте.
- ² На Max результат ниже, чем на Xhigh, — разбор ниже.
- ³ Тесты проводила Artificial Analysis на предрелизной версии с багом в структурированных ответах; по оценке Anthropic, эффект если и есть, то мал и скорее занижает результат. Баг исправлен.
- ⁴ OpenAI недавно исправила в GPT-6 Sol баг понимания изображений, и оценки могли не обновиться. Artificial Analysis не ждёт заметного влияния на GDPval-AA и AA-Briefcase, а внутренняя проверка Chartography влияния не показала.
Рейтинг Эло — относительная шкала, как в шахматах: важна разница между моделями. В GDPval-AA Sonnet 5.5 всего на 2 пункта ниже Opus 5.5 и примерно на 400 выше Sonnet 5.
Программирование
В коде скачок заметнее всего. В Terminal-Bench 4.0 — многошаговые задачи в командной строке — результат вырос с 10,3% до 70,6%; на графике Anthropic это точка ступени Max, и она выше лучшего результата Opus 5.5. В CursorBench, собранном из реальных сессий в редакторе Cursor, Sonnet 5.5 отстаёт от Opus 5.5 примерно на два пункта. Тестировщики отмечают, что модель быстро разбирается в кодовой базе и чаще объединяет вызовы инструментов в пачки, поэтому шагов меньше.
Почему во FrontierCode на Max результат ниже, чем на Xhigh?
На Max Sonnet 5.5 набрала 46,2%, а на ступень ниже, на Xhigh, — 52,1%. Тест проверяет, можно ли принять изменение в код без правок человека, и штрафует за правки за рамками задачи, даже полезные. На Max модель чаще запускала развёрнутое ревью кода, раскидывая проверку по множеству субагентов — вспомогательных агентов. В двух случаях, которые разобрала компания Cognition, это закончилось тайм-аутом или лишними правками. Вывод: максимальная ступень не всегда лучшая, особенно для точечной правки.
Документы, данные, компьютер и графики
В GDPval-AA — реальные задачи 44 профессий из девяти отраслей — Sonnet 5.5 почти вровень с Opus 5.5, а в AA-Briefcase, где нужна долгая работа с документами, уверенно обходит Sonnet 5 и GPT-6 Sol. Во внутреннем тесте Anthropic модель по квартальной отчётности публичной компании, расшифровкам звонков и шаблону слайдов собрала операционный обзор на 10 слайдов, и два эксперта сочли первый черновик готовым к отправке как есть.
В OSWorld 2.1 модель сама управляет компьютером: с частичной оценкой у неё 80,1% против 57,0% у Sonnet 5 и 81,8% у Opus 5.5. В Chartography, где графики читают без инструментов, результат вырос с 15,6% до 61,6%, в Humanity's Last Exam с инструментами — с 54,9% до 64,5%.
Насколько Claude Sonnet 5.5 экономичнее Sonnet 5 и Opus 5.5?
Токен Sonnet 5.5 стоит как у Sonnet 5, но токенов на ту же работу уходит меньше, поэтому в тестах Anthropic задача дешевле до 30%. У Opus 5.5 токен вдвое дороже на входе, на выходе и при записи в кэш; чтение из кэша у обеих стоит одинаково. Кэш — сохранённое начало запроса, которое не обрабатывается заново и стоит намного дешевле.
- Дешёвые ступени сильнее прошлого максимума. На нескольких тестах Sonnet 5.5 на Low или Medium обходит лучший результат Sonnet 5 примерно за десятую часть стоимости задачи.
- FrontierCode на High: на 10 пунктов выше Sonnet 5 на той же ступени примерно за 1/15 стоимости.
- Против Opus 5.5 Sonnet 5.5 выгоднее всего на низких ступенях; на высоких она может показывать сопоставимый результат примерно за те же деньги.
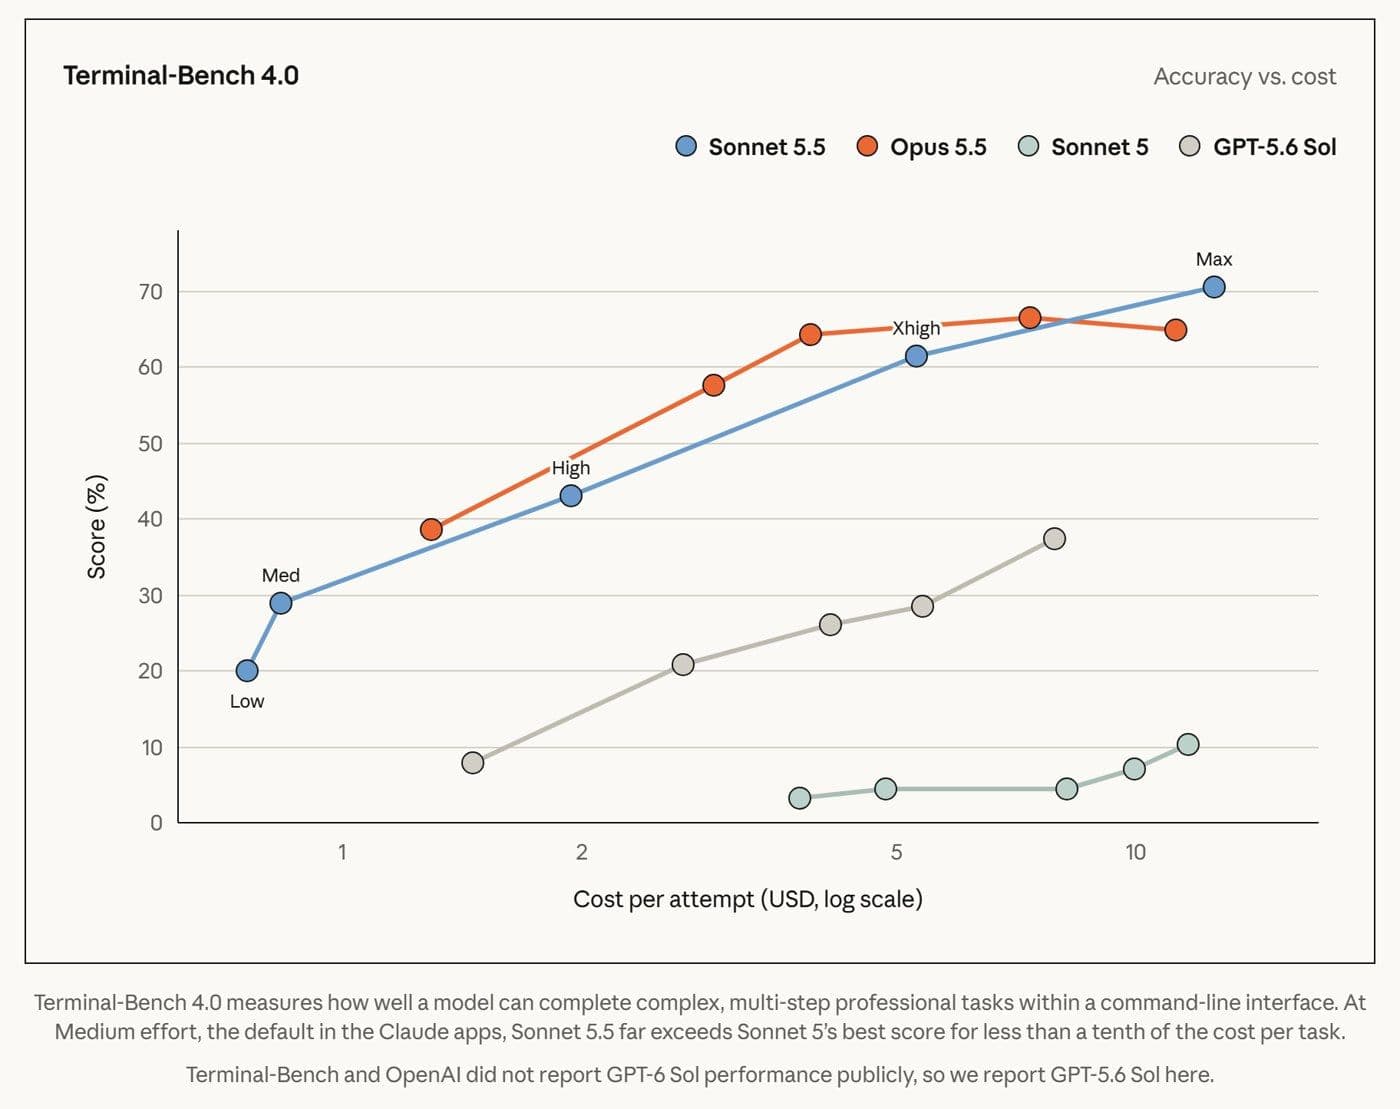
Чем выше ступень, тем дольше модель работает и тем дороже попытка, но и результат обычно выше; лучшие точки — в левом верхнем углу. Уже на Medium, умолчании приложений Anthropic, Sonnet 5.5 намного выше лучшего результата Sonnet 5 меньше чем за десятую часть стоимости.
В нашем замере в СуперИнтеллекте первый ход в новом чате дороже следующих: платформа передаёт модели описания инструментов, и они записываются в кэш. Дальше почти весь запрос читается из кэша, и ходы того же чата примерно в 10 раз дешевле. Поэтому длинную работу выгоднее вести в одном чате.
Что говорят о Claude Sonnet 5.5 первые клиенты?
Компании, получившие модель до релиза, хвалят скорость, экономию токенов и то, что задачи доходят до конца за меньшее число шагов. Ниже — пересказ отзывов из анонса Anthropic; это данные партнёров, а не независимые исследования.
Программирование и разработка
- Epic Games: модель взяла планку качества старшей модели на аудите архитектуры и разборе потоков данных, справлялась с десятками тысяч строк кода и многочасовыми задачами, а подробные инструкции ей нужны реже.
- CodeRabbit (сервис ревью кода): суждение лучше, чем у Sonnet 5, выходных токенов заметно меньше, лишние обращения к поиску пропали. Простые и средние ревью компания переводит на новую модель.
- SpaceXAI: 55,5% в CursorBench 4.0 — второе место после Opus 5.5.
- Base44: 118 реальных сборок приложений на уровне Opus 5, но в среднем за 3,6 итерации против 7,7 у Opus 5; меньше всех сбоев при вызове инструментов, модель редко останавливается с вопросами.
- Unity: 90% задач многошагового теста по Unity Editor и коду; большая часть работы прошла проверку запуском проекта.
- Lovable: на треть меньше вызовов инструментов и примерно вдвое меньше запусков командной оболочки.
- Creator: когда архитектуру игры задаёт Opus 5.5, реализацию можно доверить Sonnet 5.5, в том числе в долгих сложных задачах.
«Быстрая в коде, и её можно быстро направлять в итеративной работе» — Тайлер Нишида, дизайнер Every.
В Every добавляют, что модель умеет и долго работать, если нужно, а от Opus 5.5 ей досталась часть улучшений в естественности текста.
Офис, поддержка и данные
- Slack: без изменения промптов лучше Sonnet 5 почти во всех офлайн-тестах Slackbot, за меньшее число шагов и примерно с 14% меньшим числом выходных токенов.
- Zendesk: на сотнях реальных обращений меньше неверных решений, тикеты обрабатываются на 20% быстрее, чем у моделей Claude, которыми компания пользуется сейчас.
- Balyasny Asset Management: в 2 441 финансовой задаче результат выше Sonnet 5 при примерно 121 тыс. токенов на ответ против 497 тыс. у Sonnet 5; для больших потоков задач — лучшее соотношение качества и цены среди семи протестированных моделей.
- Box: модель перепроверяет данные в исходных документах и ловит ошибки, которые пропускала Sonnet 5; по сравнению с прошлой моделью точнее, в 2,4 раза быстрее и на 12% экономнее по токенам.
- Atlassian: агенты Rovo работают до 30% быстрее, чем с Sonnet 5.
Насколько безопасна Claude Sonnet 5.5?
По данным Anthropic, по большинству показателей безопасного поведения Sonnet 5.5 не хуже Sonnet 5, а новые защиты — штатные меры, которые компания применяет и к своим сильнейшим моделям.
- Поведенческий аудит. Примерно на 1 850 сценариях модель лучше Sonnet 5 или на её уровне по большинству показателей — от честности до устойчивости к злоупотреблениям. Признаков, что она преследует цели вопреки намерениям пользователя, не нашли; Opus 5.5 в целом чуть лучше.
- Песочница. По редкости попыток выйти из изолированной среды Sonnet 5.5 близка к Opus 5.5 и реже всех моделей Anthropic проверяет на прочность границы своего контейнера.
- Кибербезопасность. Первая Sonnet с защитой уровня старших моделей: найти и исправить ошибку в коде можно как обычно, а рискованные задачи в этой области заметно для пользователя передаются Sonnet 5.
- Биология. Защита как у Sonnet 5; отдельные запросы по микробиологии и вирусологии могут быть по ошибке сочтены рискованными.
- Дистилляция. Классификаторы мешают массово выкачивать рассуждения модели через подставные аккаунты, а мышление привязано к аккаунту, который его создал.
Какие у Claude Sonnet 5.5 ограничения?
Главное ограничение — это не самая сильная модель Anthropic: в сложной открытой работе Opus 5.5 впереди.
- Opus 5.5 выше почти во всех тестах, пусть обычно и на несколько пунктов. Исключение — Terminal-Bench.
- Максимум не всегда лучший: во FrontierCode результат на Max ниже, чем на Xhigh.
- Рассуждения обязательны: режима без раздумий нет, самая быстрая ступень — Low (у нас — «Быстрее»).
- Цифры — от разработчика и партнёров, с оговорками о багах в предрелизной версии.
- Чувствительные темы: рискованные задачи по кибербезопасности уходят к Sonnet 5, отдельные запросы по биологии могут быть отклонены по ошибке.
- Для огромных объёмов Anthropic готовит Haiku 5.5, но она ещё не вышла.
Кому подойдёт Claude Sonnet 5.5?
Claude Sonnet 5.5 подойдёт всем, кому нужна сильная модель на каждый день без цены флагмана.
- Разработчикам — исправление ошибок, понятные задачи в большой кодовой базе, реализация по готовой архитектуре. Подробнее — в гайде Claude Sonnet 5.5 для программирования.
- Тем, кто делает документы, таблицы и презентации — модель следует шаблонам и перепроверяет данные; см. гайд про документы, таблицы и презентации.
- Аналитикам и финансистам — извлечение данных из отчётов, прогнозы, чтение графиков.
- Тем, кто строит ИИ-агентов — модель экономно вызывает инструменты и редко останавливается на полпути.
Для открытых задач с долгим суждением — архитектуры, стратегии, сложного исследования — берите Opus 5.5 или сравните обе модели; как выбирать, разбираем в материале Sonnet 5.5 или Opus 5.5. Хорошо работает и связка: Opus задаёт архитектуру, Sonnet её реализует.
Как попробовать Claude Sonnet 5.5 в России?
В России Claude Sonnet 5.5 доступна через СуперИнтеллект: с 29 сентября 2026 года она есть в каталоге и открыта с тарифа СТАРТ, а также на тарифах Про, ULTRA и командных — без VPN и зарубежной карты, с оплатой в рублях. На бесплатном тарифе её нет, там работают GPT-6 Luna и Gemini 3.8 Flash.
- В списке моделей она называется Claude Sonnet 5.5. Псевдоним Claude Sonnet Latest уже ведёт на неё: чаты и ИИ-агенты с ним работают с новой версией без перенастройки, а рядом с именем — значок ↻ и название модели, на которую он ведёт.
- Ступень выбирается в чипе «Модель · Ступень»: «Быстрее» (Low), «Обычно» (Medium), «Глубже» (High), «Ещё глубже» (Xhigh), «Максимум» (Max). Выбор запоминается в чате, у ИИ-агента ступень задаётся в настройках.
- Модель переключается в том же чате одним кликом — можно дать одну задачу Sonnet 5.5 и Opus 5.5 и сравнить.
- В чат можно прикладывать файлы, изображения, PDF и таблицы, а модель вызывает инструменты платформы: поиск в интернете, выполнение кода, базы знаний, подключённые сервисы.
- Нейроны списываются по фактическому расходу токенов, поэтому экономная модель тратит их меньше.
Пошагово — в гайде как пользоваться Claude Sonnet 5.5. Регистрация бесплатная: my.suin.ai/auth/register.
Частые вопросы
Claude Sonnet 5.5 лучше Opus 5.5?
Нет, в целом Opus 5.5 сильнее: он выше почти во всех тестах и заметно лучше в сложной открытой работе. Зато Sonnet 5.5 вдвое дешевле за токен на входе и выходе, быстрее и в Terminal-Bench 4.0 даже обходит Opus 5.5.
Сколько стоит Claude Sonnet 5.5?
По данным Anthropic, токен стоит как у Sonnet 5 и вдвое дешевле, чем у Opus 5.5, а задача обходится до 30% дешевле, чем у Sonnet 5. В СуперИнтеллекте модель доступна с тарифа СТАРТ, нейроны списываются по фактическому расходу токенов.
Какой контекст у Claude Sonnet 5.5?
1 000 000 токенов, ответ — до 128 000 токенов. В одном разговоре помещается несколько объёмных документов или крупные фрагменты кода.
Можно ли отключить рассуждения у Sonnet 5.5?
Нет, рассуждения обязательны, ступени «Без раздумий» у Sonnet 5.5 нет. Самая быстрая и экономная — «Быстрее» (Low); для простых задач её обычно хватает.
Claude Sonnet Latest — это уже Sonnet 5.5?
Да. Псевдоним Claude Sonnet Latest в СуперИнтеллекте уже ведёт на Sonnet 5.5, поэтому чаты и ИИ-агенты с ним перешли на новую версию сами. Если нужна прежняя версия, выберите в списке конкретную модель по имени, а не псевдоним.