Пользоваться GPT-6 Sol — моделью OpenAI, вышедшей 22 сентября 2026 года, — в России можно через СуперИнтеллект: зарегистрируйтесь, подключите тариф Про, выберите в чате GPT-6 Sol или GPT Sol Latest и поставьте ступень рассуждений под задачу. Главное правило: для повседневной работы хватает «Обычно» или «Глубже», для многошаговых задач лучше «Ещё глубже», а «Максимум», судя по данным OpenAI, не всегда даёт лучший результат.
Ниже — пошаговая инструкция: выбор модели и ступени, файлы и длинные документы, поиск и выполнение кода, агенты, экономия нейронов, семь готовых промптов и типичные ошибки. Что умеет модель и как она выступила в тестах, разобрано в обзоре GPT-6 Sol.
Как начать пользоваться GPT-6 Sol в России?
Начать можно за несколько минут: GPT-6 Sol работает в СуперИнтеллекте без VPN и зарубежной карты, а оплата идёт нейронами — они списываются по фактическому расходу токенов.
- Зарегистрируйтесь на my.suin.ai/auth/register — регистрация бесплатная.
- Подключите тариф Про или старший (ULTRA, командные): GPT-6 Sol и GPT-6 Sol Pro доступны с него. На бесплатном тарифе работает GPT-6 Luna.
- Откройте новый чат и нажмите кнопку выбора модели в панели ввода.
- Выберите GPT-6 Sol или GPT Sol Latest.
- Нажмите чип «Модель · Ступень» рядом с кнопкой модели и выберите ступень рассуждений — о них ниже.
Чем GPT-6 Sol отличается от GPT Sol Latest?
Сейчас это одна и та же модель: с 23 сентября псевдоним GPT Sol Latest ведёт на GPT-6 Sol. Разница появится в будущем: GPT-6 Sol — закреплённая версия, а псевдоним сам переключится на свежую версию Sol, когда она выйдет. В интерфейсе рядом с псевдонимом стоит значок ↻ и показывается имя модели, на которую он ведёт сейчас. Кто уже закрепил GPT Sol Latest в чате или у агента, работает с GPT-6 Sol — перенастраивать ничего не нужно. Как устроены такие псевдонимы, объясняет статья о моделях Latest.
Правило выбора простое: хотите получать новые версии Sol без перенастройки — берите GPT Sol Latest; важно, чтобы поведение модели не менялось без вашего ведома, например у агента, отлаженного под конкретный процесс, — закреплённую GPT-6 Sol.
Какую ступень рассуждений выбрать для GPT-6 Sol?
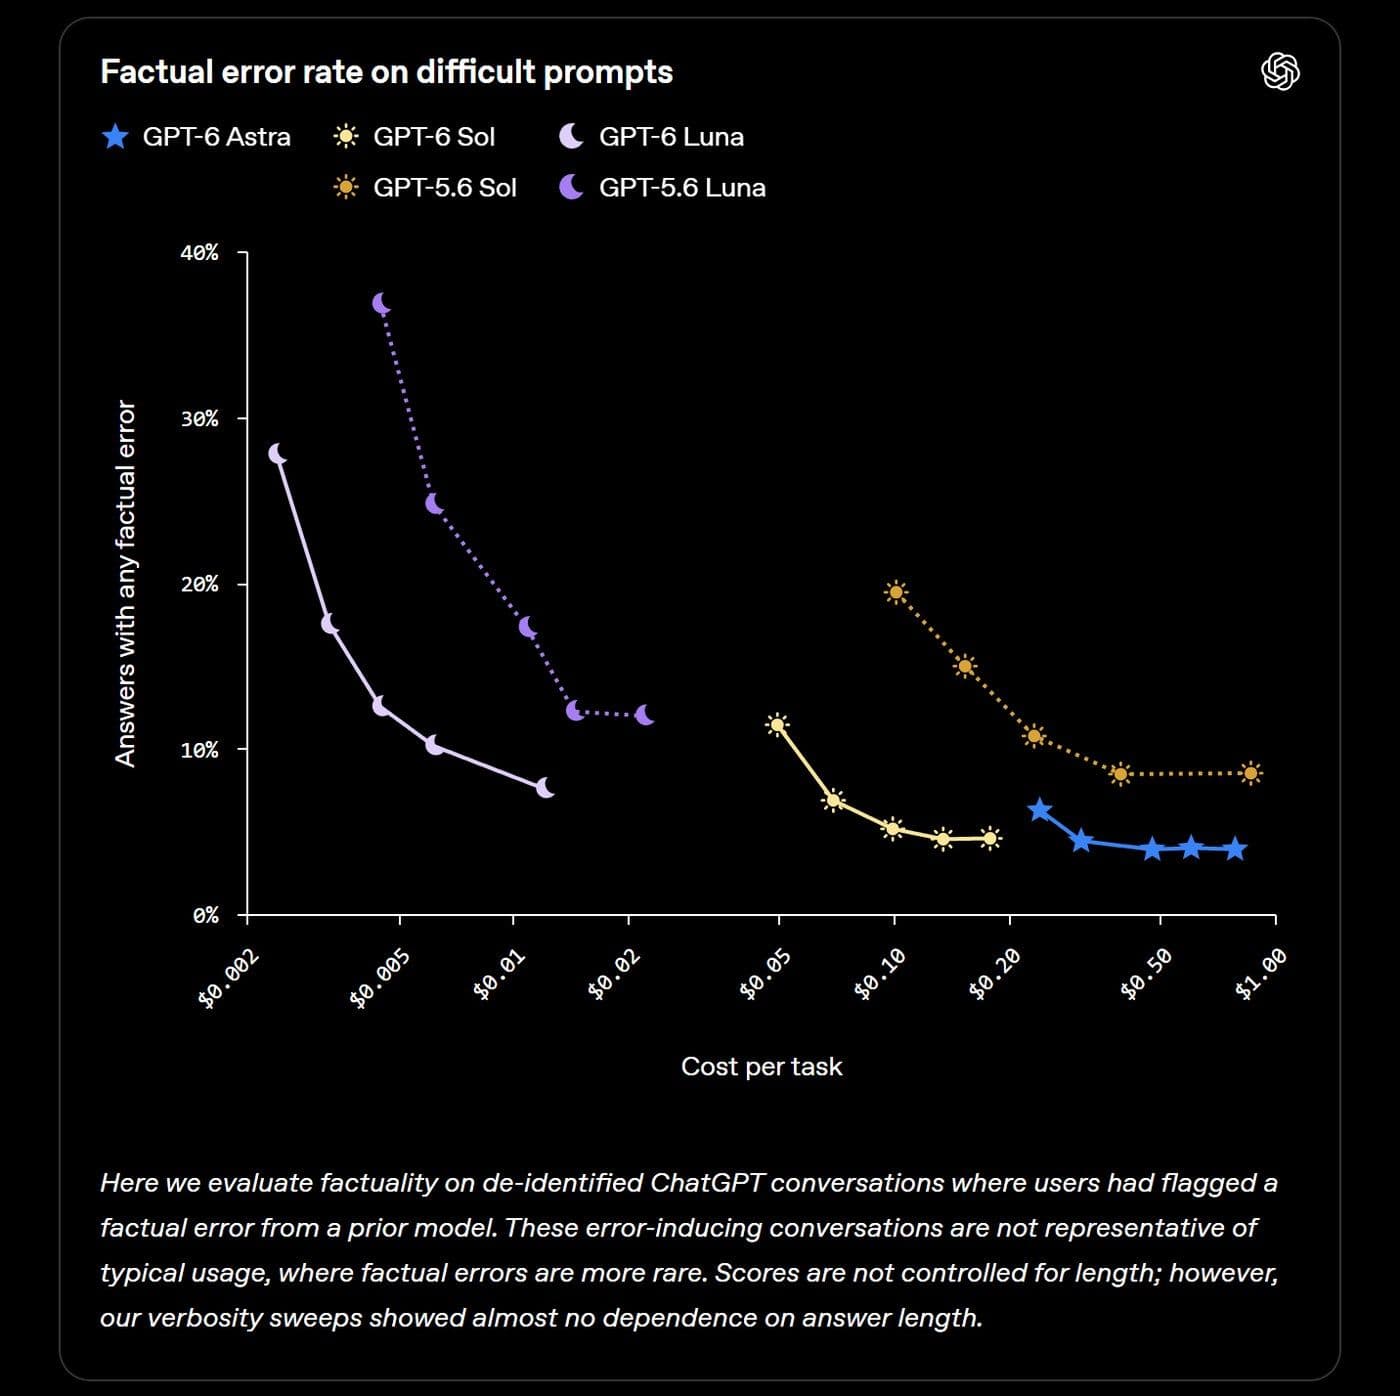
Ступень выбирайте по сложности задачи: чем больше шагов и проверок нужно, тем выше ступень, но самая высокая — не всегда лучшая. Чип «Модель · Ступень» открывает попап «Усилие» со шкалой «Быстрее ↔ Умнее». У GPT-6 Sol доступны все шесть ступеней, выбор запоминается в чате. Чем выше ступень, тем дольше модель думает и тем больше токенов тратит: по графикам OpenAI стоимость задачи у Sol растёт с каждым уровнем.
| Ступень в интерфейсе | Для каких задач | Что показывают данные OpenAI |
|---|---|---|
| Без раздумий (none) | Перевод абзаца, переформулировка, короткая справка | Этого уровня в графиках анонса нет |
| Быстрее (low) | Черновик письма, пересказ короткого текста, простые вопросы | Ответы с фактической ошибкой — 11,4%; AutomationBench — 21,2% |
| Обычно (medium) | Повседневная аналитика, письма клиентам, разбор документа, таблицы | Уровень по умолчанию у OpenAI; ошибки — 6,9%; AutomationBench — 26,9%, как у Claude Opus 5 на max |
| Глубже (high) | Сложная аналитика, проверка фактов, планирование | Ошибки — 5,1%; AutomationBench — 31,2%; DeepSWE — 65,3% |
| Ещё глубже (xhigh) | Многошаговые бизнес-процессы, агенты, разбор договоров, проверка кода | Лучший результат Sol в AutomationBench — 33,2%; меньше всего ошибок — 4,5% |
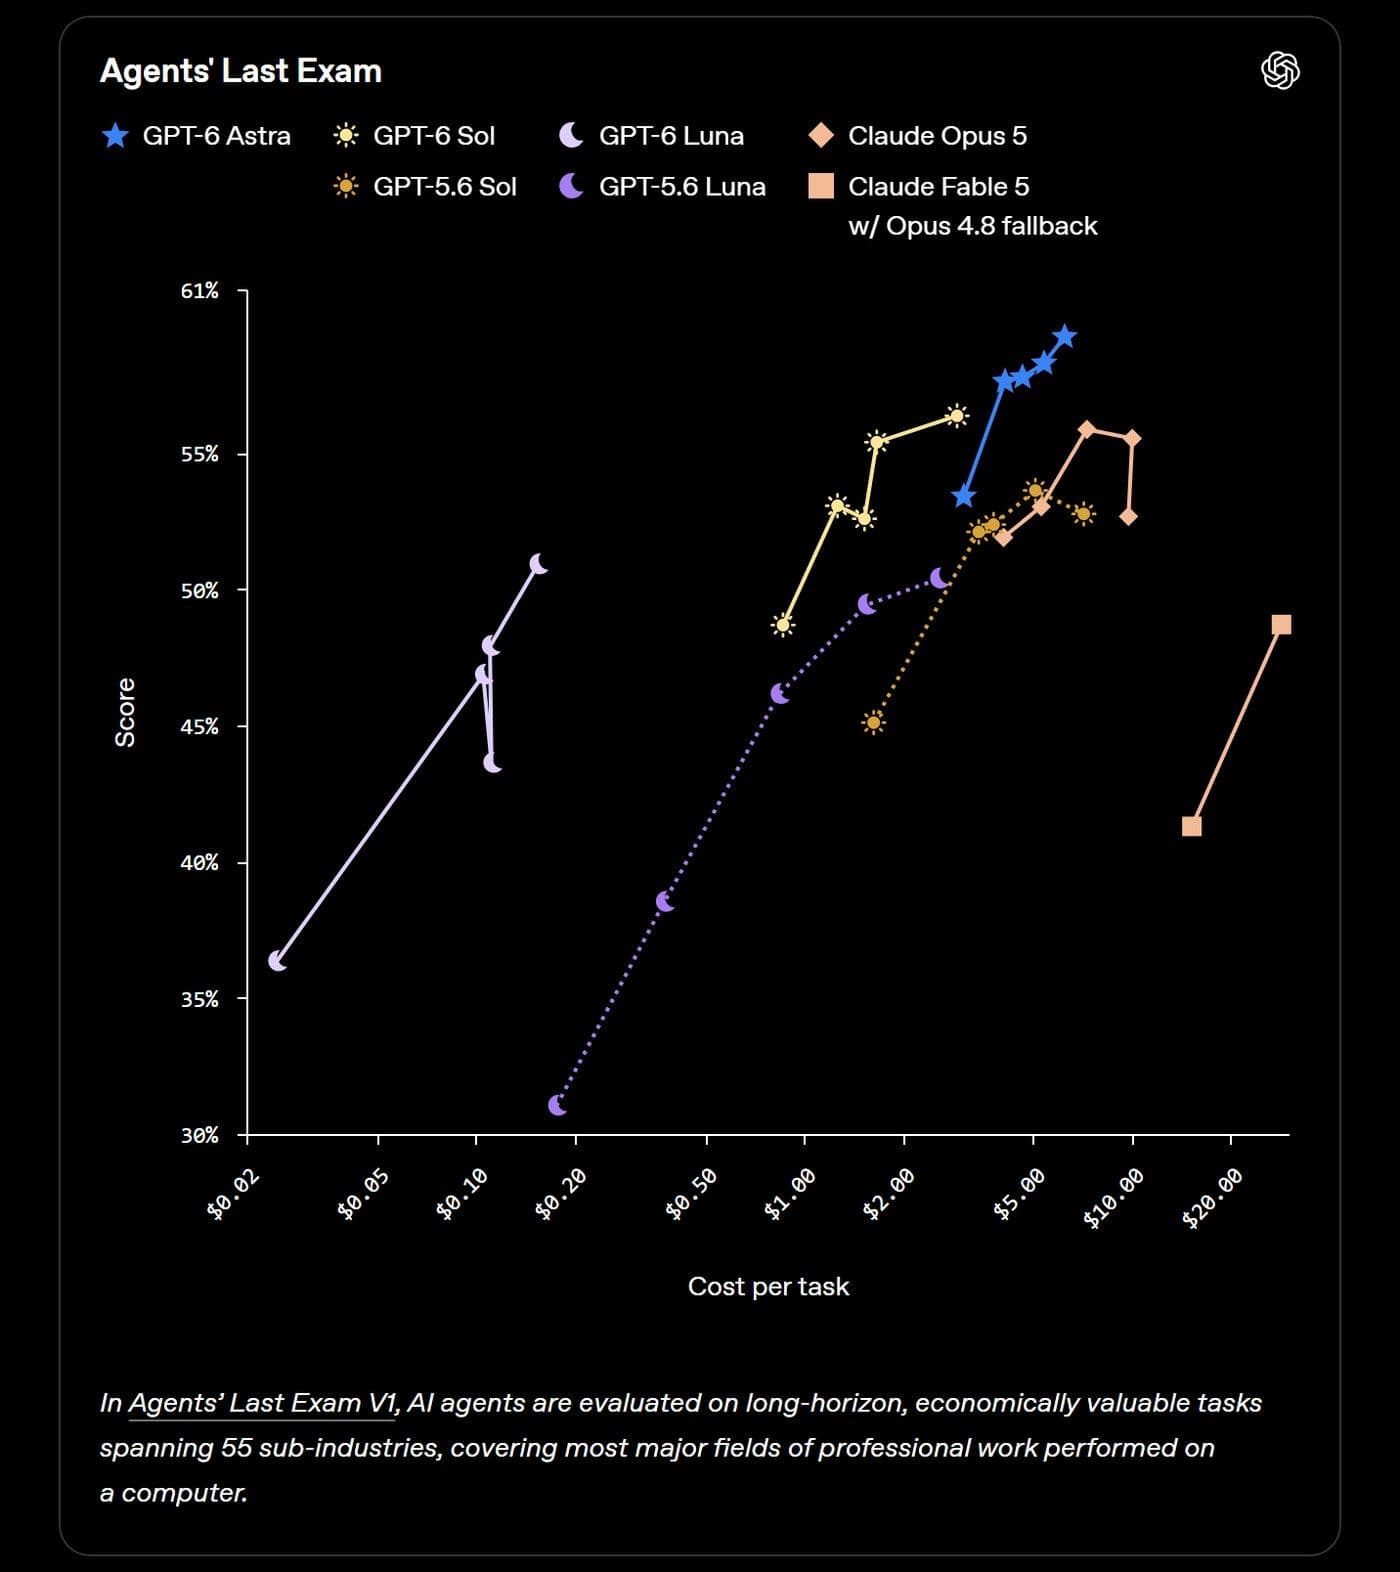
| Максимум (max) | Трудные задачи программирования, длинные исследования | Лучшее в Agents' Last Exam (56,4%), FrontierCode (49,3%), DeepSWE (68,8%); в AutomationBench — 32,0%, ниже, чем на xhigh |
Что означают цифры: «ошибки» — доля ответов хотя бы с одной фактической ошибкой на трудных запросах из внутреннего теста OpenAI; AutomationBench проверяет сквозные бизнес-процессы с инструментами; DeepSWE — длинные задачи разработки в реальных кодовых базах; FrontierCode — качество кода вплоть до готовности к слиянию.
Максимум — не всегда лучший выбор. По данным OpenAI, в AutomationBench Sol на max набирает 32,0%, чуть меньше, чем на xhigh (33,2%), а в Agents' Last Exam (длинные профессиональные задачи за компьютером) на high — 52,6%, меньше, чем на medium (53,1%). Практический совет: прогоните важную задачу на двух соседних ступенях и сравните ответы. Переключение занимает один клик, а смена уровня рассуждений, по данным OpenAI, не сбрасывает кэш — уже обработанное начало переписки, которое модели не нужно разбирать заново.
Как работать в GPT-6 Sol с файлами и длинными документами?
Файлы прикладываются прямо в чат: GPT-6 Sol понимает текст, изображения, PDF и таблицы, а её контекст — 1 050 000 токенов. Контекст — это всё, что модель учитывает за один запрос: переписка, инструкции и приложенные файлы; токен — фрагмент слова. Такого объёма хватает на несколько больших документов в одном разговоре, но пользоваться им стоит с умом.
- Сразу ставьте задачу. Приложили файл — в том же сообщении напишите, что с ним сделать и в каком виде нужен результат: таблица, список рисков, письмо.
- Большой документ — по частям. Сначала попросите карту разделов, затем разбирайте нужные разделы по очереди: так проще проверять ответы.
- Длинные запросы дороже. Когда запрос длиннее 272 000 токенов, OpenAI берёт за токен больше. Прикладывайте нужные файлы, а не весь архив.
- Новая тема — новый чат. Старые файлы и переписка не помогают новой задаче, но занимают место в контексте и расходуют токены.
- Картинки тоже читаются. Скриншоты, графики, фото документов можно приложить и попросить описать, сверить или перенести данные в таблицу. Отвечает Sol только текстом.
- Длинный ответ — частями. Ответ может быть до 128 000 токенов, но большой отчёт проще проверять, если просить его по разделам.
Как GPT-6 Sol пользуется поиском и выполнением кода?
GPT-6 Sol сама вызывает инструменты платформы — поиск в интернете, выполнение кода, базы знаний, — поэтому ей можно поручать задачи, где нужны свежие данные или точные расчёты. В нашей пробе 23 сентября Sol корректно вызвала функцию; проверка была короткой, по одному запросу на модель.
- Поиск в интернете — для свежих данных и проверки фактов. Просите прямо: «найди в интернете и дай ссылки на источники».
- Выполнение кода — для расчётов, обработки таблиц и проверки формул. Добавьте в запрос «посчитай с помощью кода, а не в уме», чтобы цифры были посчитаны, а не подобраны на глаз.
- Базы знаний — если к чату или агенту подключена база знаний, Sol ищет ответы в ваших документах.
- Ступень для работы с инструментами — «Глубже» или «Ещё глубже». По данным OpenAI, в AutomationBench, где модель работает с 47 инструментами, Sol на low решает 21,2% задач, а на xhigh — 33,2%.
Как настроить ИИ-агента на GPT-6 Sol?
Для ИИ-агента выберите в его настройках GPT Sol Latest, если агент должен получать свежие версии Sol без перенастройки, или GPT-6 Sol, если важнее стабильное поведение. Там же задаётся ступень рассуждений — она определяет, насколько тщательно агент работает над каждым ответом.
- Агент-аналитик или исследователь — «Ещё глубже»: много шагов, поиск, расчёты.
- Агент поддержки с базой знаний — «Обычно» или «Глубже». Если вопросов много и они простые, сравните с GPT-6 Luna, но не ниже ступени «Обычно»: на low у Luna в многошаговых тестах OpenAI результаты очень низкие.
- Агент для кода — «Ещё глубже» или «Максимум»: в DeepSWE, по данным OpenAI, Sol решает 66,6% задач на xhigh и 68,8% на max.
- Агент для длинных профессиональных задач — начните с «Обычно»: в Agents' Last Exam Sol на medium (53,1%) не уступает high (52,6%), прибавку дают только xhigh (55,4%) и max (56,4%).
Как сэкономить нейроны при работе с GPT-6 Sol?
Экономят три привычки: подходящая ступень, модель под задачу и контекст без лишнего. Нейроны списываются по фактическому расходу токенов, поэтому всё, что сокращает расход, сокращает и списание.
- Начинайте с «Обычно». Поднимайте ступень, только если ответа не хватило: выше ступень — больше токенов на рассуждения.
- Не ставьте «Максимум» по умолчанию. Он дольше и дороже, а выигрыш бывает не всегда.
- Простое — Luna. Короткие справки, переформулировки и черновики лучше отдавать GPT-6 Luna: она экономичнее и доступна даже на бесплатном тарифе.
- Pro — только для трудного. GPT-6 Sol Pro — та же модель с режимом рассуждений pro. В наших пробных запросах короткий вопрос в Pro обходился в 2–14 раз дороже, чем в обычной версии, — на простых задачах это переплата без пользы.
- Не переписывайте начало длинного диалога. По данным OpenAI, в GPT-6 неизменное начало запроса чаще попадает в кэш, а закэшированный вход в API OpenAI читается со скидкой 90%. Переписанная первая инструкция или заново вставленный документ этот выигрыш обнуляют.
Честно о цене: токен GPT-6 Sol в каталоге СуперИнтеллекта стоит столько же, сколько у GPT-5.6 Sol, — вдвое она подешевела только в API OpenAI. Графики стоимости задачи из анонса посчитаны по ценам API, поэтому их проценты на нейроны не переносятся: сколько нейронов уйдёт, зависит от числа токенов в вашем запросе и ответе.
Какие промпты использовать для GPT-6 Sol?
Ниже — семь готовых промптов (запросов к модели) под рабочие сценарии. В квадратных скобках — то, что нужно заменить своим, в заголовке — рекомендуемая ступень. Ещё двадцать промптов — в подборке для GPT-6 Sol и Luna.
Анализ выгрузки продаж — ступень «Глубже»
Ты — аналитик продаж. Во вложении — выгрузка продаж за [период] в формате [Excel или CSV].
1. Опиши структуру данных: какие есть столбцы, за какой период, сколько строк, есть ли пропуски и дубли.
2. Посчитай выручку, число заказов и средний чек по месяцам и по [каналам / регионам / менеджерам]. Считай с помощью кода, а не в уме.
3. Найди три самых заметных изменения и предложи для каждого две возможные причины. Отдели то, что видно из данных, от предположений.
4. Итог — таблица с цифрами и пять выводов для руководителя, каждый не длиннее двух предложений.
Если данных не хватает для какого-то вывода, напиши, каких именно.
Проверка кода перед слиянием — ступень «Ещё глубже»
Проведи код-ревью изменений ниже. Контекст: [язык, фреймворк, назначение модуля]. Стандарты команды: [например, строгая типизация, без глобального состояния, тесты на каждую ветку логики].
Проверь по порядку:
1. Ошибки логики и пограничные случаи — для каждой укажи место в коде и сценарий, в котором она проявится.
2. Безопасность: ввод пользователя, права доступа, утечки секретов.
3. Тесты: что не покрыто и какие тесты добавить.
4. Изменения, которые не относятся к задаче.
Не переписывай код целиком — предложи минимальные правки в виде диффа. Если в чём-то не уверен или не видишь нужного файла, так и скажи, не додумывай.
[вставьте дифф или код]
Письмо клиенту о сложной ситуации — ступень «Обычно»
Напиши письмо клиенту [компания, имя контакта].
Ситуация: [например, поставка задерживается на неделю из-за таможни].
Цель письма: [сохранить заказ и договориться о новой дате].
Что важно сказать: [факты, сроки, что мы предлагаем взамен].
Тон: деловой и тёплый, без канцелярита и лишних извинений. Длина — до 150 слов.
Дай два варианта: сдержанный и более личный. К каждому — тема письма.
План проекта с рисками — ступень «Глубже»
Составь план проекта: [цель, например, запустить онлайн-курс по бухгалтерии для малого бизнеса].
Исходные данные: срок — [3 месяца], команда — [кто есть и сколько времени у каждого], бюджет — [сумма или «ограничен»], ограничения — [что нельзя менять].
Нужно:
1. Этапы с результатом каждого и критерием «готово».
2. Задачи внутри этапов с ответственными ролями и оценкой в днях.
3. Критический путь и зависимости между задачами.
4. Пять главных рисков: вероятность, последствия, что делаем заранее.
Этапы и задачи оформи таблицей. Если исходных данных не хватает, сначала задай до пяти уточняющих вопросов.
Разбор договора — ступень «Ещё глубже»
Во вложении — договор [тип, например, поставки]. Я — [сторона: покупатель, исполнитель].
1. Кратко перескажи суть: предмет, сроки, цена и порядок оплаты, ответственность сторон.
2. Найди условия, невыгодные или рискованные для моей стороны: штрафы, односторонние права, автопродление, ограничение ответственности, порядок расторжения. Для каждого — номер пункта и точная цитата.
3. Предложи формулировки правок и объясни, зачем нужна каждая.
4. Отдельным списком — что в договоре не прописано, хотя обычно должно быть.
Не выдумывай пунктов, которых нет в тексте. Если формулировка допускает два толкования, приведи оба.Сводная таблица из разрозненных данных — ступень «Обычно»
Ниже — данные о [поставщиках / кандидатах / тарифах] из разных источников: письма, заметки, прайсы.
[вставьте текст]
Собери их в одну таблицу со столбцами: [Название, Цена, Сроки, Условия оплаты, Контакт, Комментарий].
Правила: не додумывай значения — если данных нет, пиши «нет данных»; противоречия между источниками отметь в комментарии.
Под таблицей — три строки: кто выгоднее по цене, кто по срокам и что нужно уточнить.
Проверка фактов с поиском в интернете — ступень «Глубже»
Проверь факты в тексте ниже с помощью поиска в интернете.
Для каждого утверждения с цифрой, датой, именем или названием укажи:
— верно, неверно или не удалось проверить;
— источник со ссылкой;
— исправленную формулировку, если нужно.
Не считай утверждение проверенным, если нашёл его только на одном сомнительном сайте. В конце — все исправления одним списком.
[вставьте текст]
Каких ошибок избегать при работе с GPT-6 Sol?
Главная ошибка — ставить «Максимум» на всё подряд: это дольше и дороже, а по данным OpenAI результат на максимальной ступени бывает даже ниже, чем на соседней.
- «Быстрее» для многошаговых задач. На low модель экономит на рассуждениях, и в сложных задачах это заметно: в AutomationBench Sol на low решает 21,2% задач против 33,2% на xhigh.
- Непроверенные цифры. Даже на ступени «Глубже» во внутреннем тесте OpenAI 5,1% ответов на трудные запросы содержат фактическую ошибку. Просите источники и проверяйте ключевые факты.
- Pro для простых вопросов. В наших пробах Pro-версия выдавала ответ целиком после паузы в 3–8 секунд, а не печатала его по словам: на коротком вопросе это лишнее ожидание и лишний расход.
- Размытая постановка. Sol отвечает яснее и короче прошлой версии, поэтому формат результата лучше задать явно: таблица, список, объём, для кого текст.