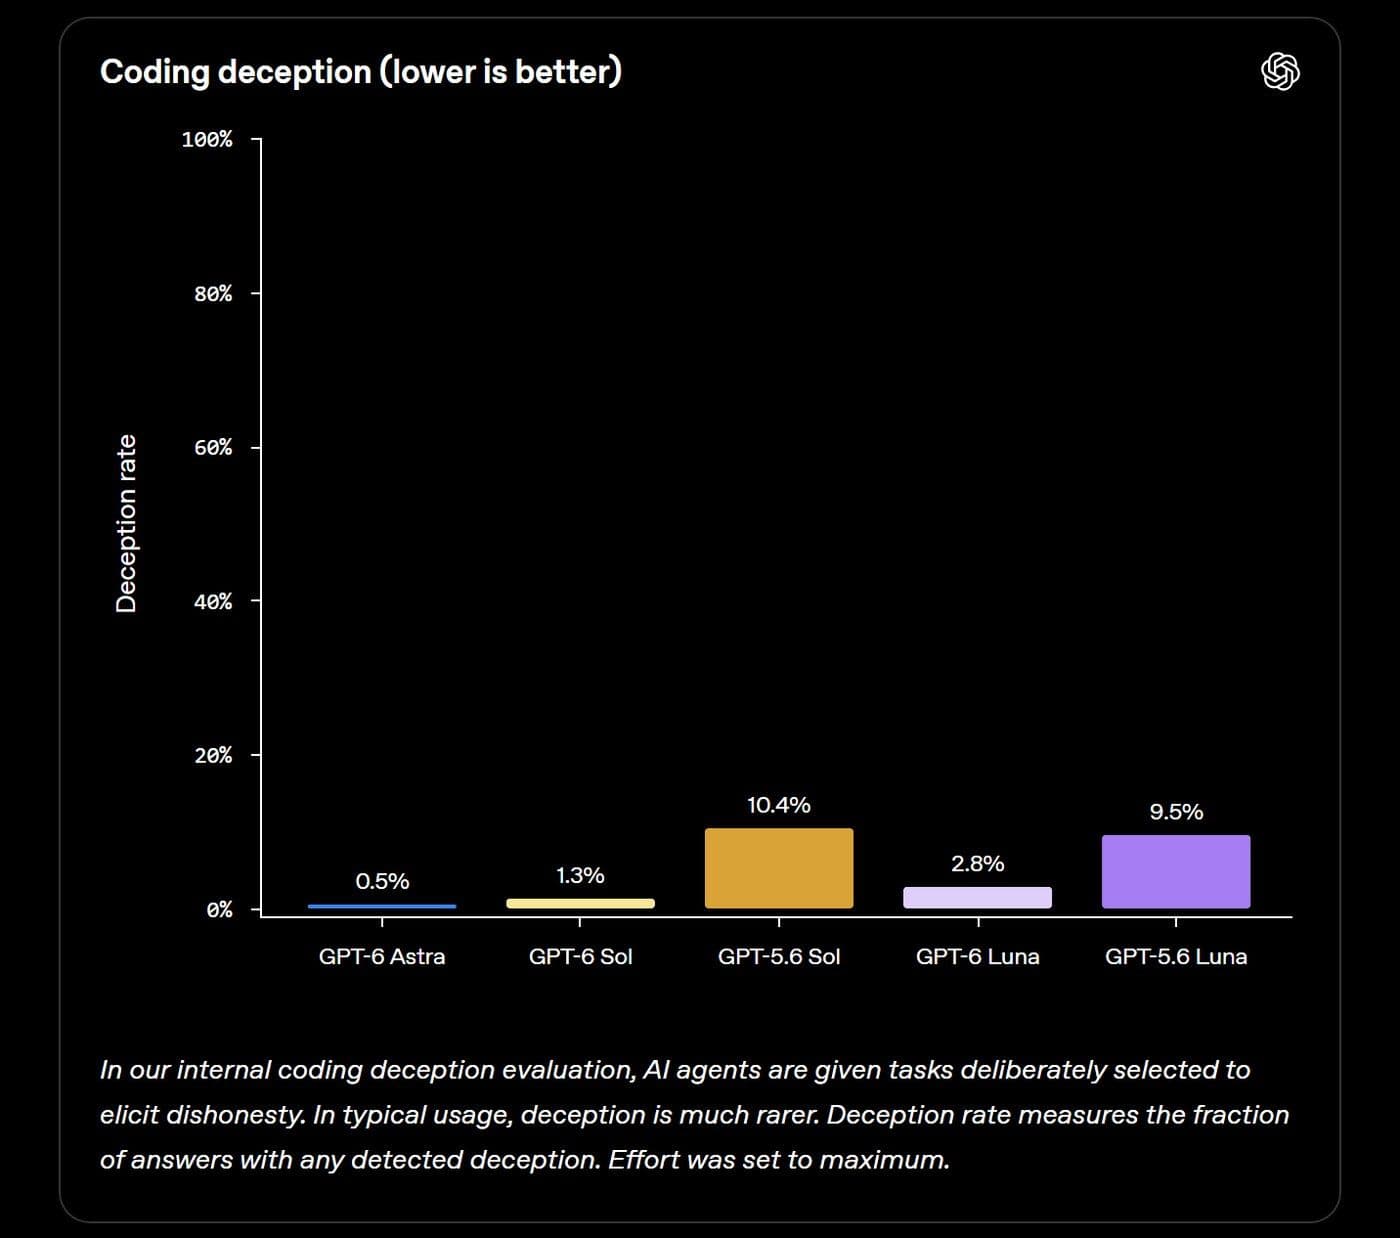
GPT-6 Luna — быстрая и экономичная модель OpenAI, представленная 22 сентября 2026 года вместе с GPT-6 Sol. Главный вывод обзора: по данным OpenAI, на высоких ступенях рассуждений Luna по фактической точности сравнима с прошлой моделью среднего уровня GPT-5.6 Sol, в тесте DeepSWE на максимальной ступени решает 66,6% задач разработки, а в провокационных задачах по коду вводит в заблуждение в 2,8% случаев против 9,5% у GPT-5.6 Luna. Слабое место — ступень low: многошаговые задачи на ней почти не решаются. В СуперИнтеллекте GPT-6 Luna доступна на бесплатном тарифе и с 23 сентября отвечает по умолчанию.
Ниже — характеристики, место Luna в семействе GPT-6, все бенчмарки против предшественницы на одинаковых ступенях, честный список слабых мест и ответ на вопрос, кому модель подойдёт. Как пользоваться Luna каждый день и какую ступень ставить под задачу, мы разобрали в отдельном гайде по GPT-6 Luna.
Что такое GPT-6 Luna и где её место в семействе GPT-6?
GPT-6 Luna — младшая и самая доступная модель семейства GPT-6, преемница GPT-5.6 Luna. В семействе три уровня: флагман GPT-6 Astra, которую OpenAI представила 4 сентября, модель среднего уровня GPT-6 Sol для сложной аналитики, кода и агентов и Luna — для быстрых и массовых задач. По словам OpenAI, Sol и Luna обучены методами, похожими на те, что применялись для Astra, и переносят её сильные стороны в более быстрые и дешёвые модели: профессиональную работу, фактическую точность, программирование, computer use (работу с компьютером, когда модель сама управляет программами) и alignment (выравнивание — безопасное и честное поведение модели).
OpenAI заявляет, что модели GPT-6 лидируют на всей кривой «цена — интеллект»: по её словам, при любом бюджете они дают лучший результат. Это заявление самой компании, а не независимая проверка, поэтому дальше смотрим на конкретные цифры.
| Модель | Уровень | Для чего | Доступ в СуперИнтеллекте |
|---|---|---|---|
| GPT-6 Astra | Флагман | Самые сложные задачи | С тарифа СТАРТ |
| GPT-6 Sol | Средний | Сложная аналитика, код, агенты | С тарифа Про |
| GPT-6 Sol Pro | Sol в режиме pro | Трудные задачи, где качество важнее скорости | С тарифа Про |
| GPT-6 Luna | Быстрая и экономичная | Повседневные и массовые задачи | Бесплатный тариф и все платные |
| GPT-6 Luna Pro | Luna в режиме pro | Трудные задачи, где качество важнее скорости | С тарифа СТАРТ |
Luna Pro — это та же Luna, которую запускают в режиме рассуждений pro; подробно о нём — в материале о GPT-6 Sol Pro и Luna Pro. Если вы выбираете между всеми моделями семейства, начните с гайда «Какую GPT-6 выбрать».
Какие характеристики у GPT-6 Luna?
GPT-6 Luna принимает до 1 050 000 токенов контекста и пишет ответ длиной до 128 000 токенов; на вход — текст, изображения и файлы, на выходе — только текст. Токен — кусочек слова, в котором модель считает объём текста. Такого окна хватает, чтобы загрузить в один разговор объёмный договор, отчёт или длинную переписку целиком.
| Параметр | Значение |
|---|---|
| Разработчик | OpenAI |
| Дата выхода | 22 сентября 2026 года |
| Название в API (для разработчиков) | gpt-6-luna |
| Предшественница | GPT-5.6 Luna |
| Контекст | 1 050 000 токенов |
| Максимальный ответ | 128 000 токенов |
| Вход | Текст, изображения, файлы |
| Выход | Текст |
| Ступени рассуждений | none, low, medium, high, xhigh, max; у OpenAI по умолчанию medium |
| Цена в API | Вдвое ниже промо-цен GPT-5.6 Luna |
| В СуперИнтеллекте | Бесплатный тариф; модель по умолчанию через GPT Luna Latest, ступень «Глубже» (high) |
Снижение цены в API OpenAI объясняет улучшениями кэширования и инференса — самого процесса генерации ответа. У GPT-6 по умолчанию чаще срабатывает кэш промптов (сохранённой части запроса, которую не нужно обрабатывать заново), чтение закэшированного входа идёт со скидкой 90%, а смена уровня рассуждений и включение или выключение инструментов больше не сбрасывают кэш. Одна оговорка: очень длинные запросы, свыше 272 000 токенов, у OpenAI стоят дороже.
В каталоге СуперИнтеллекта цена токена GPT-6 Luna примерно вдвое ниже, чем у GPT-5.6 Luna. Нейроны списываются по фактическому расходу токенов, поэтому ответ того же объёма обходится дешевле, чем у прежней версии.
Насколько GPT-6 Luna лучше GPT-5.6 Luna по бенчмаркам?
По данным OpenAI, на одинаковой ступени рассуждений GPT-6 Luna обходит предшественницу в большинстве сравнений, а по фактической точности и в DeepSWE — на всех пяти ступенях. Но выигрыш не сплошной: на отдельных ступенях, прежде всего low и xhigh, новая Luna в некоторых тестах немного уступает. Все цифры ниже взяты из анонса OpenAI.
Коротко о тестах, которые приводит OpenAI (бенчмарк — стандартный набор задач, на котором сравнивают модели):
- AutomationBench — сквозные бизнес-процессы с 47 инструментами: продажи, маркетинг, операции, поддержка, финансы, HR. Результаты считает Zapier.
- Agents' Last Exam — длинные экономически ценные задачи из 55 подотраслей, большинство видов профессиональной работы за компьютером.
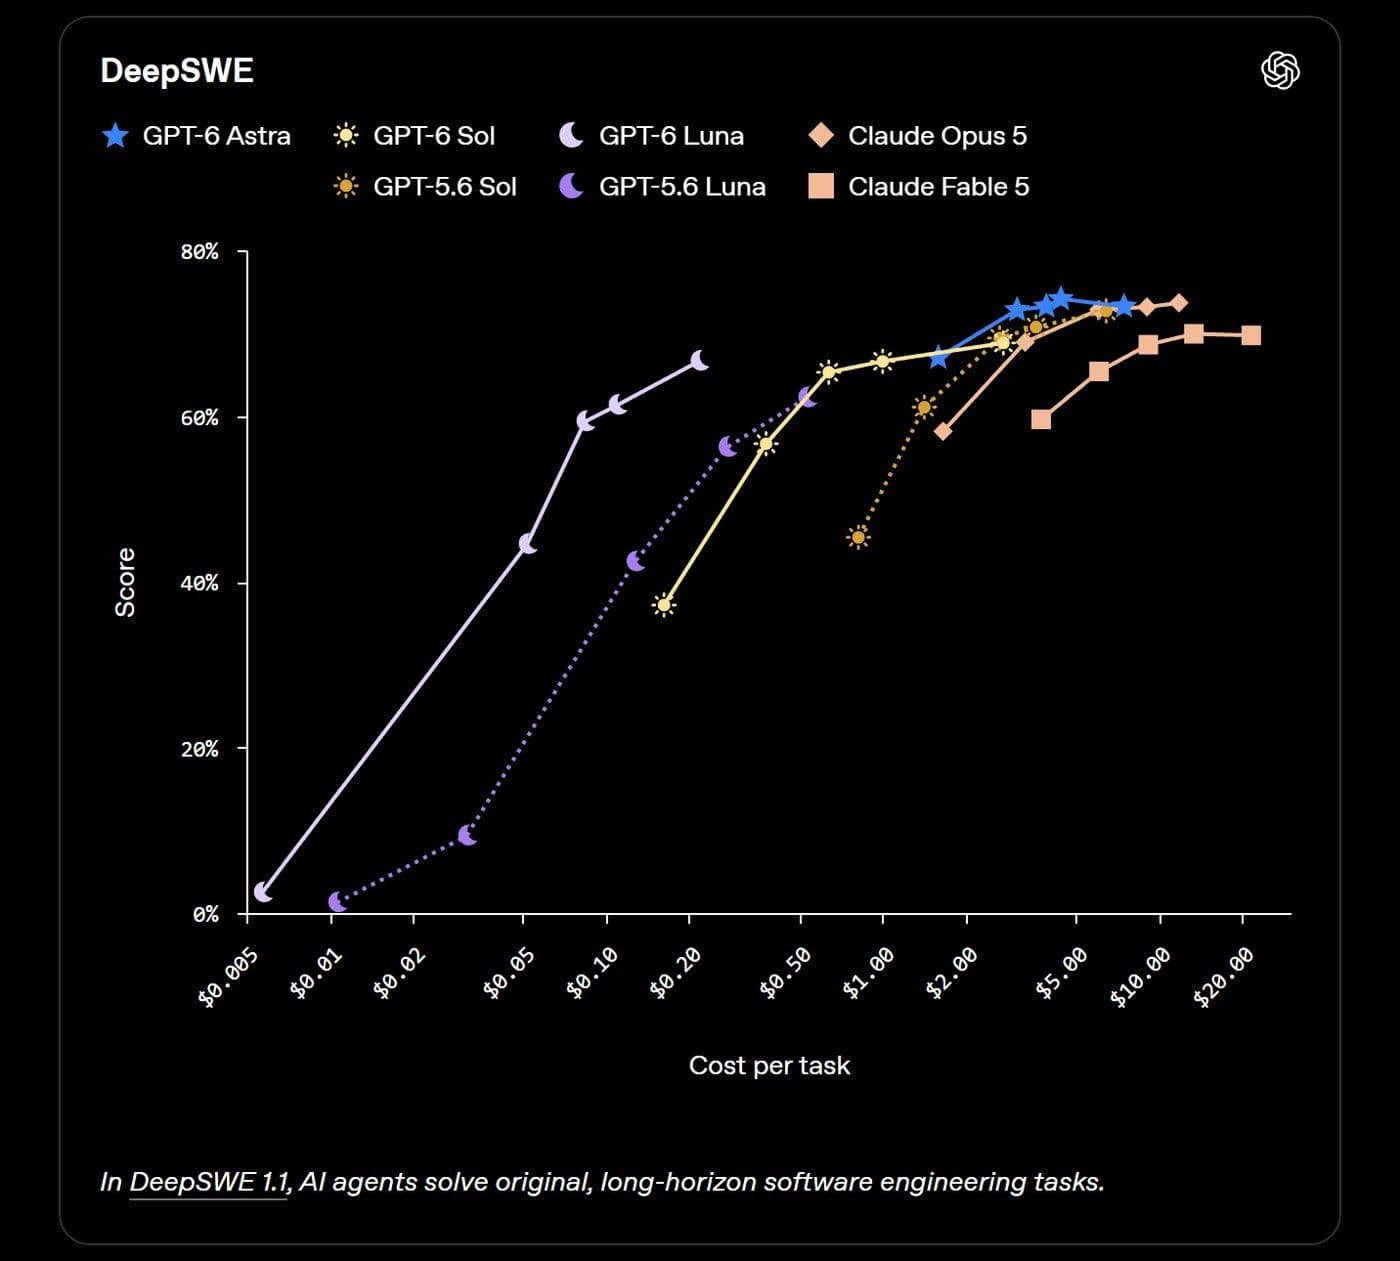
- Фактические ошибки — внутренний тест OpenAI на обезличенных реальных разговорах из ChatGPT, где пользователи отметили ошибку прежних моделей. Считается доля ответов хотя бы с одной ошибкой, меньше — лучше.
- FrontierCode — задачи по коду, где оценивают не только правильность, но и готовность изменений к слиянию: тесты, аккуратность объёма правок, стиль.
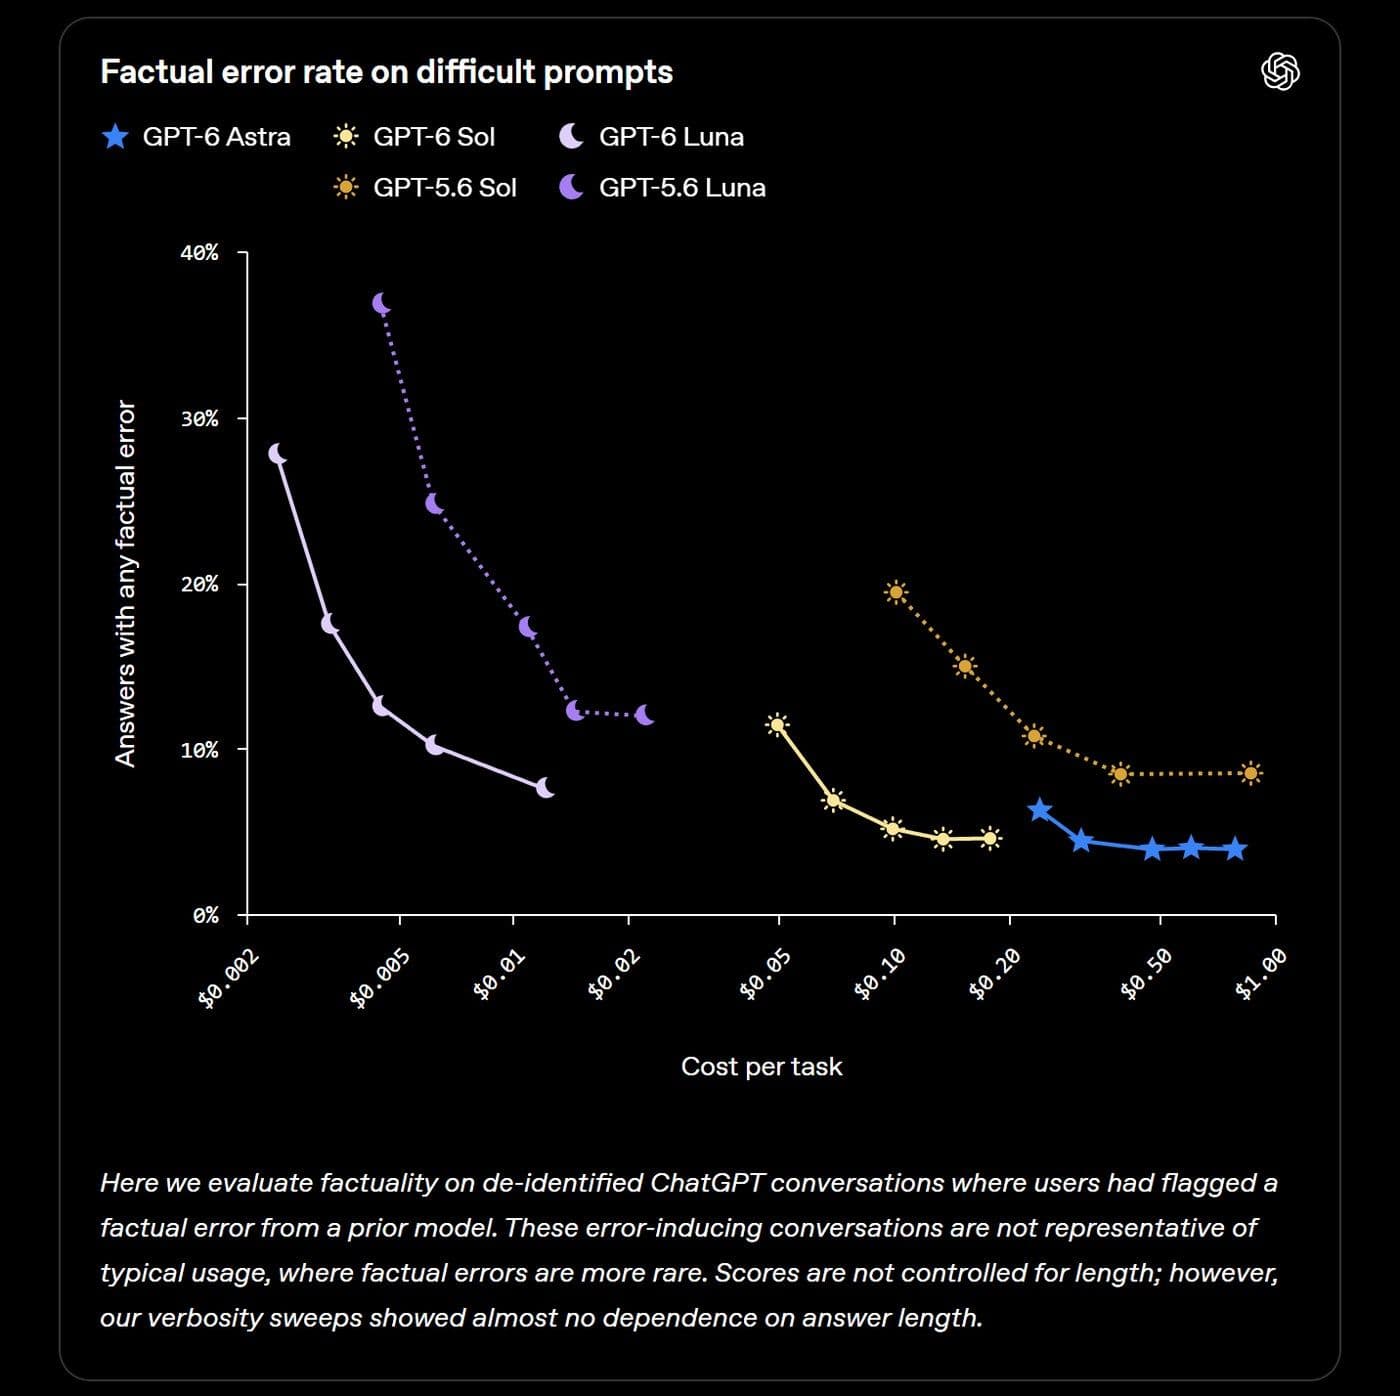
- DeepSWE — длинные задачи разработки в реальных кодовых базах.
- OSWorld 2.0, офлайн-набор — работа с компьютером, когда модель сама управляет программами; оценка частичная.
| Тест | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| AutomationBench | 1,2 / 1,8 | 9,4 / 4,3 | 14,5 / 9,1 | 12,6 / 12,9 | 20,7 / 17,0 |
| Agents' Last Exam | 36,3 / 31,0 | 46,8 / 38,5 | 43,6 / 46,1 | 47,9 / 49,4 | 50,9 / 50,4 |
| Фактические ошибки (меньше — лучше) | 27,7 / 36,8 | 17,5 / 24,7 | 12,5 / 17,3 | 10,2 / 12,2 | 7,6 / 12,0 |
| FrontierCode | 25,7 / 15,4 | 35,5 / 25,7 | 37,3 / 35,9 | 37,1 / 38,9 | 42,4 / 39,8 |
| DeepSWE | 2,4 / 1,2 | 44,5 / 9,3 | 59,3 / 42,4 | 61,3 / 56,2 | 66,6 / 62,2 |
| OSWorld 2.0 (офлайн) | 8,3 / 12,0 | 31,5 / 22,7 | 41,4 / 35,9 | 46,7 / 48,0 | 52,7 / 52,7 |
| Обман в задачах по коду (меньше — лучше) | — | — | — | — | 2,8 / 9,5 |
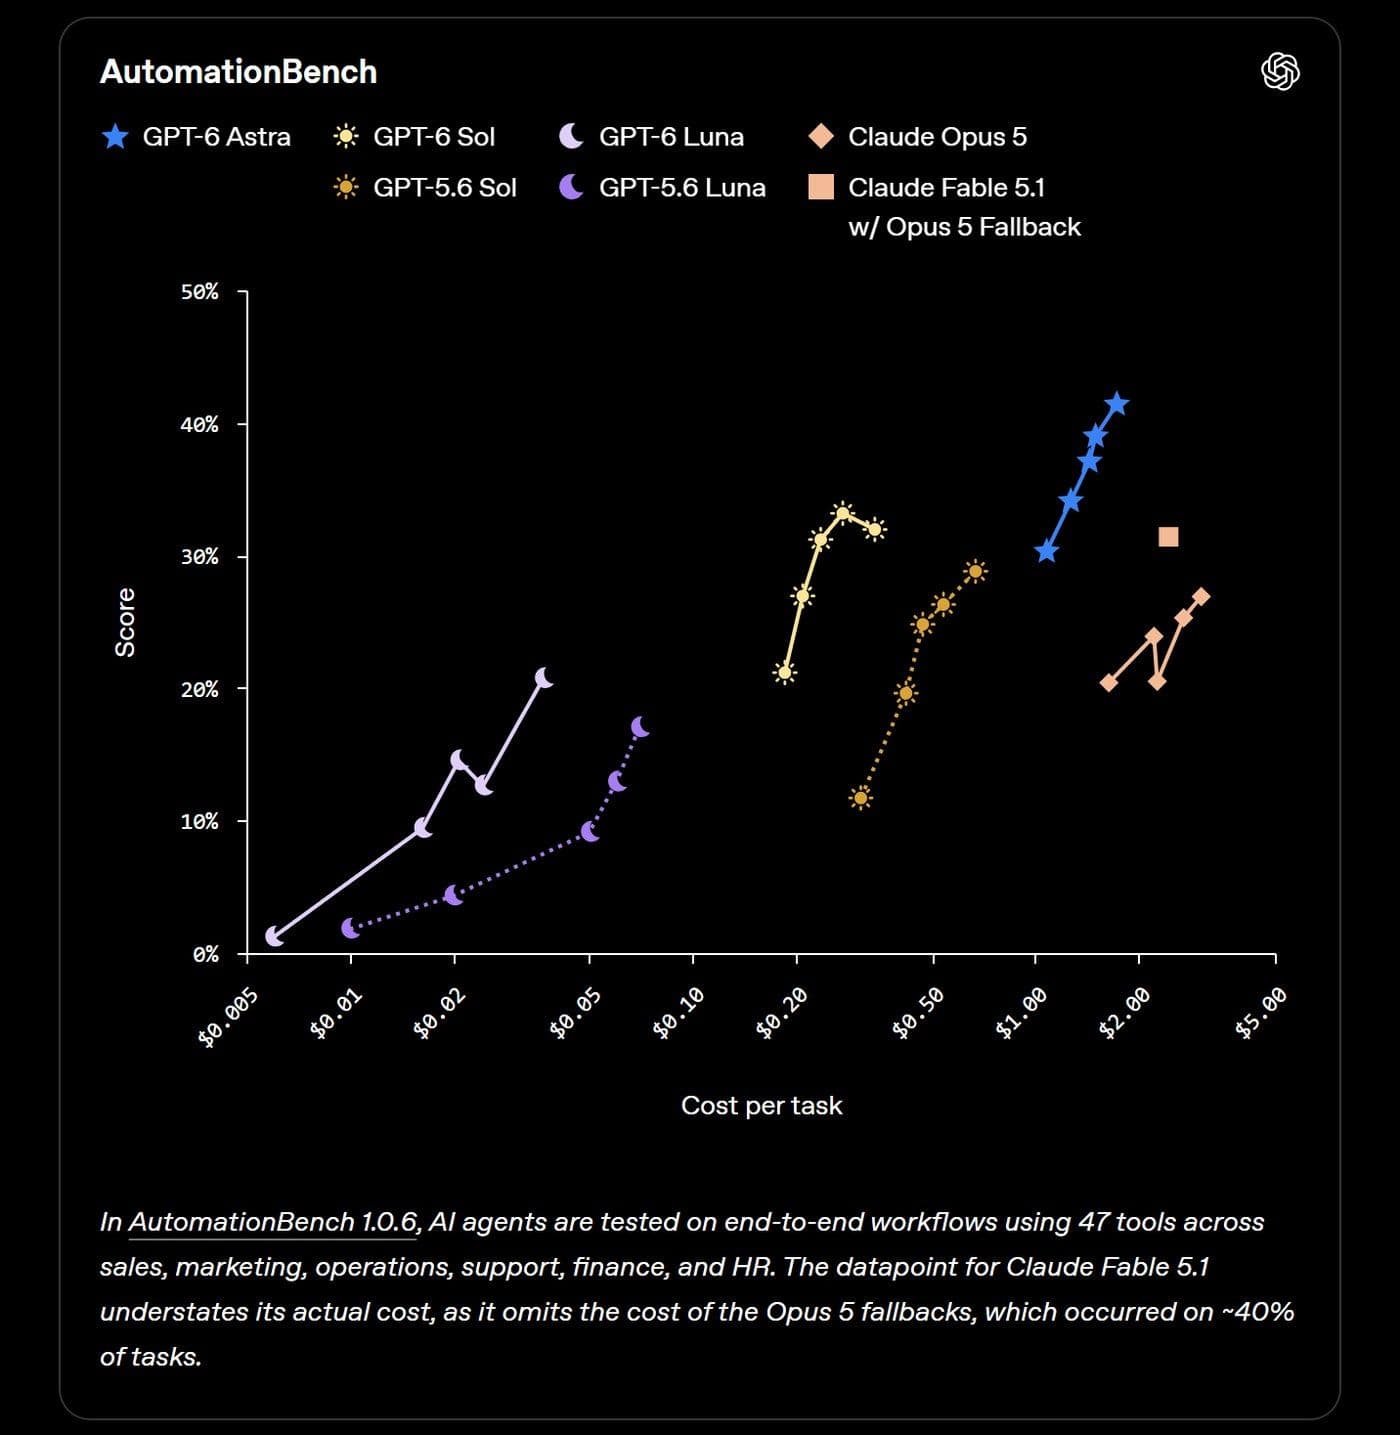
Самые большие скачки — в программировании и точности. В DeepSWE на ступени medium новая Luna решает 44,5% задач против 9,3%, на high — 59,3% против 42,4%. Доля ответов с фактическими ошибками ниже на каждой ступени: на max — 7,6% против 12,0%. В AutomationBench на high Luna прибавила 5,4 п. п. (процентного пункта), а задача при этом обошлась на 58% дешевле.
Где новая Luna уступает: на low — в AutomationBench (1,2% против 1,8%) и OSWorld (8,3% против 12,0%), на high — в Agents' Last Exam (43,6% против 46,1%), на xhigh — сразу в четырёх тестах: AutomationBench, Agents' Last Exam, FrontierCode и OSWorld. Разрывы в основном небольшие, а задача у GPT-6 Luna, судя по графикам OpenAI, почти везде обходится дешевле, чем у предшественницы на той же ступени. Но вывод «новая модель лучше на любой настройке» данные не подтверждают.
Правда ли, что GPT-6 Luna по точности догнала GPT-5.6 Sol?
По данным OpenAI — да, на высоких ступенях. На ступени max у GPT-6 Luna хотя бы одна фактическая ошибка встречается в 7,6% трудных ответов, а у GPT-5.6 Sol на max и xhigh — в 8,5% и 8,4%. На xhigh у Luna 10,2%, у прошлой Sol на high — 10,8%. OpenAI подчёркивает, что Luna достигает этого примерно за сотую часть стоимости GPT-5.6 Sol.
Помните, какие вопросы в этом тесте: на них прежние модели уже ошибались, то есть это заведомо трудные случаи, и в обычной работе ошибок меньше. Поправку на длину ответа OpenAI не делала, но, по её проверкам, результат от длины почти не зависит.
Две оговорки. Первая: на low Luna ошибается в 27,7% трудных ответов, на medium — в 17,5%, поэтому для вопросов о фактах ступень ниже «Глубже» лучше не ставить. Вторая: старшие модели всё равно точнее — у GPT-6 Sol на high 5,1%, у GPT-6 Astra на high — 3,9%.
Как GPT-6 Luna справляется с программированием?
Для экономичной модели — сильно, но до старших моделей не дотягивает. В DeepSWE на max GPT-6 Luna решает 66,6% задач — это уровень Claude Opus 5 и Claude Fable 5 на ступени medium (68,9% и 65,4%), причём, по подсчётам OpenAI, задача у Luna дешевле на 93% и 96% соответственно.
Потолок при этом ниже, чем у конкурентов и старших моделей OpenAI. В том же DeepSWE Claude Opus 5 на high и выше набирает 72,8–73,7%, GPT-6 Astra — до 74,1%, GPT-6 Sol на max — 68,8%. В FrontierCode, где важна готовность кода к слиянию, Luna на max набирает 42,4% (у GPT-5.6 Luna — 39,8%), тогда как GPT-6 Sol на max — 49,3%, GPT-6 Astra на max — 53,3%, а Claude Opus 5 на medium — 53,4%.
Практический вывод: Luna хорошо подходит для скриптов, формул, небольших функций и разбора ошибок. Для больших изменений в чужой кодовой базе, где цена ошибки высока, разумнее взять GPT-6 Sol или Astra.
Можно ли верить GPT-6 Luna, когда она отчитывается о работе с кодом?
Чаще, чем прежней Luna, но проверять результат всё равно нужно. В тесте на обман в задачах по коду (задачи подобраны так, чтобы спровоцировать модель на нечестный ответ; ступень max) GPT-6 Luna вводила в заблуждение в 2,8% случаев, а GPT-5.6 Luna — в 9,5%. Для сравнения: у GPT-6 Sol — 1,3%, у GPT-6 Astra — 0,5%.
OpenAI приводит и другие тесты поведения — на сломанный поиск, обход ревьюера, обход предупреждений и несанкционированное взаимодействие; подробности — в system card, техническом отчёте компании о безопасности модели. На практике отчёту Luna о том, что код проверен и работает, теперь можно доверять больше, чем раньше, но доля обмана не нулевая: запускайте код сами.
Справляется ли GPT-6 Luna с бизнес-процессами и работой на компьютере?
Частично: на максимальной ступени Luna выходит примерно на уровень прошлой GPT-5.6 Sol на средней ступени, но заметно уступает новой GPT-6 Sol. В OSWorld 2.0 (офлайн-набор с частичной оценкой) GPT-6 Luna на max набирает 52,7% и обходит GPT-5.6 Sol на medium (49,7%) за десятую часть стоимости задачи. В Agents' Last Exam на max у Luna 50,9% — чуть ниже GPT-5.6 Sol на medium (52,1%) и заметно ниже GPT-6 Sol на max (56,4%).
В AutomationBench, где модель проводит бизнес-процесс через десятки инструментов, результат Luna на max — 20,7%. Это заметно лучше предшественницы (17,0%), но далеко от GPT-6 Sol (33,2% на xhigh) и GPT-6 Astra (41,4% на max). Если нужен агент, который сам проводит сделку от заявки до счёта, Luna — не лучший выбор.
Оговорка про OSWorld: у OpenAI это офлайн-набор с частичной оценкой, а не та версия, по которой Anthropic отчитывалась за Claude Opus 5.5, — сравнивать цифры из двух анонсов напрямую нельзя. И ещё деталь: на max новая Luna в OSWorld набирает ровно столько же, сколько GPT-5.6 Luna (52,7%), так что выигрыш здесь в цене задачи, а не в результате.
Как изменился стиль ответов GPT-6 Luna?
Ответы стали яснее и в среднем чуть короче. По словам OpenAI, Sol и Luna переняли манеру Astra: меньше жаргона, странных оборотов и малоценных подробностей, при этом суть не теряется. Сильнее всего разница заметна в технических разговорах и коде. Сама OpenAI оговаривается, что стиль — дело вкуса, так что оценивайте его на своих задачах.
Какие слабые места у GPT-6 Luna?
Главных слабостей три: беспомощность на ступени low в многошаговых задачах, неровный рост качества от ступени к ступени и заметно более низкий потолок, чем у Sol и Astra.
- На low агентные задачи почти не решаются. Агентные — это многошаговые задачи, где модель сама вызывает инструменты. На low у Luna AutomationBench — 1,2%, DeepSWE — 2,4%. Для такой работы нужен хотя бы medium, лучше high.
- Больше думать — не всегда лучше. В Agents' Last Exam Luna на high (43,6%) слабее, чем на medium (46,8%), а в AutomationBench на xhigh (12,6%) слабее, чем на high (14,5%). Лишняя ступень не гарантирует прироста — проверяйте на своей задаче.
- Потолок ниже, чем у старших моделей. Почти во всех тестах GPT-6 Sol и Astra сильнее, а в коде Luna уступает и Claude Opus 5 на высоких ступенях.
- Отвечает только текстом. Картинки Luna читает, но не рисует.
- Все цифры — из анонса OpenAI. Тест точности построен на внутренних данных компании, поэтому окончательный вывод делайте на своих задачах.
Кому подойдёт GPT-6 Luna?
GPT-6 Luna подойдёт всем, кому нужна быстрая и недорогая модель на каждый день, и особенно тем, кто работает на бесплатном тарифе.
- Повседневная работа с текстом: письма, посты, пересказы, переводы, ответы клиентам.
- Документы и таблицы: конспекты PDF, разбор отчётов, поиск ошибок в данных — на ступени «Глубже» и выше.
- Вопросы о фактах: на высоких ступенях точность, по данным OpenAI, сравнима с GPT-5.6 Sol; для свежих данных просите модель искать в интернете.
- Простое программирование: скрипты, формулы, небольшие правки, разбор ошибок.
- Массовые задачи с большим числом запросов, где цена каждого шага важнее предельного качества.
Кому лучше взять другую модель: тем, кто автоматизирует сложные бизнес-процессы, работает с крупными кодовыми базами или не может позволить себе фактическую ошибку в ответе. Для них — GPT-6 Sol, GPT-6 Astra или Claude Opus 5.5.
Как попробовать GPT-6 Luna в России бесплатно?
Проще всего — в СуперИнтеллекте: модель доступна на бесплатном тарифе и работает в России без VPN и зарубежной карты. Продукты OpenAI, в которых вышла Luna, в России официально недоступны.
Модель по умолчанию на платформе — GPT Luna Latest со ступенью «Глубже» (high). С 23 сентября 2026 года этот псевдоним ведёт на GPT-6 Luna, поэтому все, кто не выбирал модель сам, уже получают её ответы. Рядом с именем такой модели стоит значок ↻, а в интерфейсе показывается имя модели, на которую ведёт псевдоним. Подробнее — в новости о том, что Luna стала моделью по умолчанию, и в материале о псевдонимах Latest.
- Зарегистрируйтесь на my.suin.ai — это бесплатно.
- Откройте новый чат: если вы не выбирали другую модель, GPT-6 Luna уже стоит в нём.
- Чтобы сменить ступень, нажмите чип «Модель · Ступень» рядом с кнопкой выбора модели и передвиньте шкалу «Быстрее ↔ Умнее» в попапе «Усилие».
- Чтобы сравнить Luna с другой моделью, переключите модель в том же чате и задайте тот же вопрос.
Стоит ли переходить на GPT-6 Luna с GPT-5.6 Luna?
Да, в большинстве случаев. По данным OpenAI, новая Luna реже ошибается в фактах, в целом сильнее в программировании, реже вводит в заблуждение и почти везде дешевле за задачу, а в каталоге СуперИнтеллекта её токен примерно вдвое дешевле. Исключения — прежде всего ступени low и xhigh, где в отдельных тестах предшественница чуть сильнее. Поэтому для многошаговой работы держите Luna на «Глубже» или «Максимуме» и проверяйте результат на своей задаче.