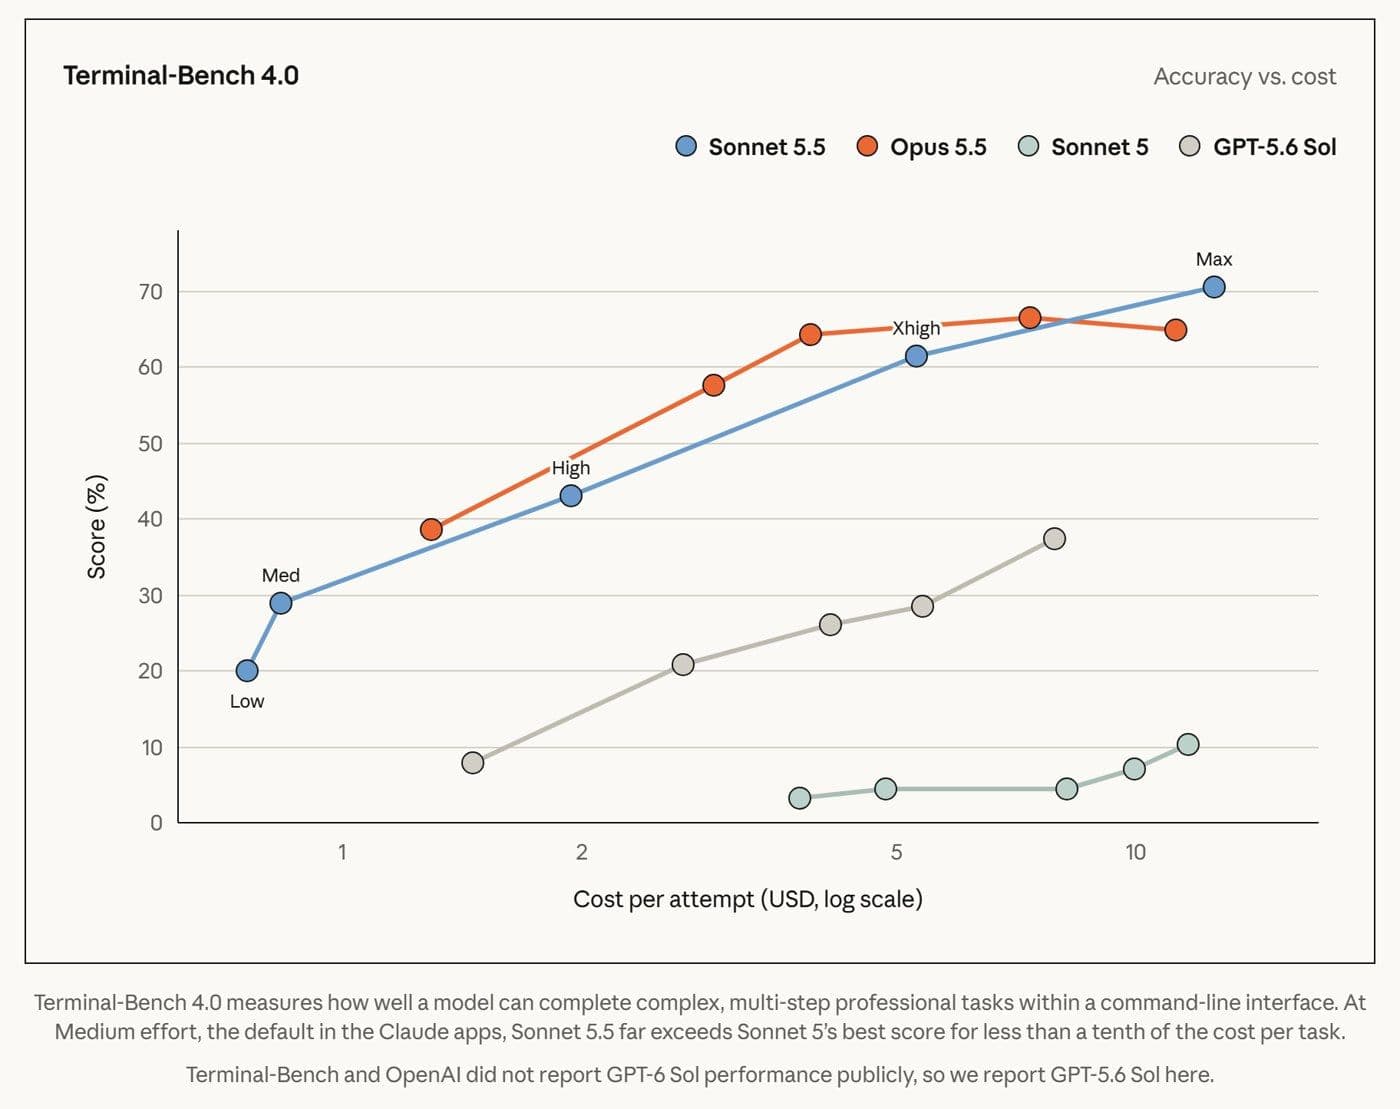
Claude Sonnet 5.5 для программирования — быстрая и экономная модель Anthropic, вышедшая 28 сентября 2026 года: в Terminal-Bench 4.0, тесте на многошаговые задачи в командной строке, она набирает 70,6% — выше лучшего результата Opus 5.5, — а сильнее всего проявляет себя в исправлении ошибок и чётко поставленных повседневных задачах. В СуперИнтеллекте модель доступна с 29 сентября 2026 года на тарифе СТАРТ и старше, в России без VPN. По данным Anthropic, она выдаёт ответ на 30% с лишним быстрее Sonnet 5, а задача обходится до 30% дешевле.
В гайде — тесты на код, выбор ступени, связка с Opus 5.5 и семь промптов для разработчика. Общий разбор модели — в обзоре Claude Sonnet 5.5.
Насколько хорошо Claude Sonnet 5.5 пишет код?
По данным Anthropic, Claude Sonnet 5.5 пишет код почти на уровне Opus 5.5: в одном тесте на программирование она старшую модель обходит, в двух отстаёт на 2,3 пункта. От предшественницы Sonnet 5 отрыв большой, и именно в коде, как пишет Anthropic, скачок особенно заметен.
| Тест | Что проверяет | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Многошаговые задачи в командной строке | 70,6% | 10,3% | 66,4% (Xhigh) | — |
| FrontierCode 1.1 Main | Можно ли влить изменение в проект без правок человека | 52,1% (Xhigh), 46,2% (Max) | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 | Задачи из реальных сессий в редакторе Cursor | 55,5% | 34,1% | 57,8% | — |
Все три теста — на агентное программирование: модель не просто пишет фрагмент по запросу, а сама читает файлы, запускает команды и проверяет, что получилось. В Terminal-Bench 4.0 результат вырос с 10,3% у Sonnet 5 до 70,6% и оказался выше лучшего результата Opus 5.5 — 66,4% на ступени Xhigh. В CursorBench 4.0 у модели 55,5%: в SpaceXAI назвали это вторым местом после Opus 5.5. Для GPT-6 Sol из трёх тестов Anthropic приводит только FrontierCode: там Sonnet 5.5 на Xhigh впереди (52,1% против 49,3%), а на Max — позади (46,2%).
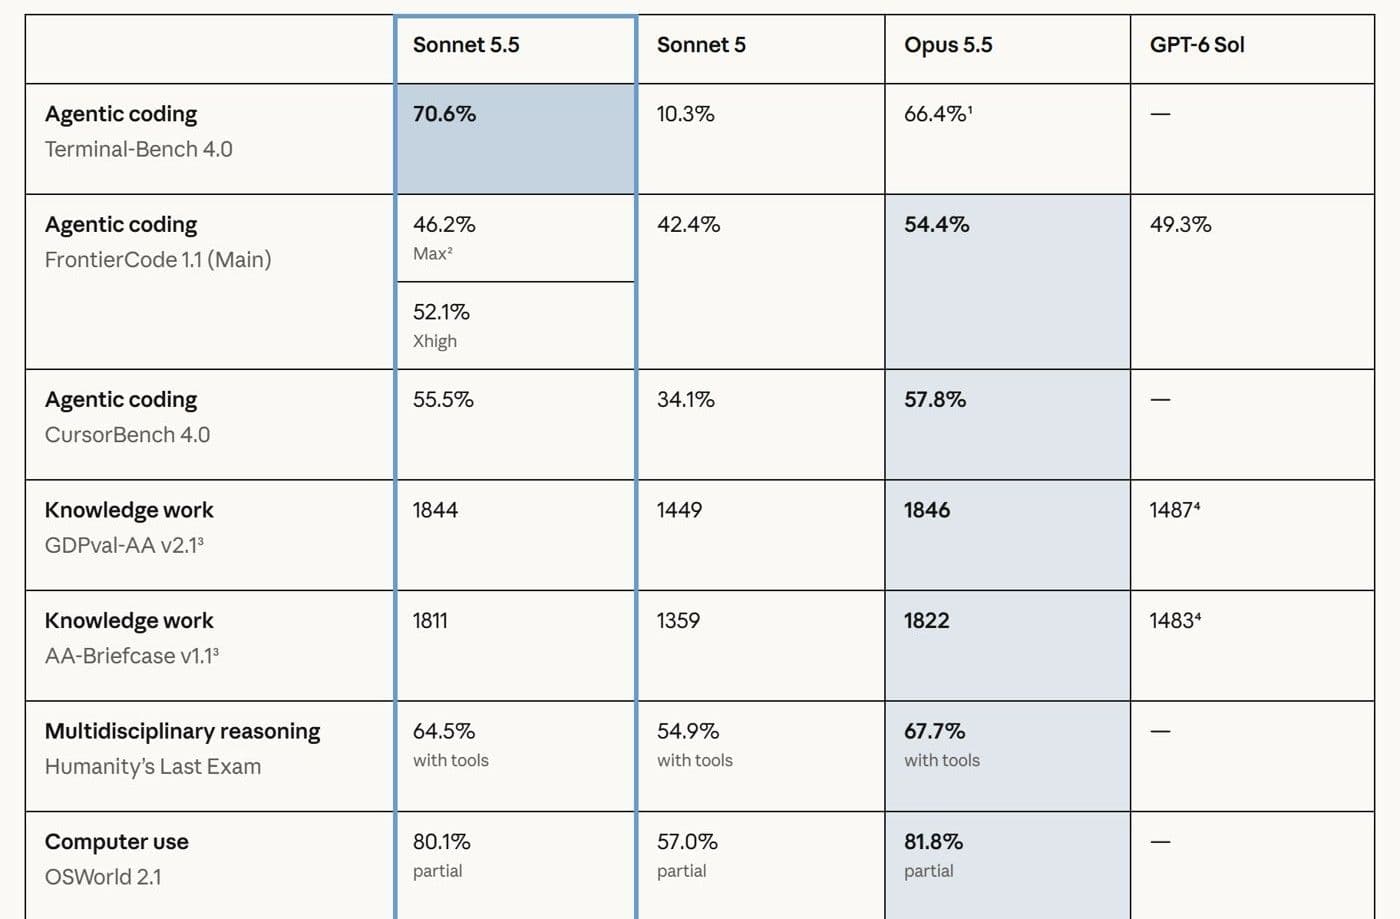
Это данные самого разработчика, и Anthropic сама оговаривается: тесты показывают лишь одну грань модели. На нескольких тестах Sonnet 5.5 на ступени Max сравнима с Opus 5.5, но в сложной открытой работе, где нужно долго держать суждение, Opus 5.5 остаётся заметно сильнее.
Почему на «Максимуме» Claude Sonnet 5.5 набирает во FrontierCode меньше, чем на «Ещё глубже»?
Потому что на максимальной ступени модель чаще затевала лишнюю работу — развёрнутое ревью кода, — а FrontierCode штрафует за всё, что выходит за рамки задачи: на Max у неё 46,2%, на Xhigh — 52,1%. Тест проверяет, можно ли влить изменение в проект без правок человека, и снимает баллы за правки вне задачи, даже полезные и качественные.
Как поясняет Anthropic в сноске, на Max модель чаще запускала ревью кода, разделённое между множеством субагентов — вспомогательных копий модели, которым раздаются части работы. В двух случаях, которые разобрала компания Cognition, это закончилось превышением лимита времени или лишними правками за рамками задачи.
Сколько шагов тратит Claude Sonnet 5.5 на задачу с кодом?
Меньше, чем Sonnet 5: новая модель чаще объединяет вызовы инструментов в пакеты, поэтому доходит до результата за меньшее число шагов и дешевле. Ранние тестировщики отметили и то, как быстро она разбирается в кодовой базе. Что рассказали компании, получившие модель до выхода:
- Lovable — в их тестах на код на треть меньше вызовов инструментов и примерно вдвое меньше запусков командной оболочки на задачу.
- Base44 — 118 реальных сборок приложений: качество на уровне Opus 5, в среднем 3,6 итерации на сборку против 7,7 у Opus 5 и меньше всего сбоев при вызове инструментов среди сравнённых моделей. Модель редко останавливалась посреди работы, чтобы задать вопрос.
- CodeRabbit — суждение лучше, чем у Sonnet 5, а выходных токенов — кусочков текста, из которых модель собирает ответ, — заметно меньше; привычка лишний раз лезть в интернет-поиск пропала. Простые и средние ревью кода сервис переводит на новую модель уже сейчас, а в ближайшие недели — и другие.
- Epic Games — держала планку модели старшего класса на аудите архитектуры и разборе потоков данных, работала с десятками тысяч строк кода игровых систем, выдерживала многочасовые задачи, и ей хватало менее подробных инструкций.
- Unity — 90% задач многошагового теста по Unity Editor и программированию; большая часть работы прошла проверку запуском, а не на слово модели.
«Думает меньшим числом шагов, и каждый надёжнее — разработчики меньше ждут» — Фабиан Хедин, сооснователь и технический директор Lovable.
Экономия видна и в тестах Anthropic. Во FrontierCode на ступени High модель набирает на 10 пунктов больше, чем Sonnet 5 на той же ступени, примерно за 1/15 стоимости задачи. В Terminal-Bench 4.0 уже на Medium она далеко обходит лучший результат Sonnet 5 меньше чем за десятую часть стоимости. Токен стоит столько же, сколько у Sonnet 5, а у Opus 5.5 — вдвое дороже. В СуперИнтеллекте нейроны списываются по фактическому расходу токенов, так что экономность модели видна и в счёте.
Как работать с кодом в Claude Sonnet 5.5 в СуперИнтеллекте?
Выберите Claude Sonnet 5.5 в чате, приложите код, задайте ступень рассуждений и опишите задачу с рамками — запустить и проверить код модель сможет сама. Нужен тариф СТАРТ или старше; модель работает в России без VPN и зарубежной карты, регистрация бесплатная: my.suin.ai/auth/register.
- Выберите модель. Нажмите кнопку выбора модели в панели ввода и найдите Claude Sonnet 5.5. Если в чате или у ИИ-агента закреплён псевдоним Claude Sonnet Latest (со значком ↻), он уже ведёт на Sonnet 5.5 — подробнее о псевдонимах Latest.
- Приложите код. Файлы, с которыми работаете, логи, схему базы. Контекст модели — объём, который она удерживает в одном разговоре, — 1 000 000 токенов: поместится код небольшого проекта или крупного модуля. Ответ — до 128 000 токенов.
- Задайте ступень. Чип «Модель · Ступень» рядом с кнопкой модели открывает окно «Усилие» со шкалой «Быстрее ↔ Умнее». Выбор запоминается в этом чате.
- Опишите задачу и рамки. Язык и версии, что должно получиться и чего трогать нельзя.
- Попросите проверить. Выполнение кода запускает программу в изолированной среде — песочнице, отдельной от ваших систем: модель может прогнать тесты, воспроизвести ошибку или проверить запрос на тестовых данных.
Работу над одной задачей ведите в одном чате. В нашем замере первый ход в новом чате дороже: платформа передаёт модели описания инструментов, и они записываются в кэш — сохранённое начало запроса. Следующие ходы того же чата обходятся примерно в 10 раз дешевле, потому что почти весь запрос читается из кэша.
Для регулярного ревью удобно настроить ИИ-агента — ассистента с постоянной инструкцией: выберите в его настройках Claude Sonnet 5.5, задайте ступень и впишите правила код-ревью вашей команды.
Какую ступень рассуждений выбрать для задач с кодом?
Чем больше изменение и чем меньше в нём ясности, тем выше ступень, но выше «Ещё глубже» для кода подниматься стоит редко. Ступень определяет, сколько модель думает перед ответом. Режима без рассуждений у Sonnet 5.5 нет, поэтому «Без раздумий» в списке не будет.
| Задача | Ступень в чате | Почему |
|---|---|---|
| Объяснить фрагмент, написать регулярное выражение, мелкая правка | «Быстрее» (Low) или «Обычно» (Medium) | Ответ быстрее и дешевле, долго рассуждать не о чем |
| Ревью изменений, ошибка по логу | «Обычно» (Medium) или «Глубже» (High) | Уже на Medium модель в Terminal-Bench далеко выше лучшего результата Sonnet 5 |
| Тесты, рефакторинг модуля, сложный SQL | «Глубже» (High) | Во FrontierCode на High — на 10 пунктов выше Sonnet 5 на той же ступени |
| Изменения в нескольких файлах, миграция | «Ещё глубже» (Xhigh) | Лучший результат модели во FrontierCode — 52,1% |
| Трудная многошаговая задача | «Максимум» (Max) | Дольше и дороже; во FrontierCode ниже, чем на Xhigh |
Если ответ поверхностный, поднимите ступень на одну и повторите; если хороший — попробуйте ниже: на рутине разница часто незаметна. Подробнее о шкале — в материале о слайдере глубины размышлений.
Как совместить Claude Opus 5.5 и Claude Sonnet 5.5 в одном проекте?
Отдайте Opus 5.5 архитектуру и план, а Sonnet 5.5 — реализацию по этому плану, в одном и том же чате. Модель переключается одним кликом, история сохраняется, поэтому план не нужно копировать. Так связку видят и ранние тестировщики: в Creator сказали, что, когда архитектуру игры задаёт Opus 5.5, реализацию можно уверенно доверить Sonnet 5.5.
- Opus 5.5 — архитектура. Опишите цель и ограничения, приложите код и попросите структуру модулей, план по шагам и риски. Opus 5.5 доступна с тарифа Про.
- Sonnet 5.5 — реализация. Переключите модель в том же чате и давайте шаги плана по одному на ступени «Обычно» или «Глубже»: по данным Anthropic, как дополнение к Opus 5.5 модель выгоднее всего на невысоких ступенях.
- Проверка. Попросите прогнать тесты выполнением кода, а спорные архитектурные решения верните Opus 5.5.
Связка ещё и экономит: токен Opus 5.5 вдвое дороже, а основной объём кода пишется на этапе реализации. Учтите, что у другой модели кэша этого чата ещё нет, и первый ход после переключения обойдётся дороже. Когда какую модель брать, разбираем в материале Sonnet 5.5 или Opus 5.5.
Мешает ли защита по кибербезопасности программировать в Claude Sonnet 5.5?
По данным Anthropic, нет: обычная разработка не затронута, находить и исправлять ошибки в своём коде можно как раньше. Sonnet 5.5 — первая модель Sonnet с защитой по кибербезопасности, как у старших моделей Anthropic: её возможности в этой области заметно выросли по сравнению с Sonnet 5. Защита касается узкого круга рискованных запросов, и такие задачи заметно для пользователя передаются Sonnet 5.
Это штатные меры, которые Anthropic применяет к своим самым способным моделям. В автоматической проверке поведения примерно по 1 850 сценариям Sonnet 5.5 не хуже Sonnet 5 по большинству показателей. В тестах на изоляцию она почти так же редко, как Opus 5.5, пытается выйти из песочницы и реже всех моделей Anthropic прощупывает границы своего контейнера — полезное свойство для модели, которая сама запускает код.
Какие промпты использовать с Claude Sonnet 5.5 для программирования?
Лучше всего работают промпты, где названы язык и версии, приложен код, сказано, что должно получиться и чего трогать нельзя. Рамки особенно важны на высоких ступенях. Ниже семь заготовок — текст в квадратных скобках замените своим.
Ревью изменений — ступень «Глубже»
Проведи ревью изменений как опытный разработчик на [язык / фреймворк].

Контекст: [что делает код и зачем это изменение]
Изменения: [вставьте diff или приложите файлы]

Проверь по порядку:
1. Ошибки логики и граничные случаи.
2. Безопасность: проверку входных данных, права доступа, секреты в коде.
3. Производительность: лишние запросы к базе, тяжёлые циклы.
4. Читаемость и соответствие стилю проекта.

Формат: «файл, строка — проблема — как исправить», по важности: критично / стоит поправить / мелочь. Код целиком не переписывай, правок вне этих изменений не предлагай.
Ошибка по логу — ступень «Глубже»
Помоги найти причину ошибки.

Что ожидалось: [...]
Что происходит: [...]
Лог и стек вызовов: [вставьте или приложите файл]
Код из стека: [приложите файлы]
Окружение: [версии языка, библиотек, ОС]

Сначала назови 2–3 возможные причины и как проверить каждую. Для самой вероятной — минимальное исправление и тест, который воспроизводит ошибку. Если данных в логе мало, скажи, какое логирование добавить.
Рефакторинг модуля — ступень «Глубже»
Отрефактори модуль [имя файла] без изменения поведения.

Цель: [разбить большую функцию / убрать дублирование / отделить логику от работы с базой]

Ограничения:
— публичный интерфейс (имена, параметры, формат ответа) не меняется;
— новых зависимостей не добавляй;
— стиль и соглашения проекта сохрани.

Сначала опиши план в 3–5 шагах и дождись моего «ок». Потом покажи код и объясни, почему поведение осталось прежним.
Тесты к коду — ступень «Глубже»
Напиши тесты для [функция / модуль] на [pytest / Jest / другой фреймворк].

Код: [приложите файл]

Покрой обычные сценарии, граничные значения (пустые данные, ноль, очень большие числа, неверные типы) и ошибки: что должно выбрасываться и с каким сообщением. Внешние сервисы и базу замени заглушками.

Запусти тесты выполнением кода и покажи результат. Если тест падает из-за ошибки в самом коде, не подгоняй тест — опиши ошибку отдельно.
Миграция на новую версию — ступень «Ещё глубже»
Нужно перевести проект с [библиотека, версия] на [библиотека, версия].

Приложены: [файлы, где используется старая версия]

Сделай:
1. Список всех мест, которые затронет переход, и что меняется в каждом.
2. Порядок миграции по шагам — так, чтобы проект собирался после каждого шага.
3. Код изменений для первого шага.
4. Риски и что проверить вручную после перехода.

Меняй только то, чего требует миграция. Попутные улучшения вынеси отдельным списком.
SQL-запрос по схеме — ступень «Обычно»
Напиши SQL-запрос для [PostgreSQL / MySQL / ClickHouse].

Схема: [CREATE TABLE или описание таблиц и связей]
Задача: [например, выручка по месяцам за год в разрезе категорий, только оплаченные заказы]
Объём: [примерное число строк в больших таблицах]

Дай запрос с комментариями, объясни, какие индексы ему нужны, и проверь логику на небольшом наборе тестовых данных выполнением кода. Если условие можно понять двояко, спроси до того, как писать.
Документация к коду — ступень «Обычно»
Напиши документацию к приложенному коду для [новых разработчиков / пользователей библиотеки].

Нужно:
1. README: что делает проект, как установить и запустить, переменные окружения, пример использования.
2. Комментарии к публичным функциям в формате [docstring / JSDoc]: параметры, результат, ошибки.
3. Раздел «Как устроено»: основные модули и связи между ними.

Пиши только то, что следует из кода. Если назначение чего-то неясно, пометь «уточнить», а не придумывай.
Частые вопросы
Какой тариф нужен для Claude Sonnet 5.5 в СуперИнтеллекте?
Тариф СТАРТ или старше: Про, ULTRA или командный. На бесплатном тарифе Sonnet 5.5 нет — там доступны GPT-6 Luna и Gemini 3.8 Flash.
Что лучше для кода: Claude Sonnet 5.5 или Opus 5.5?
Для исправления ошибок, ревью и реализации по плану — Sonnet 5.5: она быстрее и вдвое дешевле за токен, в Terminal-Bench 4.0 выше, а во FrontierCode и CursorBench уступает всего 2,3 пункта. Для сложной открытой работы, где нужно долго держать суждение, Anthropic называет Opus 5.5 заметно сильнее — ей разумно отдавать архитектуру.
Может ли Claude Sonnet 5.5 сама запускать код?
Да. В СуперИнтеллекте модель вызывает выполнение кода: программа запускается в изолированной песочнице, где можно прогнать тесты, воспроизвести ошибку или проверить расчёт.
Сколько кода можно отправить Claude Sonnet 5.5 за раз?
Контекст модели — 1 000 000 токенов, ответ — до 128 000 токенов. Прикладывайте файлы, которые относятся к задаче: так модель быстрее разберётся и потратит меньше токенов.
Claude Sonnet 5.5 в СуперИнтеллекте — это Claude Code?
Нет. Claude Code — отдельный продукт Anthropic, в платформу он не входит. В СуперИнтеллекте Claude Sonnet 5.5 работает в чате: с файлами, выполнением кода и ИИ-агентами.